

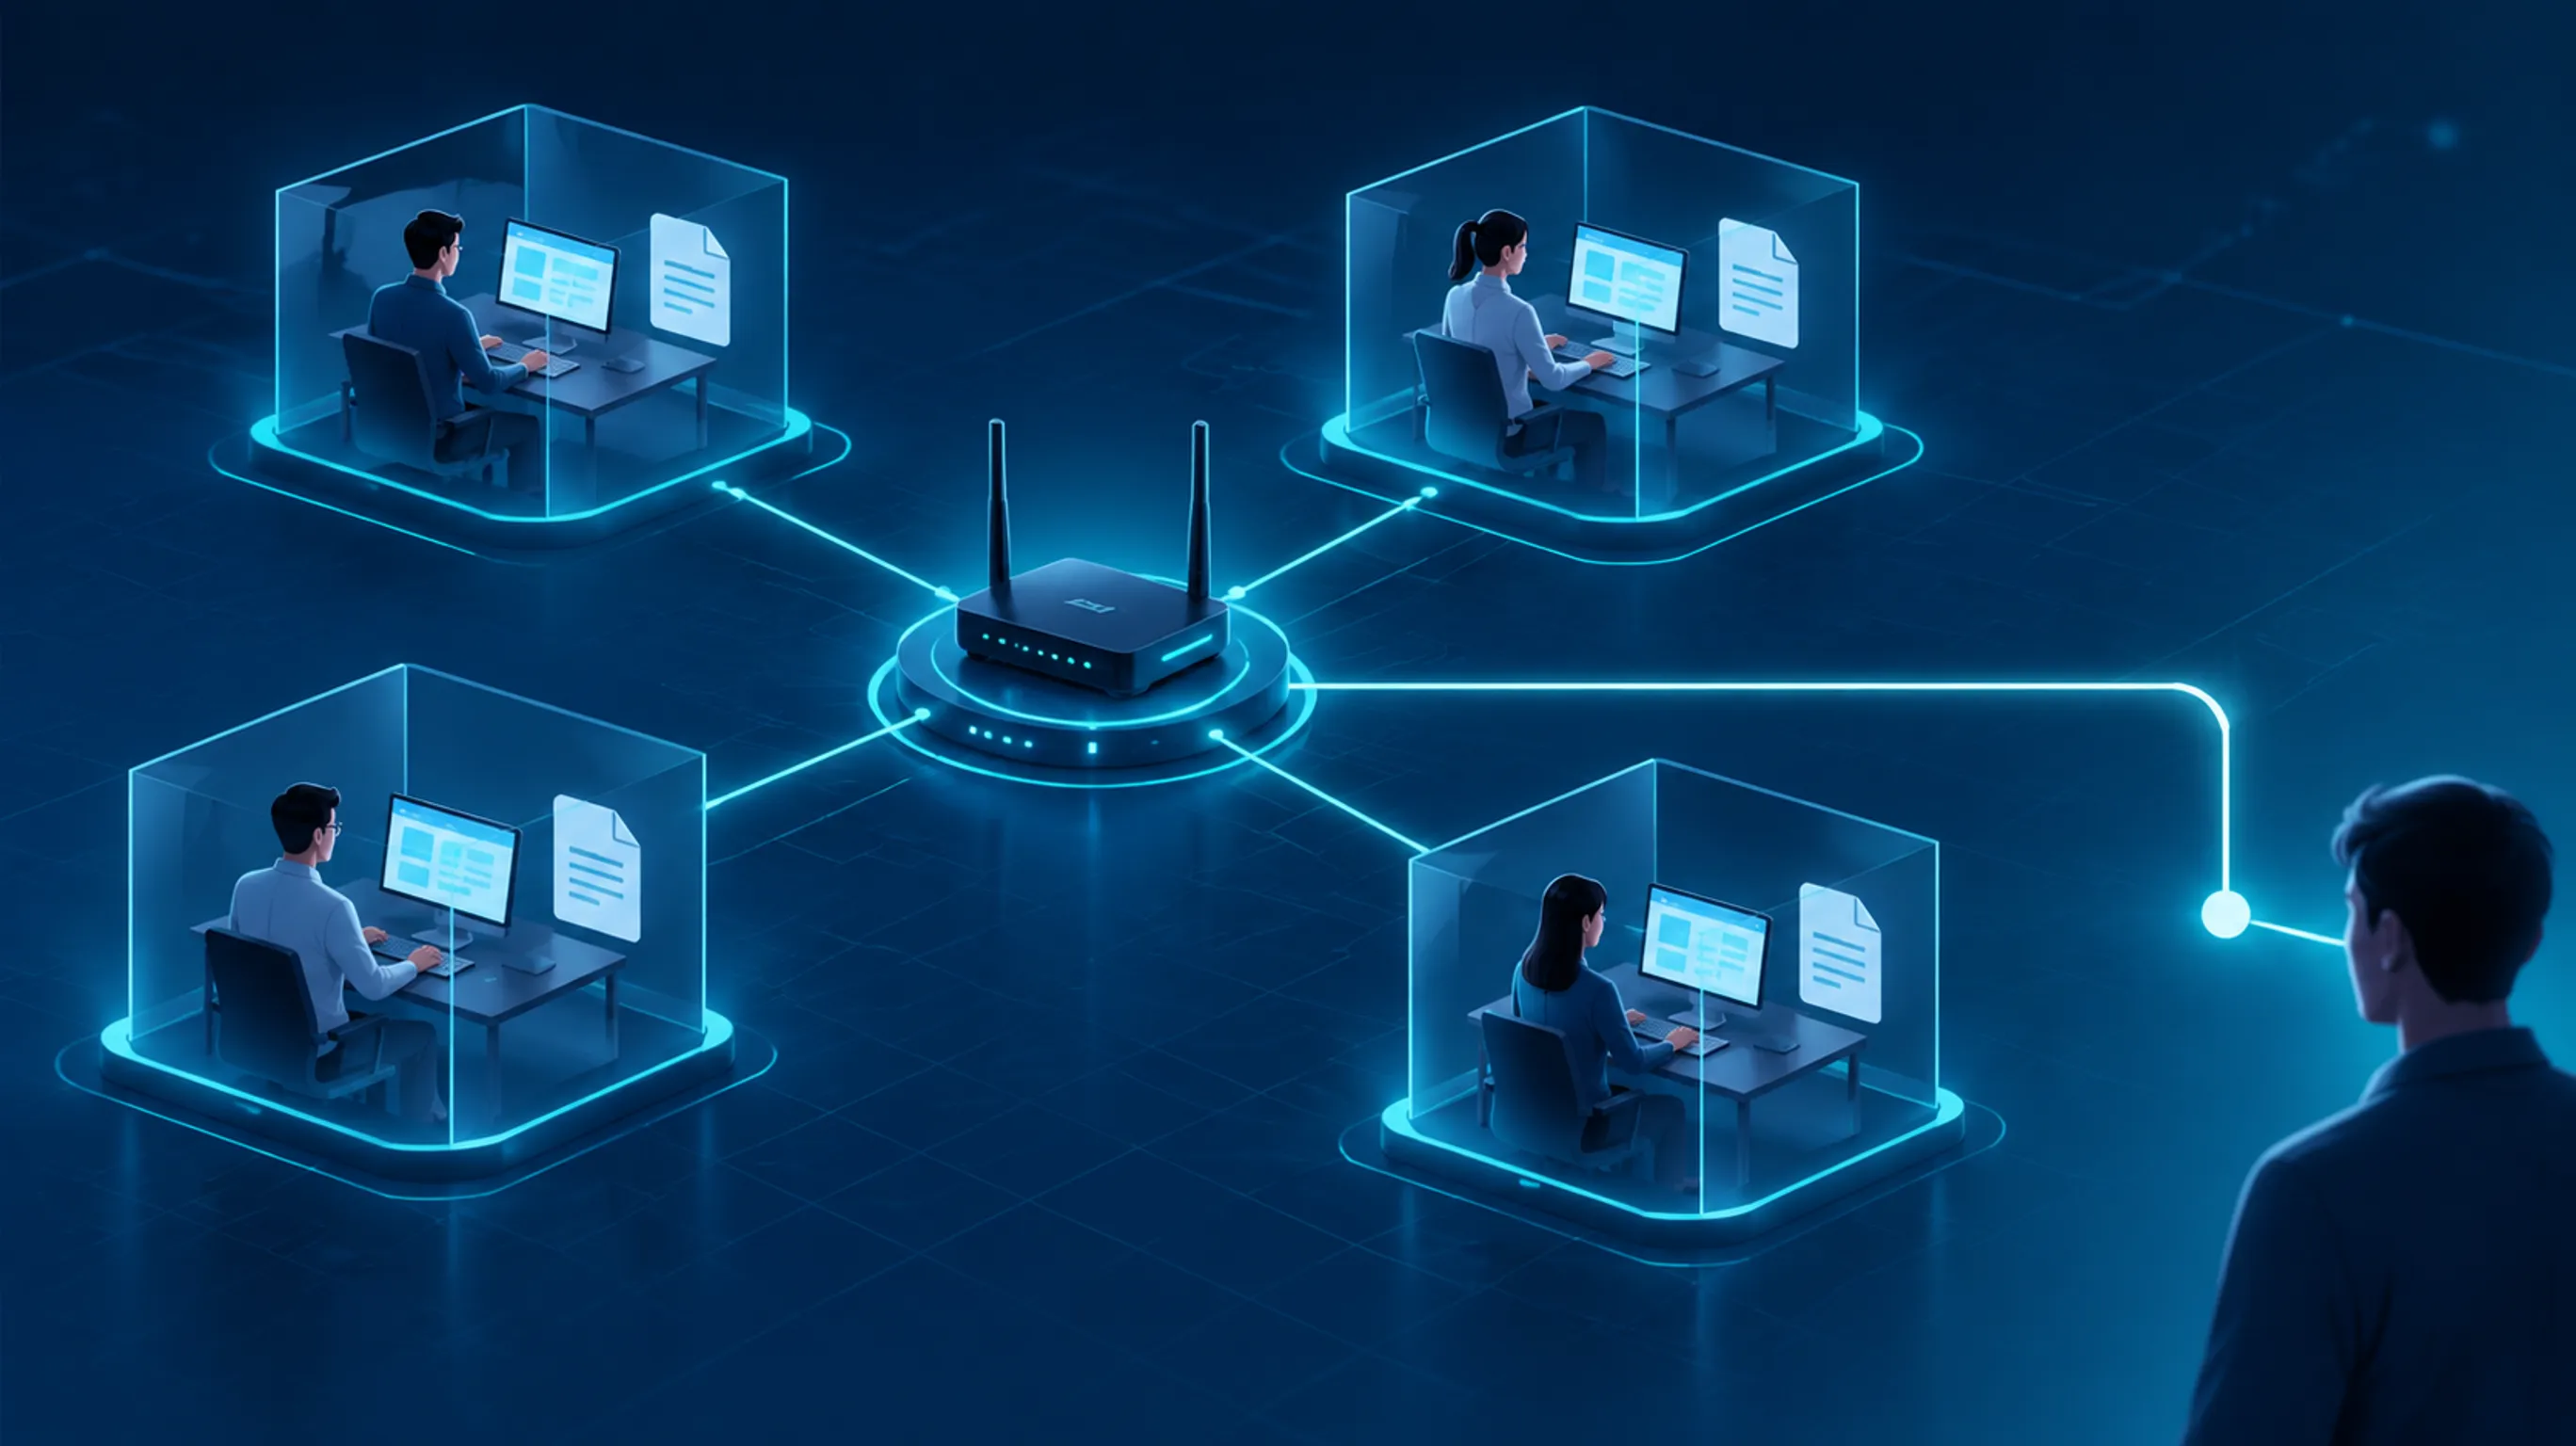
Ein Router führt das Gespräch, mehrere Worker erledigen die Arbeit. DeepSeek hat dieses Muster für programmierende Agenten als offenen Forschungsprototyp veröffentlicht. Die wichtigste Entscheidung darin ist keine technische.
Was DeepSeek am 31. Oktober veröffentlicht hat
Am 31. Oktober 2026 hat das Runtime-Team von DeepSeek das Repository dsh-superagent-prototype auf GitHub gestellt. Es steht unter MIT-Lizenz und darf damit auch kommerziell weiterverwendet werden. Zeitgleich erschien ein Architekturaufsatz mit dem Titel „Exploring Super-agent Design: Towards a More Autonomous Agent System“.
Der Prototyp ist kein neues Modell, sondern die Software um das Modell herum, die festlegt, wann es arbeitet, wer ihm Aufträge gibt und wo die Ergebnisse landen; DeepSeek liefert ihn als Bündel für die eigene Agent-Runtime aus, die im Haus kurz dsh genannt wird.
Der Einsatzbereich ist eng umrissen. Es geht um ein einziges GitHub-Repository. Darin soll der Agent nicht auf Zuruf reagieren, sondern selbst merken, wann Arbeit anfällt. In der Branche heißt so etwas proaktiver Coding-Agent.
Wer bisher mit Claude Code oder Codex gearbeitet hat, kennt das andere Muster: Man öffnet eine Sitzung, tippt eine Aufgabe und schaut zu, während der Super-Agent-Prototyp genau das umdreht und nicht auf die Eingabe wartet, sondern auf ein Ereignis.
Router und Worker: die zwei Ebenen
Die Architektur besteht aus zwei Rollen, und der Unterschied zwischen ihnen ist der eigentliche Kern.
Der Router ist dauerhaft da, führt das Gespräch mit den Menschen, hält den Überblick über das gesamte Repository und verteilt Aufgaben, ohne selbst Arbeit zu erledigen. Er ist eine Vermittlungsstelle mit Gedächtnis.
Die Worker sind Wegwerf-Sitzungen. Jeder bekommt einen Arbeitsauftrag, einen eigenen Gesprächsverlauf und ein eigenes Arbeitsverzeichnis, und mehrere von ihnen laufen parallel, ohne dass ihre Kontexte sich vermischen. Ein Worker kann außerdem Kommentare unter dem späteren Pull Request abonnieren und auf Rückfragen reagieren.
Diese Trennung löst ein Problem, das jede lange Agentensitzung kennt. Je mehr ein Modell in einem Gespräch mitschleppt, desto schwerer fällt ihm die Konzentration auf die aktuelle Aufgabe. Der Router trägt den Überblick, die Worker tragen nur ihr eigenes Stück.
Vom GitHub-Ereignis zum Pull Request des Agenten
Im Betrieb hängt der Prototyp an Ereignissen aus dem Repository, und optional lässt sich eine Feishu-Anbindung dazuschalten, über die Anfragen auch aus dem Chat kommen.
Der Ablauf ist unspektakulär, und das ist Absicht. Eine Person mit den nötigen Rechten äußert einen Wunsch, etwa in einem Issue oder in einer Diskussion, und der Router legt daraus einen Arbeitsauftrag an, den ein Worker übernimmt. Der arbeitet in seiner eigenen Sitzung und antwortet dort, wo die Frage gestellt wurde. In den meisten Fällen bedeutet diese Antwort: ein Pull Request.
Dazu kommt ein Web-Panel. Es zeigt nicht, was der Agent gerade tut, sondern was auf einen Menschen wartet. Diese Unterscheidung zieht sich durch das ganze Projekt.
Das Aufmerksamkeitsbudget
Im Repository steht ein Satz, der die Denkweise gut zusammenfasst: so wenig Aufmerksamkeit wie möglich binden, so viel Wert wie möglich schaffen.
Dahinter steckt eine simple Beobachtung. Ein Agent, der für ein ganzes Team arbeitet, kann auch allen die Zeit stehlen. Jede Meldung, jede Rückfrage, jeder Zwischenstand kostet jemanden ein paar Sekunden. Bei zwanzig Vorgängen am Tag summiert sich das.
Deshalb sind im Prototyp zwei Bremsen eingebaut. Er handelt nur, wenn er darum gebeten wurde oder wenn die Regeln des Teams es vorsehen. Und er meldet sich nur, wenn ein Mensch etwas entscheiden muss oder wenn das Ergebnis wirklich gebraucht wird.
Was bringt eine solche Bremse? Sie hält den Agenten davon ab, aus Eigeninitiative Arbeit zu erzeugen, die niemand eingeplant hat. Ein Bericht über jeden Zwischenschritt klingt nach Transparenz und ist in der Praxis eine zusätzliche Aufgabe für die Person, die ihn lesen soll.
Für die Frage „Was kann das, was mein Agent nicht kann?“ ist das die ehrlichste Antwort. Der Unterschied liegt nicht in einem größeren Modell. Er liegt darin, dass Interaktion und Ausführung getrennt sind.
Was der Prototyp ausdrücklich nicht ist
Die README nimmt viel Wind aus den Segeln, und zwar mit gutem Grund. Dort steht, dass es sich um einen Forschungsprototyp handelt, der nur der Anschauung dient, nicht um ein offizielles Produkt von DeepSeek.
Weiter heißt es: kein produktionsreifer Code, Fehler möglich, Programmierstil und Engineering-Praxis nicht durchgehend einheitlich. Für die Veröffentlichung wurde der Code angepasst, und die Umsetzung weicht in Details sowohl von der internen Version als auch von dem ab, was der Aufsatz beschreibt, sodass manche Ideen daraus bis heute nur auf dem Papier stehen.
Wer den Prototyp als Produktversprechen liest, wird enttäuscht. Wer ihn als Bauplan liest, bekommt genau das, was draufsteht.
Wie man den Prototyp ausprobiert
Das Setup ist bewusst schlicht gehalten. Im Repository liegen eine Anleitung SETUP.md und neun nummerierte Dokumente von 000 bis 008: Philosophie, Domänenmodell, Berechtigungen, Ausführung, Prompts, Panel, Betrieb, Architektur und ein Kochbuch zum Anbinden weiterer Quellen.
Installiert wird nicht per Skript, sondern im Gespräch. Man setzt den eigenen Coding-Agenten auf SETUP.md an, der jeweils eine kurze Frage stellt, die Antwort abwartet und sich so durch die Kapitel arbeitet. Am Ende steht ein vollständiger Plan, den man prüfen kann, bevor irgendetwas läuft.
Das ist ungewöhnlich. Es passt aber zu einem Projekt, dessen Zielgruppe ohnehin einen Agenten laufen hat.
Wie die Community auf den DeepSeek-Prototyp reagiert hat
Innerhalb eines Tages wurde der Prototyp in chinesischen und englischen KI-Communitys breit diskutiert, wobei die häufigste Lesart eine architektonische Antwort auf die geschlossenen Coding-Agenten von Anthropic und OpenAI war.
Belegen lässt sich das nicht, und DeepSeek hat es auch nicht so formuliert. Auffällig ist trotzdem, dass ein Repository in dieser Geschwindigkeit die Runde macht, obwohl es weder Ankündigung noch Demo noch Marketing gab. Offenbar gibt es Bedarf an einem offenen Gegenentwurf.
Zahlen zu Sternen oder Forks taugen dafür nicht als Maßstab, weil sie je nach Abfragezeitpunkt auseinanderlaufen und die Anbieter unterschiedlich zählen, ohne dass eine dieser Zahlen etwas über die Qualität aussagt.
Was der Prototyp zeigt, ist eine Haltung: Ein Agent muss nicht alles in einer Sitzung erledigen, er kann Anfragen annehmen, sie weggeben und sich nur dann melden, wenn es sich lohnt. Ob sich das Muster durchsetzt, entscheidet sich daran, ob Teams die Regelarbeit dahinter akzeptieren, und nicht an der Zahl der Sterne auf GitHub.



