Andrej Karpathy beschreibt den Wissensabstand über KI-Modelle nicht mehr als zwei Gruppen, die aneinander vorbeireden, sondern als steilen Trichter. Sein Rechenbeispiel zeigt, wie wenige Menschen überhaupt in Kontakt mit den stärksten Modellen gekommen sind.
Karpathys Bild: vom Nebeneinander zum Trichter
Andrej Karpathy, Mitgründer von OpenAI und früherer Leiter der KI-Abteilung bei Tesla, hat am elften Oktober einen alten Beitrag wieder hervorgeholt. Im April hatte er von einem Riss im gemeinsamen Verständnis von KI-Modellen geschrieben. Jetzt sagt er: Dieser Riss wächst, und die Form hat sich verändert.
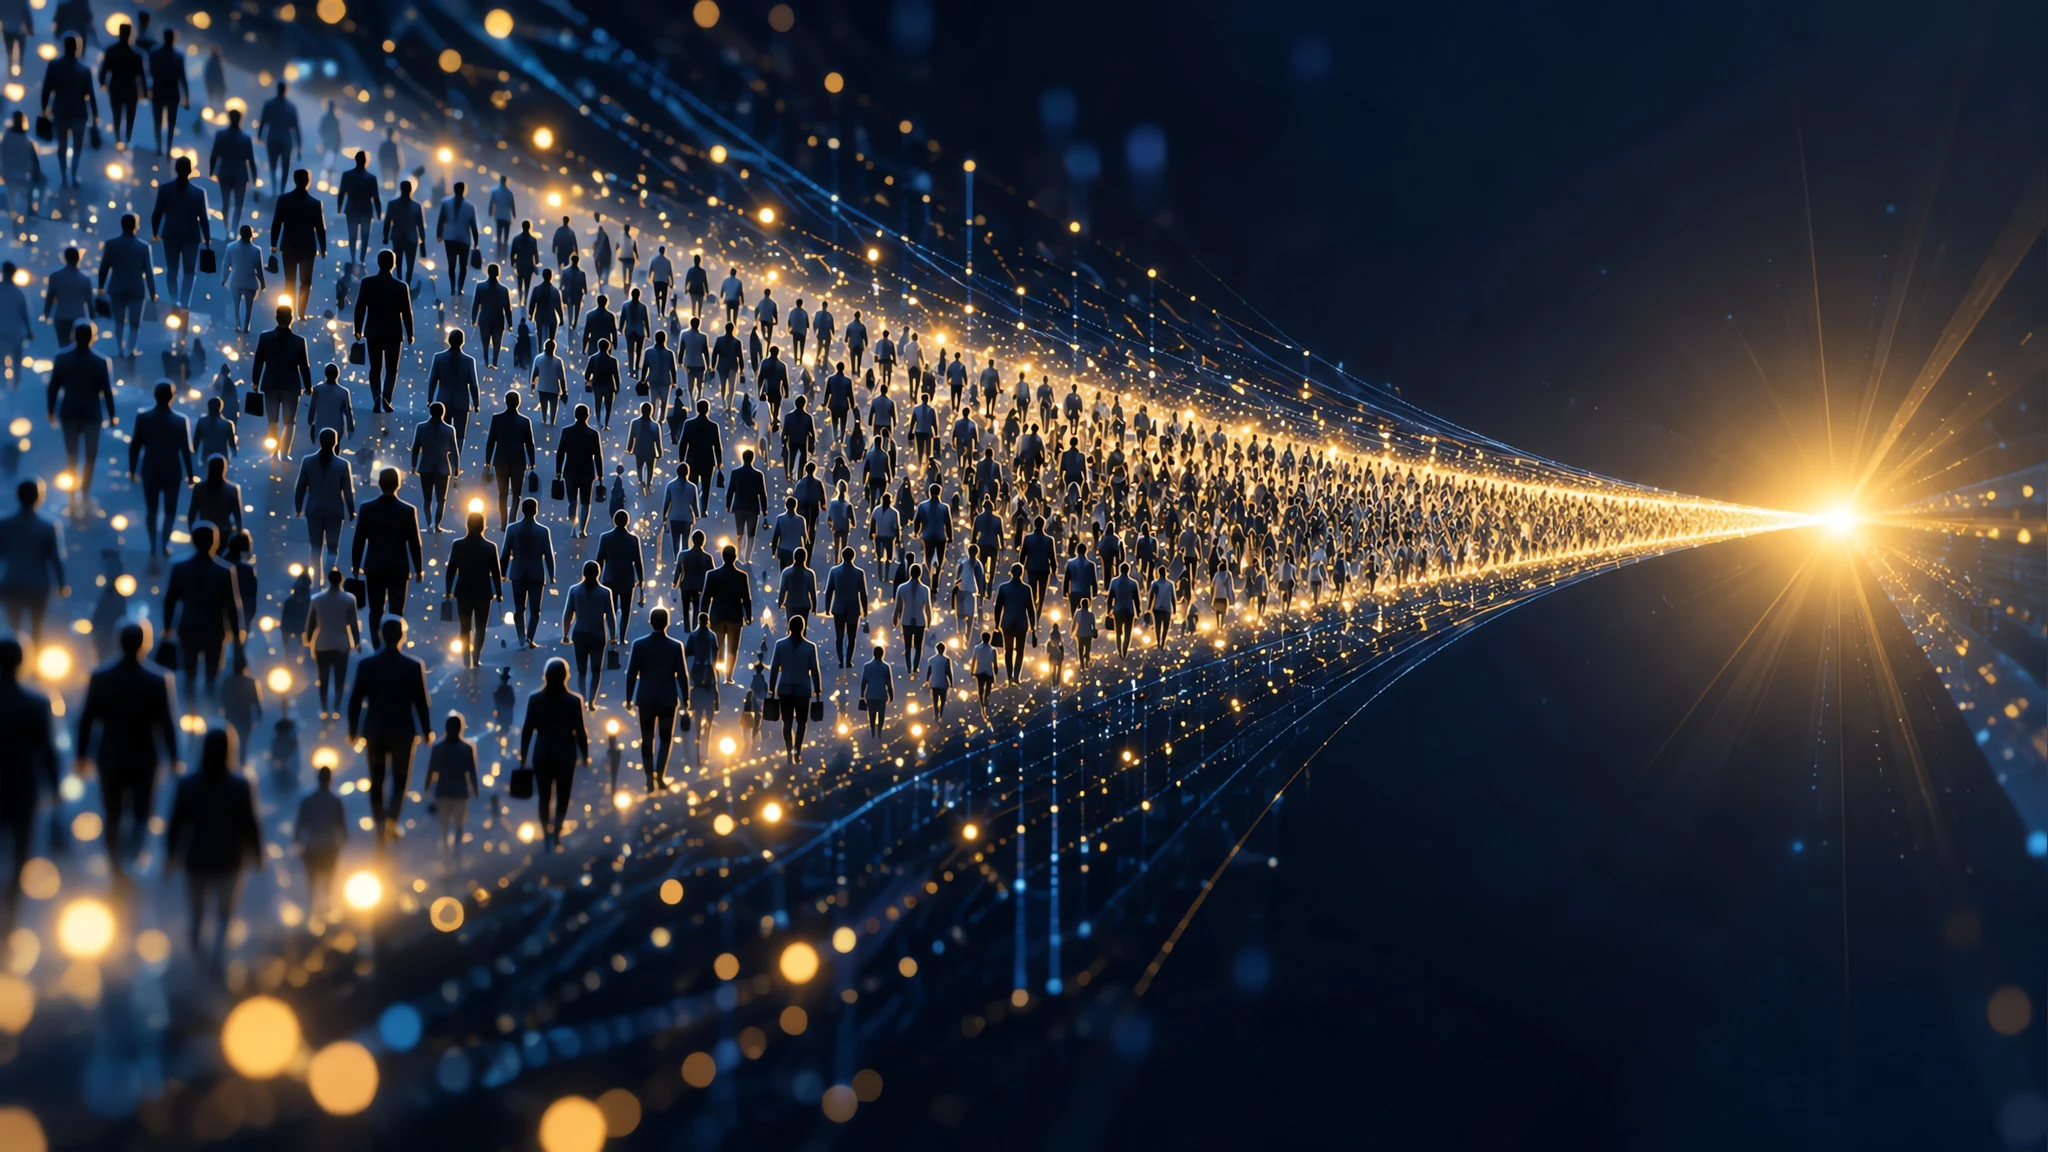
Früher, so sein Vergleich, redeten zwei Gruppen aneinander vorbei. Die einen erzählten von beeindruckenden Ergebnissen, die anderen hielten das alles für Hype. Inzwischen ähnelt das Bild einem scharfen Trichter, der oben weit geöffnet ist und sich nach unten hin zu einem schmalen Ausguss zusammenzieht, durch den nur noch ein dünner Strahl passt. Wenige stehen an der breiten Öffnung und arbeiten täglich mit den stärksten Systemen. Die große Mehrheit sitzt am engen Ausgang und hat mit diesen Systemen kaum Berührung.
Das ist keine Messung, sondern eine Einschätzung. Karpathy selbst nennt seine Zahlen „Napkin Math“, also eine Überschlagsrechnung auf dem Bierdeckel. Lesen Sie sie als Versuch, Größenordnungen sichtbar zu machen, nicht als Statistik.
Die Zahlen hinter dem Trichter
Karpathys Überschlag ordnet die Weltbevölkerung grob in Stufen. Rund sechs Milliarden Menschen, etwa 75 Prozent, hätten die starken Sprachmodelle kaum je benutzt. Etwa ein bis zwei Milliarden, also ungefähr 20 Prozent, nutzen kostenlose Chatbots gelegentlich. Etwa 20 Millionen setzen Spitzenmodelle beruflich ein.
Am schmalsten Punkt stehen nach seiner Schätzung rund 5.000 Menschen, die Zugang zu den internen, noch nicht veröffentlichten Modellen der führenden Labore haben. Zwischen dieser Spitze und dem breiten Fuß liegt der eigentliche Kern seiner Beobachtung: Die Kluft verläuft nicht gleichmäßig, sie zieht sich wie ein Gebirge nach oben zusammen.
Wer diese Verteilung einmal sieht, versteht, warum Gespräche über KI so oft schiefgehen. Zwei Menschen können dasselbe Wort meinen und doch völlig unterschiedliche Maschinen vor Augen haben, und keiner von beiden merkt es, weil jeder annimmt, der andere meine genau dasselbe wie er selbst. Genau daraus entsteht der Eindruck, der Gegenüber rede Unsinn.
Warum die Lücke wächst statt zu schrumpfen
Man könnte annehmen, KI werde mit der Zeit gerechter verteilt. Karpathy sieht das anders. Die Modelle verbessern sich schneller, als sie sich verbreiten. Wer schon an der Spitze arbeitet, bekommt jeden neuen Sprung sofort mit. Wer nicht dabei ist, merkt von denselben Fortschritten kaum etwas.
Das führt zu einer seltsamen Situation. Dieselbe Technik, die in einem Büro Aufgaben in Minuten erledigt, bleibt zwei Straßen weiter praktisch unsichtbar. Kein Wunder. Die Wahrnehmungslücke ist also nicht nur ein Wissensdefizit, sondern eine Folge davon, wie schnell die Spitze sich bewegt.
Diese Dynamik erklärt auch die Reaktionen im Netz. Auf Hacker News löste der Beitrag eine lebhafte Diskussion aus, mehrere Branchenkenner griffen ihn auf. Auffällig war, wie viele Zuschauer genau das beschrieben, was Karpathy meinte: ein Alltag, in dem Kollegen dieselben Werkzeuge völlig unterschiedlich einschätzen.
Was das für den Umgang mit KI bedeutet
Für Sie als Leser hat der Trichter eine praktische Folge. Wenn Sie sich über KI informieren, lohnt es sich zu fragen, aus welcher Stufe die Quelle spricht. Ein Blogbeitrag aus der Spitze beschreibt eine andere Realität als der Erfahrungsbericht einer Person, die gerade erst mit einem kostenlosen Chatbot angefangen hat.
Die zweite Folge betrifft Erwartungen. Wer sich an Höchstleistungen gewöhnt hat, die nur wenige erreichen, hält den Durchschnitt für einen Rückschritt. Wer umgekehrt den Durchschnitt kennt, unterschätzt, was an der Spitze möglich ist. Beide Blickwinkel sind echt, sie gehören nur zu unterschiedlichen Punkten im Trichter.
Interessant ist auch, was das für den Arbeitsmarkt heißt. Wenn die Fähigkeiten der Modelle sich ungleich verteilen, verteilen sich auch die Vorteile ungleich. Nicht jeder Arbeitsplatz wird gleich stark von KI verändert, und das liegt nicht nur an der Branche, sondern daran, wer tatsächlich mit den starken Systemen arbeitet.
Was von dem Post bleibt
Karpathy liefert keine Lösung, sondern eine Landkarte. Sein Beitrag erinnert daran, dass die Debatte über KI oft an der falschen Stelle geführt wird: nicht zwischen Befürwortern und Skeptikern, sondern zwischen Menschen, die sehr unterschiedliche Modelle vor Augen haben.
Wichtig ist die Einordnung. Die Zahlen sind geschätzt, die Grenzen zwischen den Stufen fließend, und der Zugang zu internen Modellen ändert sich schnell. Karpathys Punkt hält trotzdem: Solange sich die Spitze schneller bewegt als die Basis, wächst die Wahrnehmungslücke weiter. Wer die Debatte verstehen will, sollte diesen Trichter im Kopf behalten, statt über ein angeblich einheitliches Publikum zu reden, das es nicht gibt.