Liquid AI hat zwei offene Entscheidungsmodelle veröffentlicht, die in einem einzigen Durchlauf antworten statt Text zu schreiben. d1-3B und d1-omni-600M richten sich an Geräte, die eine schnelle Antwort brauchen, keinen Absatz.
Liquid AI hat am 7. Oktober zwei Entscheidungsmodelle mit offenen Gewichten veröffentlicht: d1-3B, das Text und Bilder liest, und das experimentelle d1-omni-600M, das Text zusammen mit einem Bild oder einem Audioclip verarbeitet. Beide lassen sich herunterladen, die Gewichte liegen auf Hugging Face. Das Interessante ist nicht die Größe. Es ist die Tatsache, dass diese Modelle nichts schreiben.
Was ein Entscheidungsmodell ist und was nicht
Die meisten KI-Modelle, die man kennt, sind generativ. Man stellt eine Frage, und das Modell schreibt eine Antwort, Wort für Wort, genauer Token für Token. Das ist flexibel, aber auch langsam und teuer, weil jeder Token ein eigener Schritt ist.
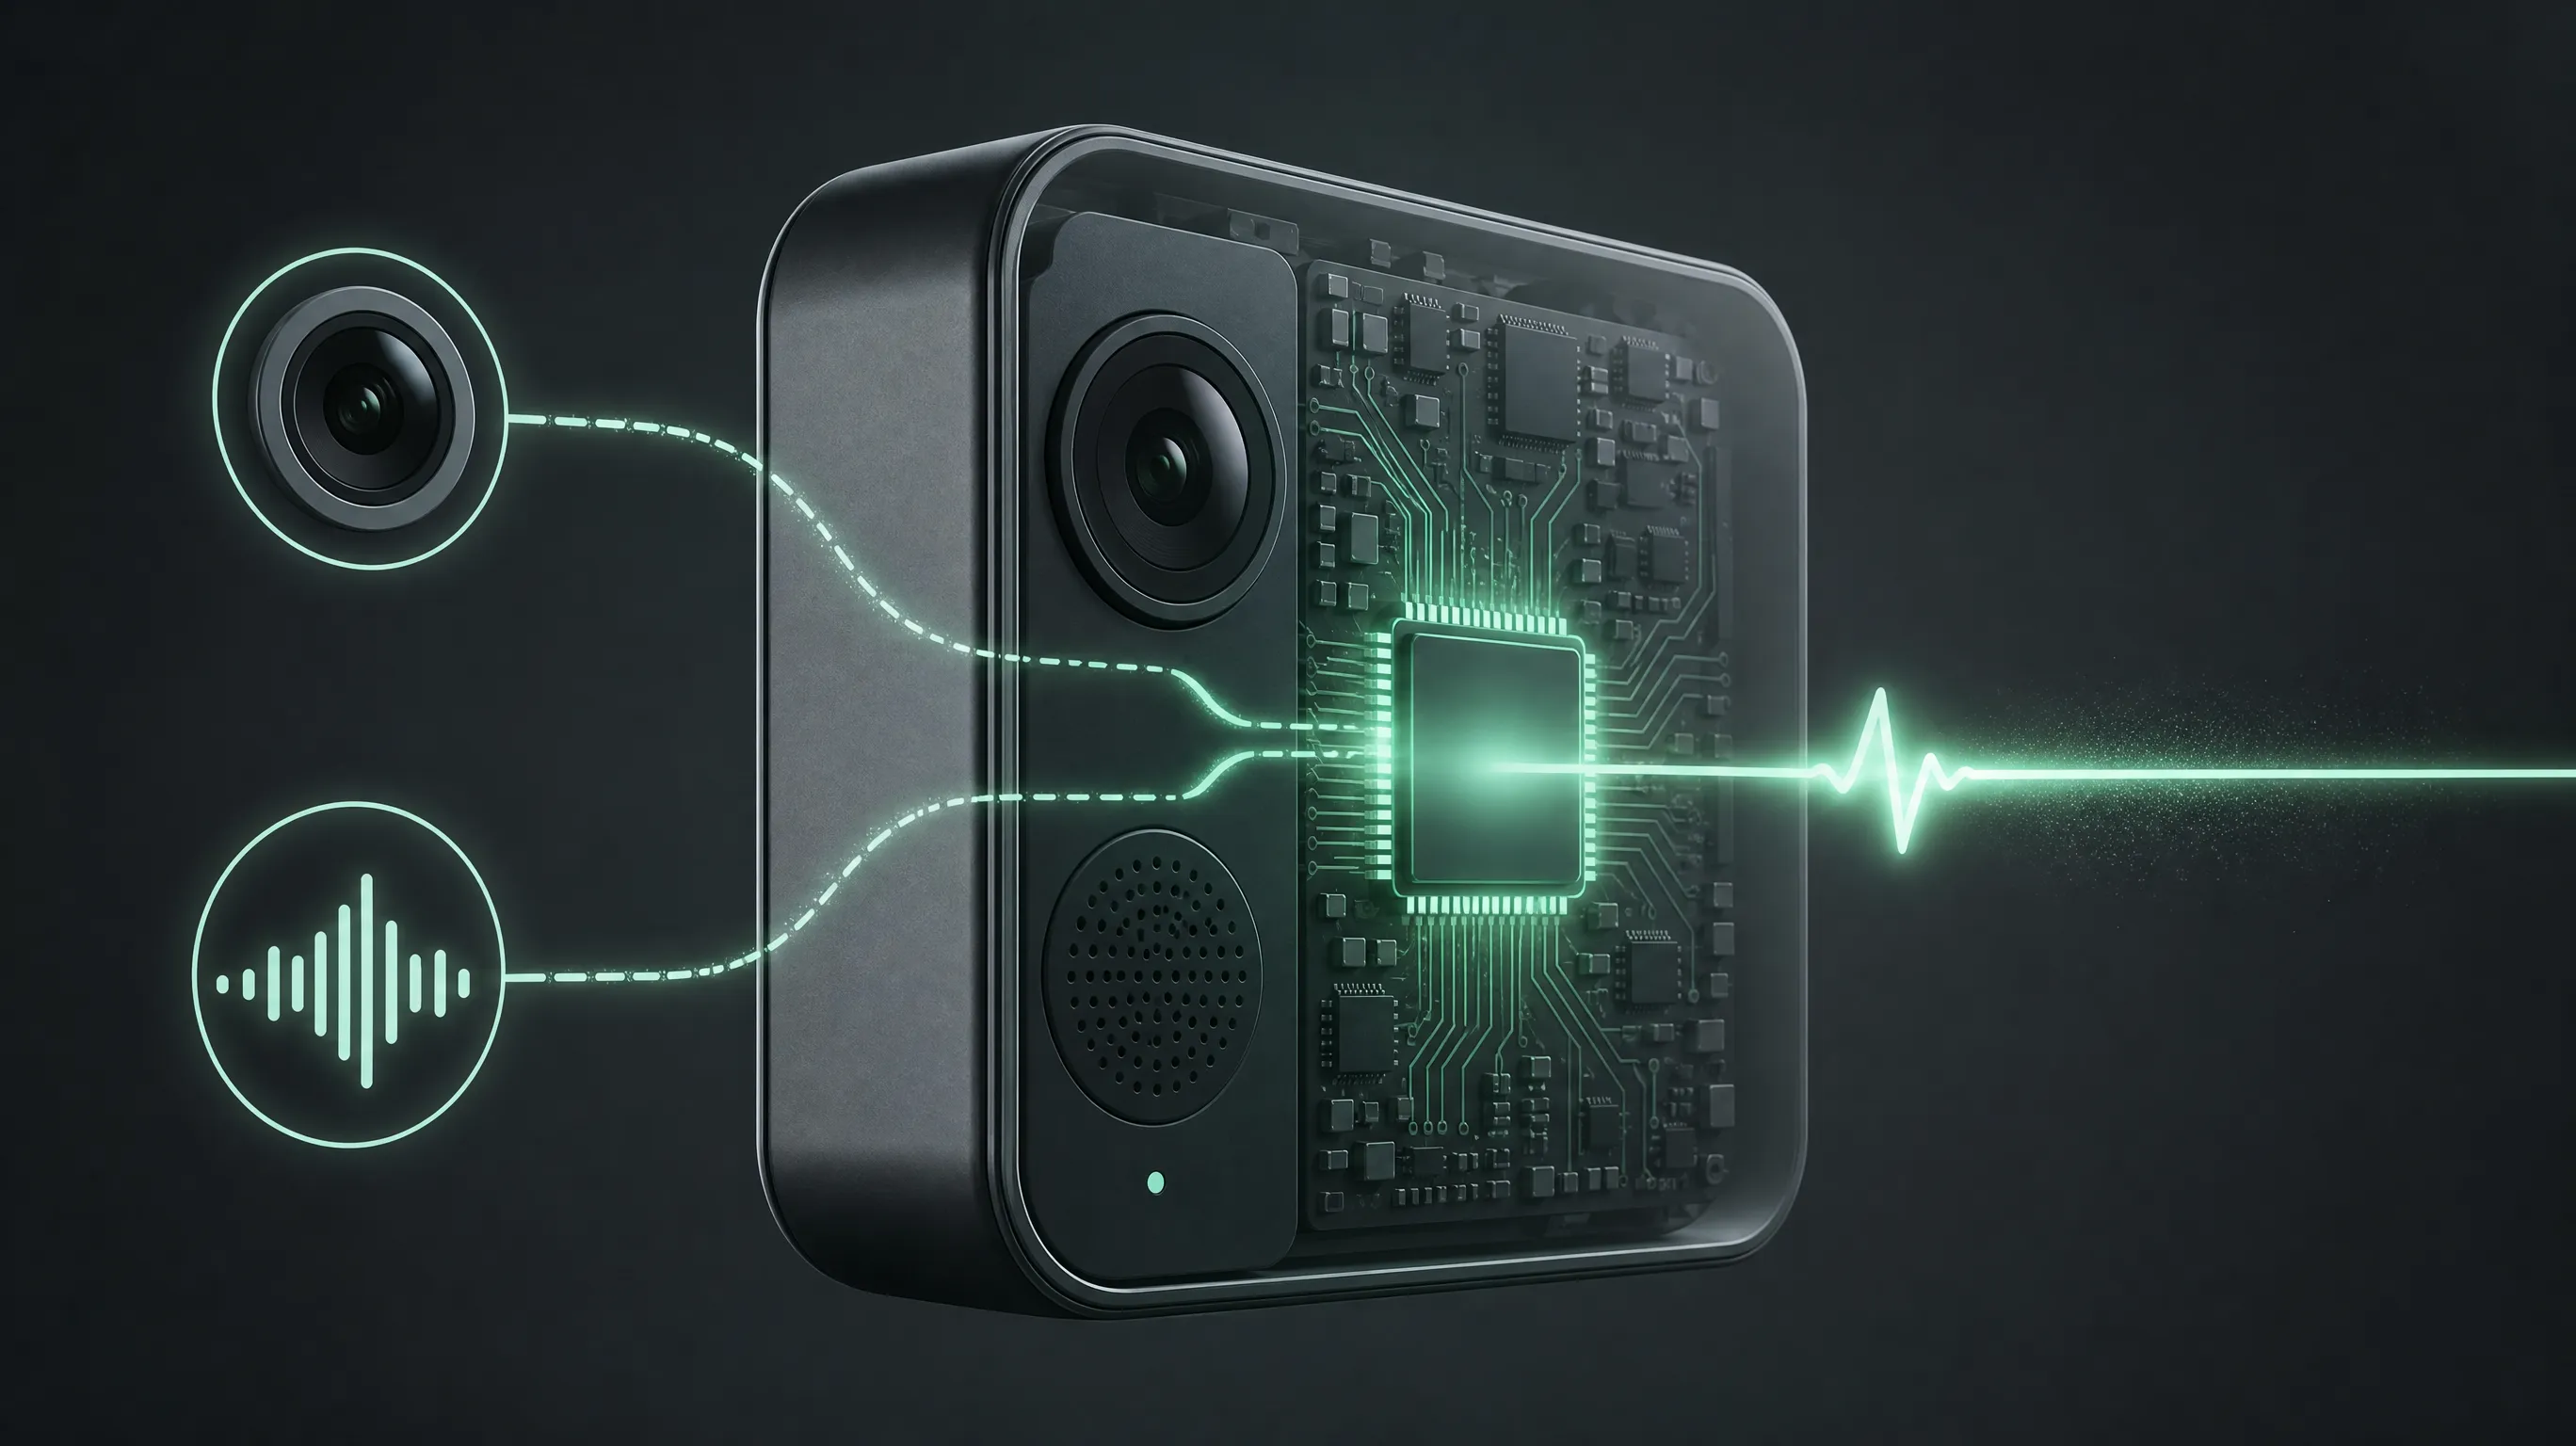
Ein Entscheidungsmodell arbeitet anders. Statt Text zu erzeugen, nimmt es eine Lage und eine Reihe benannter Fragen entgegen und gibt typisierte Antworten in einem einzigen Vorwärtsdurchlauf zurück. Das heißt: Das Modell verarbeitet die Eingabe einmal und liefert seine Ausgabe, ohne unterwegs Token zu erzeugen. Bittet man es, eine Reihe von Optionen zu bewerten oder ein Bild zu verschlagworten, gibt es keine Prosa zu lesen. Nur die Antwort.
Damit eignen sich solche Modelle für Aufgaben, bei denen man keine Erklärung braucht, sondern eine Entscheidung. Ob eine Anfrage genehmigt werden soll, in welche Kategorie ein Foto fällt, was in einem Clip steckt. Liquid AI baute d1-3B auf seinem Modell LFM2.5-VL-3B auf und d1-omni-600M auf LFM2.5-Encoder-350M plus Bild- und Audiokodierern.
Ein Textmodell erklärt, was es tut, und das lässt sich prüfen. Ein Entscheidungsmodell liefert nur das Ergebnis. Das ist effizient, verlangt aber eine umgebende Software, die bewertet, ob die Entscheidung stimmte.
Die Zahlen, die Liquid AI selbst nennt
Das Unternehmen gibt an, d1-3B habe auf dem Decision Index v0.2.1 (öffentlicher Split) einen Wert von 48,57 erreicht. Das sei höher als bei jedem Modell unter 10 Milliarden Parametern und gleichauf mit Decider 35B-A3B, einem Modell von etwa zwölffacher Größe. Es sind die eigenen Zahlen von Liquid AI, genannt zusammen mit der Veröffentlichung, und sie sind nicht unabhängig geprüft.
Die Latenzwerte sind das konkretere Verkaufsargument. Laut dem Unternehmen antwortet d1-3B in 8 Millisekunden auf einer Desktop-GPU RTX 4090, in 16 ms auf einem Jetson AGX Thor, in 26 ms auf einem Jetson AGX Orin und in 50 ms auf dem kleineren Jetson Orin Nano. Das experimentelle d1-omni-600M erreichte auf demselben Index 15,95, laut dem Unternehmen ein erster experimenteller Checkpoint.
Diese Zahlen zielen auf einen bestimmten Einsatzort: Geräte am Rand des Netzes, also Hardware, die vor Ort rechnet, statt Daten an ein Rechenzentrum zu schicken. Die Millisekunden zählen dort, wo ein System sofort reagieren muss. Eine Kamera, die erkennt, ob eine Person einen Helm trägt. Ein Sensor, der ein Geräusch einordnet. Wenn die Antwort in wenigen Millisekunden vorliegt, kann sie in einen laufenden Ablauf eingreifen, ohne ihn zu verzögern.
Was das für den Edge-Bereich bedeutet
Der Schritt reiht sich in eine Entwicklung ein, die seit einiger Zeit läuft. Modelle werden kleiner und laufen zunehmend auf Geräten in der Nähe des Nutzers statt in großen Rechenzentren. Für Anwendungen, bei denen Daten das Gerät nicht verlassen sollen, ist das wichtig. Eine Überwachungskamera, die ihre Bilder an einen entfernten Server schickt, wirft Fragen auf, die eine Kamera mit eigenem Modell nicht aufwirft.
Die offenen Gewichte sind der zweite Teil der Botschaft. Wer d1-3B herunterlädt, kann es auf eigener Hardware betreiben, ohne pro Abfrage zu zahlen. Das senkt die laufenden Kosten für Firmen, die viele kleine Entscheidungen brauchen. Es bindet sie aber auch an einen bestimmten Anbieter, wenn sie das Modell weiter optimieren wollen.
Ob die Entscheidungsmodelle halten, was Liquid AI verspricht, lässt sich erst beurteilen, wenn mehr Nutzer sie außerhalb der vom Hersteller gewählten Tests betreiben. Woran zeigt sich das? An der Genauigkeit in echten Abläufen, nicht an der Punktzahl auf einem Index, den die Firma selbst heranzieht.
Wofür sich der Blick lohnt
Wer KI in Produkte einbaut, die auf Geräten laufen, sollte die beiden Modelle als Option prüfen, besonders dort, wo Text zu erzeugen bisher zu langsam oder zu teuer war. d1-3B und d1-omni-600M sind auf Hugging Face verfügbar, die Dokumentation liegt auf docs.liquid.ai. Für Anwendungen ohne Erklärungsbedarf, also Klassifikation, Bewertung und Auswahl, ist das ein Ansatz, den man testen kann.
Für die meisten Leser bleibt es eine Randnotiz. Spannend wird die Entwicklung dort, wo Geräte Entscheidungen selbst treffen, ohne zu einem Server zu funken. Genau in diese Richtung zielt Liquid AI, und die Frage ist, ob andere Anbieter mit vergleichbaren Modellen nachziehen.