

Agentmemory
rohitg00 · Coding
Agentmemory ist eine local-first Memory-Runtime, die Ihrem KI-Coding-Agenten ein Gedächtnis gibt, das das Ende einer Sitzung überlebt. Es ist persistentes Gedächtnis für Coding-Agenten, nur ohne Cloud. Sie erfasst über Hooks, was der Agent tut, destilliert rohe Protokolle zu dauerhaften Erinnerungen und ruft den passenden Kontext in Millisekunden ab. Alles läuft auf Ihrer Maschine. Keine externe Datenbank, kein Vektorspeicher und keine Warteschlange steht zwischen Ihrem Code und dem Agenten, der daran arbeitet.
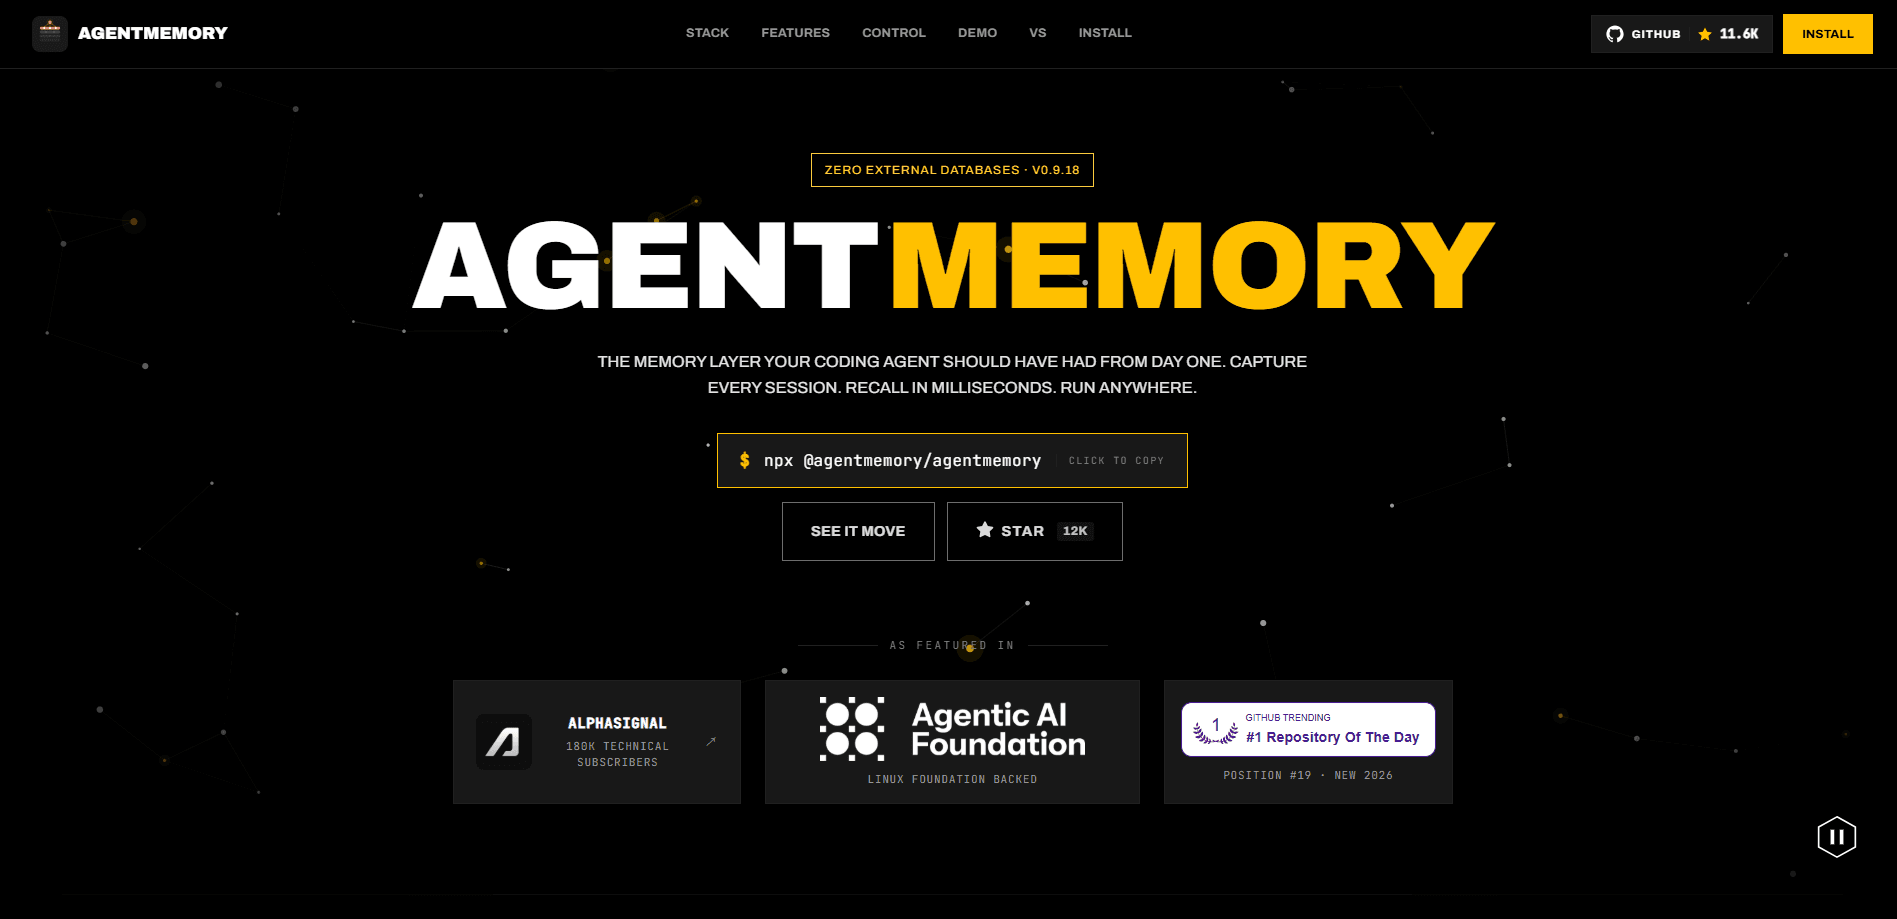
Über Agentmemory
Was ist Agentmemory
Agentmemory ist eine Gedächtnisschicht für KI-Coding-Agenten, gebaut für Entwickler, die es leid sind, jeden Morgen dasselbe Projekt einer frischen Sitzung neu zu erklären. Sie beobachtet, was der Agent tut, verwandelt diese Beobachtungen in typisierte Erinnerungen und gibt die relevanten zurück, wenn die nächste Aufgabe startet. Stellen Sie es sich als das Langzeitgedächtnis vor, das Ihr Coding-Agent nie mitgeliefert hat.
Das Projekt ist Open Source und local-first. Beobachtungen, Erinnerungen, Lektionen und Graphdaten Ihres Agenten bleiben in einer Runtime auf Ihrer eigenen Hardware. Kein Konto zum Anlegen. Kein Cloud-Vektorspeicher zum Bezahlen. Keine externe Datenbank, die am Leben gehalten werden muss.
Die größte Einschränkung ist der Umfang. Das ist ein Entwicklerwerkzeug, kein Plug-and-Play-Produkt für einen Gelegenheitsnutzer im Chat. Es setzt voraus, dass Sie Ihren eigenen Agenten-Workflow aufsetzen. Erfassung und Abruf funktionieren ohne LLM-Schlüssel, aber Kompression, Zusammenfassung, Konsolidierung und Graph-Extraktion schalten erst ein, wenn Sie Ihren eigenen LLM-Anbieterschlüssel verbinden.
Erste Schritte
- Installieren Sie die Runtime mit
npx @agentmemory/agentmemory, oder installieren Sie sie global über npm und führen Sieagentmemoryaus. - Starten Sie den Prozess. Er fährt die Engine, die REST-API auf Port 3111 und einen Viewer auf Port 3113 in einem Zug hoch.
- Verbinden Sie Ihren Agenten mit
npx @agentmemory/agentmemory connect, das Agenten auf Ihrer Maschine erkennt und für jeden die richtigen Hooks oder die MCP-Konfiguration schreibt. - Starten Sie den Agenten neu oder öffnen Sie eine frische Sitzung, damit er die neue Verdrahtung aufnimmt.
- Führen Sie einen Prompt aus, um Gedächtnis zu erzeugen, suchen Sie dann darin oder öffnen Sie den Viewer, um die Beobachtungen live eintreffen zu sehen.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Agentmemory.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Solo-Entwickler mit Claude Code, Codex oder Cursor
- Kleine Teams, die eine Codebasis teilen
- Datenschutzbewusste Entwickler
Aufgaben
- Ein langes Projekt nach einer Pause fortsetzen
- Wiederkehrende Probleme debuggen
- Einen Agenten in eine bestehende Codebasis einführen
Szenarien
- Die Arbeit von gestern in einem neuen Chat fortsetzen
- Mitten im Projekt das Werkzeug wechseln
- Token-Kosten für wiederholten Kontext senken
Wichtigste Funktionen
Hook-basierte automatische Erfassung
Agentmemory verdrahtet zwölf Hooks zur automatischen Erfassung in Ihren Coding-Agenten. Jeder Sitzungsstart, Prompt, Werkzeugaufruf und Stopp landet ohne Klebecode in der Gedächtnis-Pipeline. Jedes Ereignis wird zu einer komprimierten Beobachtung, gestempelt mit ihrer Herkunft und dem Agenten, der sie erzeugt hat. Installieren Sie das Plugin, und die Erfassung beginnt. Das ist alles.
Hybrider Abruf, der schnell bleibt
Der Memory-Abruf für Agenten ist hier keine einzelne Abfrage. Der primäre Abrufpfad reiht BM25-, Vektor- und Wissensgraph-Werte zusammen ein und ordnet dann auf dem Gerät neu. Dieser Winkel der Wissensgraph-Retrieval ist es, der sowohl exakte Stichworttreffer als auch bedeutungsbasierte einfängt. Ein reiner Vektorspeicher verfehlt oft die zweite Sorte. Überholte Versionen bleiben aus den Ergebnissen heraus, während ihre Historie abfragbar bleibt.
Automatische Konsolidierung
Sobald Sie einen LLM-Anbieterschlüssel liefern, läuft die Konsolidierung beim Stopp der Sitzung. Rohe Beobachtungen verdichten sich zu semantischen Erinnerungen, Duplikate verschmelzen, veraltete Zeilen verfallen mit Retentionsbewertung, und Audit-Zeilen halten den ganzen Durchlauf fest. Das ist es, was den Speicher davor bewahrt, zu einem undurchsuchbaren Haufen Protokolle zu werden.
Native MCP-Oberfläche und REST-Zwillinge
Das ist ein vollwertiger MCP-Memory-Server, kein dünner Wrapper. Vierundfünfzig MCP-Werkzeuge decken Speichern, Abruf, intelligente Suche, Sitzungen, Governance, Audit und Export hinter einem einzigen Server ab. Jedes hat einen REST-Zwilling unter /agentmemory/*, sodass Sie es per curl, aus einem Browser oder als Proxy von Ihrem eigenen Agenten aufrufen können. Das Speichern eines Fast-Duplikats gibt einen similarTo-Hinweis zurück statt einer zweiten Kopie.
Wissensgraph und Provenienz
Mit gesetztem LLM-Schlüssel und aktivierter Graph-Extraktion werden Entitäten und Relationen aus Beobachtungen extrahiert, einschließlich zeitlicher Kanten. Jeder Datensatz trägt Provenienz zum Schreibzeitpunkt, sodass Sie erkennen, ob eine Erinnerung vom Nutzer, vom Agenten, von einem Werkzeug, von einem Import oder von einer geteilten Quelle stammt.
Lektionen und JSONL-Replay
Lektionen liegen in einem eigenen BM25-Index mit Neubewertung nach Konfidenz und Aktualität, sodass eine einmal gespeicherte Regel zurückkommt, wenn sie relevant ist. Richten Sie die Runtime auf ein Claude-Code-JSONL-Transkript, und sie rehydriert die Sitzung, indexiert sie und leitet aus dem Gefundenen Kristalle und Lektionen ab.
Integrierter Viewer
Ein lokaler Viewer auf Port 3113 lässt Sie Beobachtungen in Echtzeit eintreffen sehen und den Graphen prüfen, den Ihr Agent aufgebaut hat. Das ist der schnellste Weg, um zu bestätigen, dass Erfassung, Indexierung und Abruf funktionieren, bevor Sie dem Speicher echtes Projektgedächtnis anvertrauen.
Vor- und Nachteile
Vorteile
- Null externe Datenbanken bedeuten, dass neben Ihrem Agenten nichts Zusätzliches laufen, gepatcht oder bezahlt werden muss.
- Das local-first Design hält alles Gedächtnis auf Ihrer eigenen Maschine, ein echter Gewinn für private Codebasen.
- Der hybride Abruf funktioniert ohne LLM-Schlüssel, sodass Sie ihn testen können, bevor Sie einen Anbieter anbinden.
- Vierundfünfzig MCP-Werkzeuge plus REST-Zwillinge bieten eine breite Oberfläche für eigene Workflows.
- Geteiltes Gedächtnis über verschiedene Agenten lässt Sie das Werkzeug wechseln, ohne Projektkontext zu verlieren.
Nachteile
- Es ist ein frühes Entwicklerwerkzeug, also erwarten Sie raue Kanten und eine kleinere Community als bei ausgereiften Gedächtnisdiensten.
- Konsolidierung, Zusammenfassung und Graph-Extraktion bleiben aus, bis Sie Ihren eigenen LLM-Anbieterschlüssel verbinden, was Einrichtung und Kosten hinzufügt.
- Der CLI- und Konfigurations-Workflow setzt Vertrautheit mit einem Terminal voraus, sodass nicht-technische Nutzer es schwer finden.
Häufige Fragen
Es speichert fünf Arten von Datensätzen: rohe Beobachtungen aus den Hooks, dauerhafte typisierte Erinnerungen mit Versionsketten, kurze Lektionen, eingefrorene Sitzungskristalle und einen Wissensgraph aus Entitäten und Relationen. Erinnerungen und Lektionen sind die Teile, die Sie am häufigsten abfragen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Agentmemory.
Alternativen zu Agentmemory
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.