

Anam
Anam · Stimme & Sprache · Video
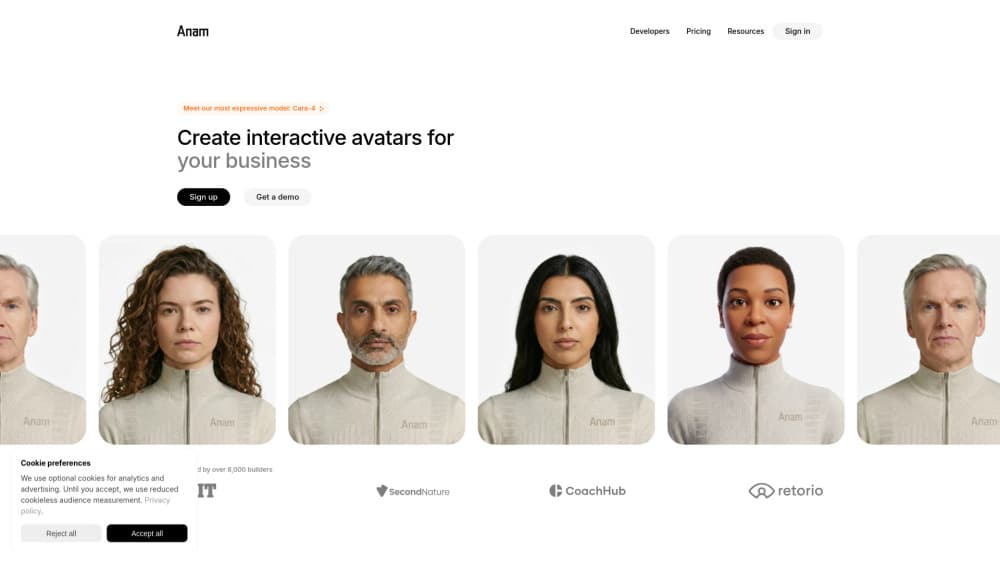
Anam ist eine Echtzeit-KI-Avatar-API, die konversationeller KI ein fotorealistisches Gesicht gibt. Du hängst dein eigenes Sprachmodell an seine Personas, und seine CARA-Modelle rendern einen Avatar, der spricht und Emotionen zeigt, mit einer Lippensynchronisation, die gut genug ist, um Menschen im Gespräch zu halten. Es ist für Teams gedacht, die Support-, Vertriebs-, Tutorings- oder Trainingsagenten ausliefern, die ein menschliches Gesicht in Video-Geschwindigkeit brauchen. Das Produkt besetzt den wachsenden Markt der konversationellen Video-KI, in der ein sprechendes Gesicht das schlichte Chat-Fenster ersetzt. Interaktive Avatare sind hier der ganze Punkt: Der Agent spricht, hört zu und reagiert auf dem Bildschirm, statt nur Text auszugeben. Das ist eine andere Aufgabe als das Erzeugen eines einzelnen Videoclips.
Über Anam
Was ist Anam
Anam macht KI-Agenten sichtbar. Das Argument des Unternehmens ist einfach: Text- und Sprach-Chatbots fühlen sich wie Werkzeuge an, aber ein Gesicht lässt ein Gespräch wie ein Gespräch wirken. Es verkauft das als API, damit Entwickler einen interaktiven Avatar in ein bestehendes Produkt einbauen können, statt Video-KI von Grund auf zu bauen.
Der Kern ist eine Reihe von Echtzeit-Avatar-Modellen. CARA kontrolliert jeden Pixel über ein Diffusionsmodell, statt Clips zusammenzusetzen. So bekommt Anam natürliche Mikroexpressionen und eine enge Lippensynchronisation, statt des steifen, zusammengeschnittenen Looks älterer Avatar-Werkzeuge. Laut Anam führt CARA-4 in seinem eigenen Benchmark bei Gesamterlebnis, Lippensynchronisation, visueller Qualität und Natürlichkeit.
Die Grenzen zählen ebenso viel wie die Stärken. Anam liefert das Gesicht, nicht das Gehirn. Du bringst das LLM und die Stimme mit, also hängt die Qualität des fertigen Gesprächs stark davon ab, was du anschließt. Die Latenz skaliert zudem mit deinem Setup, und die Preise für die Avatar-API steigen schnell, sobald du kleine Experimente hinter dir lässt.
Erste Schritte
- Erstelle ein Konto in Anam's Lab und wähle einen Tarif, beginnend mit der kostenlosen Stufe, wenn du nur testen willst.
- Wähle einen fertigen Avatar oder lade ein Bild hoch, um einen eigenen zu bauen, und wähle dann eine Stimme aus oder lade eine hoch.
- Verbinde dein Sprachmodell und definiere eine Persona, indem du Persönlichkeit und Einstellungen nach Bedarf anpasst.
- Binde den Avatar über das No-Code-Widget ein oder verbinde ihn mit dem JavaScript- oder Python-SDK.
- Führe eine Testsitzung aus, prüfe Lippensynchronisation und Antwortzeiten, und bring ihn dann in die Produktion.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Anam.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Produktteams bei SaaS- und Support-Unternehmen
- Einzelentwickler und kleine Teams, die Avatar-Agenten testen
- Ersteller von Schulungen und Onboarding
Aufgaben
- Support-Agenten
- Vertrieb und Lead-Qualifizierung
- Sprachtutoring
Szenarien
- Ein mehrsprachiger Support-Agent starten, bevor du Sprecher für jede Region einstellst.
- Eine interne Wissensbasis in einen Onboarding-Assistenten von Angesicht zu Angesicht verwandeln, der Fragen in Echtzeit beantwortet.
- Eine Demo eines interaktiven Avatars für einen Kunden oder Investor testen, ohne einen vollen Engineering-Sprint.
Wichtigste Funktionen
Echtzeit-Avatar-Rendering mit CARA
Anams CARA-Modelle erzeugen den Avatar Bild für Bild mit 25fps und 720x480. Jeder Pixel wird kontrolliert, nicht aus voraufgezeichneten Clips abgespielt. Das lässt Ausdrücke mitten im Satz wechseln, statt zwischen Posen zu springen. Der Kompromiss ist die Auflösung. Es ist für Live-Gespräche gebaut, nicht für filmreife Ausgabe.
Niedrige Latenz fürs Gespräch
Anam nennt eine mediane serverseitige Antwortzeit von 180ms. Das Unternehmen behauptet, das sei etwa 33 % schneller als der nächstbeste Wettbewerber. In der Praxis ist das der Unterschied zwischen einem Gespräch, das fließt, und einem, in dem Menschen über den Avatar hinweg reden. Die tatsächlichen Werte hängen weiterhin von deinem Netzwerk und davon ab, wie schnell dein eigenes LLM antwortet.
Bring dein eigenes LLM und deine Stimme mit
Du bist weder beim Denken noch beim Sprechen an Anams Modelle gebunden. Schließe ein beliebiges LLM an und wähle aus mehr als 70 Stimmen oder lade eine eigene hoch. Diese Flexibilität ist der Hauptanreiz für Teams, die bereits eine abgestimmte Pipeline haben. Sie bedeutet auch, dass Anam nur das Gesicht liefert, also zeigt sich ein schwaches Modell darunter auf dem Bildschirm.
Eigene und fertige Avatare
Erstelle einen eigenen Avatar aus einem einzigen hochgeladenen Bild oder starte mit einem der 20 fertigen Avatare. Sie decken fotorealistische, 3D-, Anime- und Comic-Looks ab. Der Weg vom Bild zum Avatar ist schnell genug für einen Prototyp am selben Tag. Schwerere Realismus-Arbeit profitiert trotzdem davon, zuerst ein paar Ausgangsbilder zu testen.
Tool-Aufrufe und Wissensabruf
Personas können während einer Sitzung externe Tools aufrufen und aus einer Wissensbasis schöpfen, sodass der Avatar Dinge nachschlagen und handeln kann, statt nur zu plaudern. Für Support- und Vertriebsfälle ist das der Unterschied zwischen einem sprechenden Kopf und einem arbeitenden Agenten. Die Einrichtungsarbeit liegt auf deiner Seite, weil du die Tools und Datenquellen definierst.
Mehrsprachige Gespräche
Anam unterstützt mehr als 70 Sprachen mit nativen Akzenten und Dialekten, was nach Zählung des Unternehmens rund 95 % der Sprecher weltweit abdeckt. Ein einziges Persona-Setup kann internationale Nutzer bedienen, ohne pro Region neu zu bauen. Sprachqualität und Akzentgenauigkeit lohnen sich vor dem Start in deinen Zielsprachen zu prüfen.
No-Code-Lab und SDK-Optionen
Anam's Lab lässt dich Persönlichkeiten konfigurieren, Stimmen testen und einen Anwendungsfall validieren, ohne Code zu schreiben. Wenn du bereit bist, decken die JavaScript- und Python-SDKs und die REST-API jedes moderne Web-Framework ab. Teams können im Lab prototypen und zum Code wechseln, wenn das Konzept hält.
Vor- und Nachteile
Vorteile
- Echtzeit-Rendering mit niedriger Latenz, was den Austausch natürlich hält
- Das Mitbringen von eigenem LLM und Stimme lässt es in bestehende Pipelines passen, statt sie zu ersetzen
- Bild-zu-Avatar und eine Bibliothek fertiger Avatare decken schnelle Prototypen und eigenes Branding ab
- Unterstützung für mehr als 70 Sprachen und native Akzente passt zu globalen Produkten
- Kostenloser Tarif und ein Starter-Tarif für $12 machen frühe Tests günstig
Nachteile
- Du lieferst LLM und Stimme, also hängt die Endqualität von deinem Stack ab, nicht nur von Anam
- Die Ausgabe ist auf 720x480 Auflösung begrenzt, was filmreife Ansprüche nicht erfüllt
- Gesprächslängenlimits in niedrigeren Tarifen (3 bis 10 Minuten) blockieren langen Einsatz, bis du für Growth zahlst
- Die Kosten steigen im Maßstab schnell, von $299/mo für Growth bis $999/mo für Professional
Häufige Fragen
Es verleiht einem KI-Agenten über eine API ein fotorealistisches Echtzeit-Gesicht. Du verbindest dein eigenes Sprachmodell und deine Stimme, und Anam rendert den Avatar, sodass er in einem Live-Videogespräch spricht, zuhört und Emotionen zeigt.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Anam.
Alternativen zu Anam
Prosp
Prosp · Schreiben · Stimme & Sprache · MarketingProsp ist ein KI-Tool für LinkedIn-Ansprache, gebaut für Agenturen und Vertriebsteams, und es schreibt die Nachricht und die Sprachnachricht mit Ihrer eigenen Stimme für jeden Interessenten, damit sie wirklich antworten. Sie verbinden Ihre Konten, finden Leads und lassen die KI personalisierte Nachrichten in großem Umfang entwerfen und versenden, alles aus einem Posteingang. Es ist für Menschen gemacht, die Outbound in großem Stil betreiben. Das ist das ganze Versprechen. Jeder Kontaktpunkt muss trotzdem menschlich wirken.

Wordly AI Translation
Wordly · Stimme & Sprache · ProduktivitätWordly AI Translation ist eine KI-Echtzeitübersetzungs- und Untertitelungsplattform für Besprechungen, Konferenzen und Veranstaltungen. Sie liefert Live-Übersetzung, Untertitel, Transkripte und Zusammenfassungen in mehr als 60 Sprachen, und Teilnehmer treten per QR-Code-Scan oder über einen Link bei, statt eigene Kopfhörer zu nutzen. Die Plattform arbeitet mit Zoom, Microsoft Teams, Google Meet und Webex zusammen und richtet sich an Organisationen, die mehrsprachigen Zugang wollen, ohne für jede Sitzung menschliche Dolmetscher zu engagieren. So einfach ist das.
Musicful
Musicful AI · Stimme & Sprache · VideoMusicful ist ein KI-Musikgenerator und KI-Musikvideo-Ersteller, der Text in Minuten in Musik verwandelt. Du gibst einen Text, einen Songtext oder eine gesummte Melodie ein und erhältst einen fertigen Track mit Gesang und Instrumenten. Er dient außerdem als KI-Songgenerator, erstellt Musikvideos aus den Songs, die du machst, und bietet ein KI-Cover-Werkzeug plus eine Entwickler-API. Die Plattform läuft im Webbrowser und über eine Android-App, sodass du einen Song am Desktop beginnen und am Handy fortsetzen kannst.