
Avaturn Live
Avaturn · Bilder · Stimme & Sprache
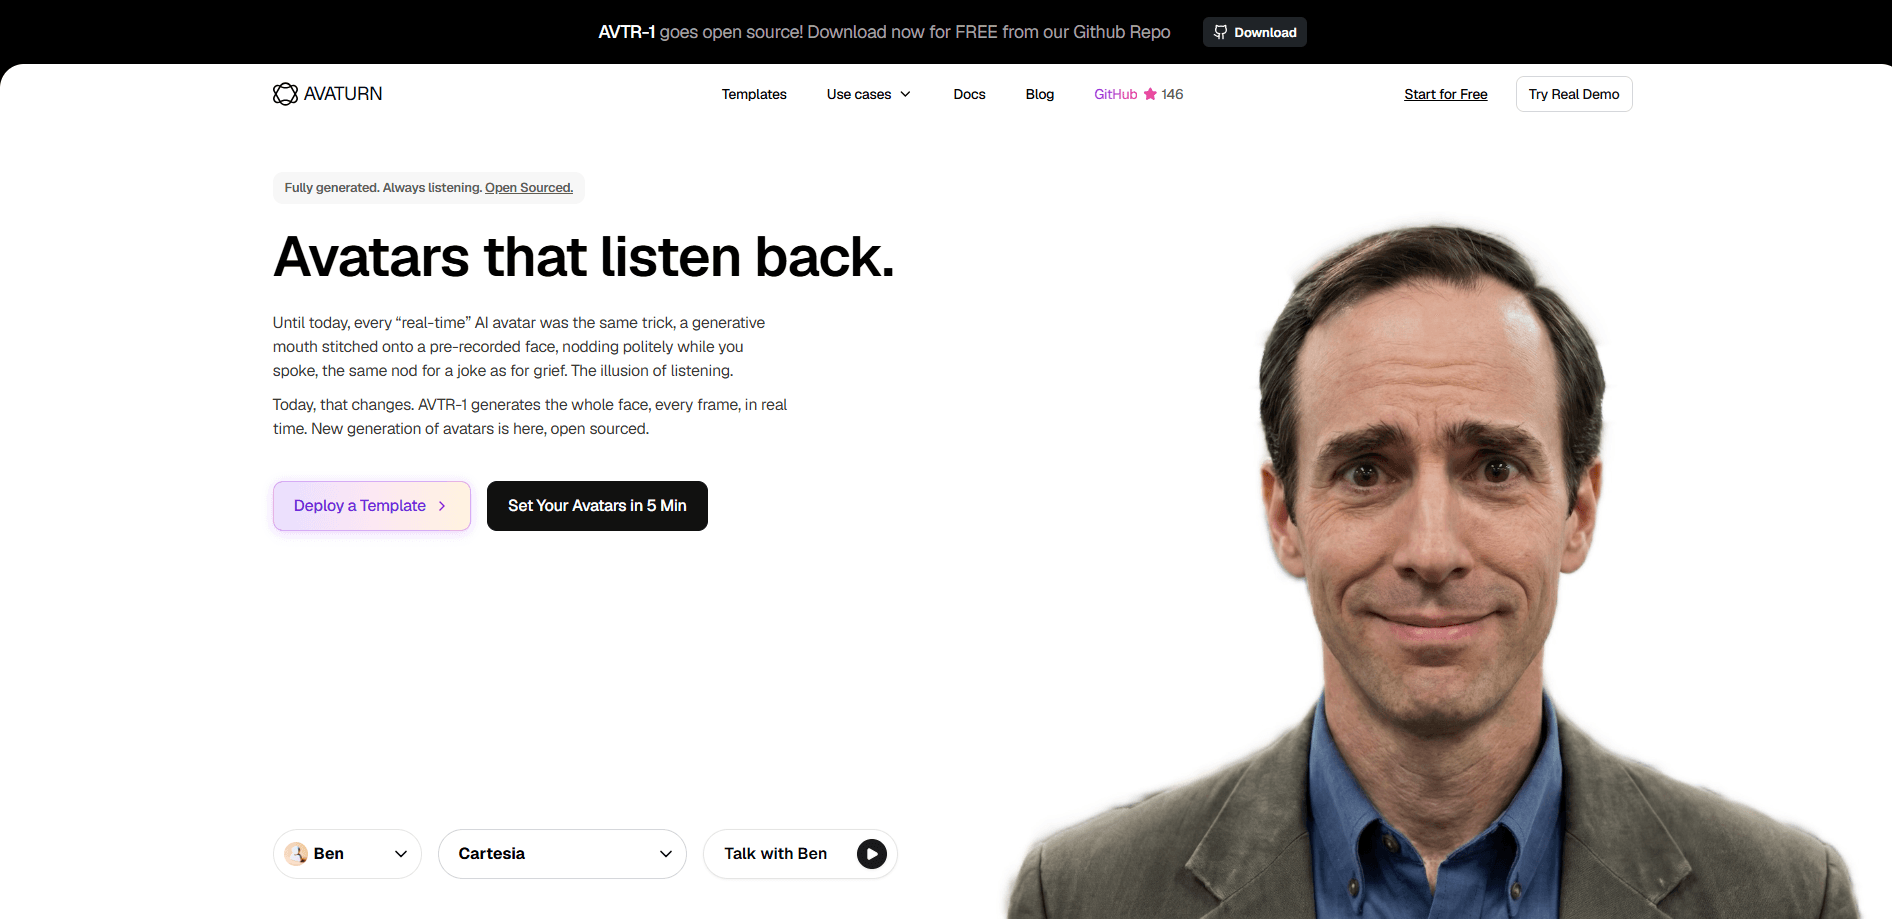
Avaturn Live ist eine Echtzeit-Plattform für KI-Avatare, die aus einem einzigen Porträtbild ein vollständig animiertes Gesicht für Live-Gespräche macht. Warum wirkt es weniger unheimlich als ein normaler Generator für sprechende Avatare? Weil es jedes Bild des Gesichts rendert, nicht nur den Mund. Die Figur blinzelt, reagiert und zeigt Emotionen, während die andere Person spricht. Dazu kommen fertige Demos, Vorlagen und ein SDK/API, mit dem man konversationelle KI-Avatare in wenigen Minuten in Sprach-Apps einbaut.
Über Avaturn Live
Was ist Avaturn Live
Avaturn Live ist eine Plattform für lebensechte KI-Avatare, die in einem Live-Sprachgespräch bestehen können. Das Kernmodell AVTR-1 erzeugt ein synchronisiertes Gesicht mit 25 Bildern pro Sekunde auf einer einzigen GPU, und es bewegt weit mehr als den Mund. Das ganze Gesicht wird Bild für Bild animiert, deshalb nennt das Unternehmen diese Avatare „zurückhörend" statt nur sprechend.
Das Problem, das es löst, kennt jeder, der einen Sprachagenten baut. Ein Chatbot mit synthetischer Stimme klingt gut, bis man ihm ein Gesicht gibt, und dann verrät das Gesicht alles. Herkömmliche Werkzeuge für sprechende Köpfe bilden nur Audio auf Lippen ab, also starrt der Avatar ins Leere, sobald der Nutzer spricht. Avaturn Live lässt die Figur in der anderen Hälfte des Austauschs weiter reagieren, was bei Nachhilfe, Verkaufstrainings und Kundensupport zählt, wo Schweigen wie Ratlosigkeit wirkt.
Die größte Einschränkung ist die Hardware. Wer das Modell selbst betreibt, braucht eine ordentliche NVIDIA-GPU, CUDA 12.x und TensorRT 10.x, also ist Selbsthosting kein Wochenendprojekt auf dem Laptop. Für die meisten Teams sind die gehostete API oder die fertigen Vorlagen der realistische Einstieg. Zum Zeitpunkt dieses Textes fand ich keine veröffentlichten API-Preise auf der Website, also behandle jede Kostenschätzung als unbestätigt, bis du direkt beim Anbieter nachfragst.
Erste Schritte
- Öffne das Dashboard und richte einen Avatar in etwa fünf Minuten über den eigenen Upload-Ablauf des Unternehmens ein.
- Wähle eine Vorlage oder starte aus einer Demo, dann sparst du dir den Aufbau der Sitzungslogik von null.
- Wähle ein Porträtbild aus oder lade eines hoch, und verbinde dann deine Audioströme für Sprechen und Zuhören.
- Teste die Live-Sitzung im Browser. Prüfe die Lippensynchronisation und das Reaktionstempo über deine Verbindung.
- Für den Produktivbetrieb verbinde dich über das SDK oder die API, oder klone das AVTR-1-Repository und hoste es auf deiner eigenen GPU.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Avaturn Live.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler, die Sprachagenten bauen
- Vertriebs- und Support-Teams
- Lehrende und Sprachtutoren
Aufgaben
- Live-Rollenspiel für Verkaufsgespräche
- Sprachübung mit Aussprache-Feedback
- Kundensupport-Agenten
Szenarien
- Ein KI-Produkt an einem Nachmittag prototypen
- Ein privates Modell selbst hosten
- Browser-Demos für Kunden
Wichtigste Funktionen
Bild-für-Bild-Gesichtsanimation
Die meisten Avatar-Werkzeuge bewegen nur die Lippen, deshalb wirken sie unheimlich. Avaturn Live rendert für jedes Bild das ganze Gesicht, also blinzelt der Avatar, verändert den Ausdruck und reagiert auf die sprechende Person. Das ist der Unterschied zwischen einem sprechenden Kopf und einer Figur, die im Raum zu sein scheint.
Aktives Zuhören und emotionale Reaktion
Das Modell nimmt einen Audiostrom mit zwei Kanälen auf, einen für das Sprechen und einen für das Gegenüber. Dann reagiert es auf beide. Es verstummt nicht, während die andere Seite spricht. Bei Nachhilfe, Vertrieb oder Support verhindert diese Reaktion, dass sich ein Gespräch wie ein pausiertes Video anfühlt.
25 Bilder pro Sekunde auf einer einzigen GPU
AVTR-1 erzeugt Bewegung in Fünf-Bild-Blöcken bei 25 fps. Das ergibt 200 ms Ausgabe pro Block. Jede GPU, die schnell genug ist, unter dieser Grenze zu bleiben, läuft in Echtzeit. Laut den veröffentlichten Zahlen von Avaturn schafft eine L40 einen Block in 84 ms, eine RTX 4060 Ti in 166 ms und eine L4 gerade eben in 202. Über die Grenze der eigenen Karte hinauszugehen bedeutet verlorene Bilder. Es stürzt nicht ab.
Open-Source-Modell mit Selbsthosting
AVTR-1 ist Open Source, mit Gewichten, Inferenzcode und TensorRT-beschleunigten Builds auf GitHub. Teams mit strengen Datenvorgaben können das Modell holen und hinter der eigenen Firewall betreiben. Der Preis dafür ist Einrichtungsarbeit: CUDA 12.x, TensorRT 10.x und pro Maschine kompilierte Engines.
Vorlagen und fertige Demos
Die Plattform bringt funktionierende Beispiele mit, darunter einen Verkaufssimulations-Agenten, einen Sprachtutor und eine Datenanalysten-Persona. Jedes kommt als Live-Demo und als einsetzbare Vorlage. Für ein kleines Team ist das der schnellste Weg von „wir wollen Avatare" zu etwas, das ein Entscheider anklicken kann.
SDK- und API-Integration
Du kannst Avatare über ein Avatar-SDK oder eine API in eine bestehende Sprach-App einbauen, oder über ein vollständig selbst gehostetes Backend. Du musst die Rendering-Pipeline nicht selbst bauen. Das Backend der Live-Sitzung übernimmt das Streaming. Deine App sendet nur Audio und zeigt Video.
Vor- und Nachteile
Vorteile
- Rendert pro Bild das ganze Gesicht, also reagieren die Avatare während der Pausen, statt zu einem Standbild zu erstarren.
- Erreicht 25 fps auf einer einzigen GPU, mit veröffentlichten Latenzwerten für gängige Karten wie die L40 und die RTX 4060 Ti.
- Open-Source-Modell AVTR-1, also ist Selbsthosting hinter einer Firewall eine echte Option.
- Vorlagen und Demos verkürzen den Weg von der Idee zum anklickbaren Prototyp.
Nachteile
- Selbsthosting braucht eine NVIDIA-GPU plus CUDA 12.x und TensorRT 10.x, und die Engines müssen auf jeder Maschine neu kompiliert werden. Das schließt schnelle Laptop-Setups aus.
- Die Preise sind nicht auf der Website veröffentlicht, also kannst du nicht allein von der API-Seite aus planen und musst den Anbieter fragen.
- Kleinere GPUs wie die L4 liegen genau auf der Echtzeitlinie, also ist die Reserve für schwerere Szenen dünn.
Häufige Fragen
Es ist eine Plattform für Echtzeit-KI-Avatare, die während Live-Sprachgesprächen ein vollständiges Gesicht animieren, nicht nur die Lippensynchronisation. Das Modell AVTR-1 treibt sowohl das gehostete Produkt als auch eine selbst gehostete Version an.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Avaturn Live.
Alternativen zu Avaturn Live

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

Tractionwave
TractionWave · Bilder · MarketingTractionWave erstellt per KI eine Aufmerksamkeits-Heatmap für statische Anzeigen. Sie laden ein PNG oder JPG hoch und bekommen prognostizierte Aufmerksamkeit, sortierte Hotspots und Korrekturen, bevor Budget fließt.

Imejis.io
Imejis.io · Bilder · MarketingImejis.io ist ein KI-Designstudio für Agenten und Marketingteams. Sie beschreiben ein Bild in eigenen Worten, und das Werkzeug schreibt den Text, baut das Layout, passt es an jedes Format an und exportiert die fertige Datei.