
Cerebrium
Cerebrium · Coding
Cerebrium ist eine serverlose GPU-Plattform für Echtzeit-KI-Apps in der Cloud. Sie rechnet Rechenleistung sekundengenau ab und deployt in mehreren Regionen.
Über Cerebrium
What Is Cerebrium
Cerebrium ist Infrastruktur für KI-Workloads, die schnell antworten müssen. Sie packen Python-Code in einen Container, deployen ihn, und Cerebrium macht daraus einen Endpunkt, der von selbst skaliert. Die Plattform betreibt CPUs und NVIDIA-GPUs und zielt auf Aufgaben, bei denen Kaltstart und Latenz darüber entscheiden, ob ein Produkt funktioniert: Sprachagenten, Streaming-Ausgaben von Modellen und Inferenz mit viel Traffic.
Die Geschwindigkeit hat zwei Ursachen. Container starten in ein bis drei Sekunden, und ein System namens Content-Aware Storage zieht nur die Dateien, die eine neue Instanz braucht, statt des ganzen Images. Für schwerere Aufgaben nimmt das Checkpointing von Speicher und GPU einen Schnappschuss des laufenden Prozesses auf, sodass das Modell beim nächsten Start Importe und CUDA-Kompilierung überspringt. Laut Cerebrium verkürzt das Checkpointing den Kaltstart deutlich, die Funktion ist aber noch in der Beta.
Der Preis richtet sich nach Nutzung, nicht nach Sitzen. Sie zahlen pro Sekunde für vCPUs, Speicher und GPUs, die ein Workload während der Laufzeit hält, sodass die sekundengenaue Abrechnung die Kosten an die tatsächliche Arbeit bindet. Der Hobby-Plan ist kostenlos zum Start und rechnet die Rechenleistung obendrauf ab; Standard kostet 100 Dollar pro Monat plus Rechenleistung für unbegrenzte Sitze und Apps. Teams, die reservierte Kapazität, Mengenrabatte oder Hilfe beim ML-Engineering brauchen, wechseln zu Enterprise. Die Rechenleistung läuft auf Google Cloud, AWS und Azure, und Cerebrium leitet die Arbeit dorthin, wo sie am besten passt.
Getting Started
- Installieren Sie die CLI mit pip install cerebrium, oder nutzen Sie Homebrew unter macOS und ein Binärpaket unter Linux.
- Führen Sie cerebrium login aus, öffnen Sie dann das Dashboard, um einen API-Key anzulegen und Ihre Projekt-ID zu finden.
- Führen Sie cerebrium init my-first-app aus, um ein Projekt mit main.py und cerebrium.toml anzulegen.
- Testen Sie den Code mit cerebrium run main.py::run und veröffentlichen Sie ihn mit cerebrium deploy.
- Rufen Sie den deployten Endpunkt über seine api.cerebrium.ai-URL auf, oder richten Sie eine eigene Domain ein.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Cerebrium.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Entwickler, die Inferenz-APIs ausliefern
- Teams mit unregelmäßigem Traffic
- Entwickler von Sprach- und Streaming-Apps
- Unternehmen mit Vorgaben zur Datenhaltung
Aufgaben
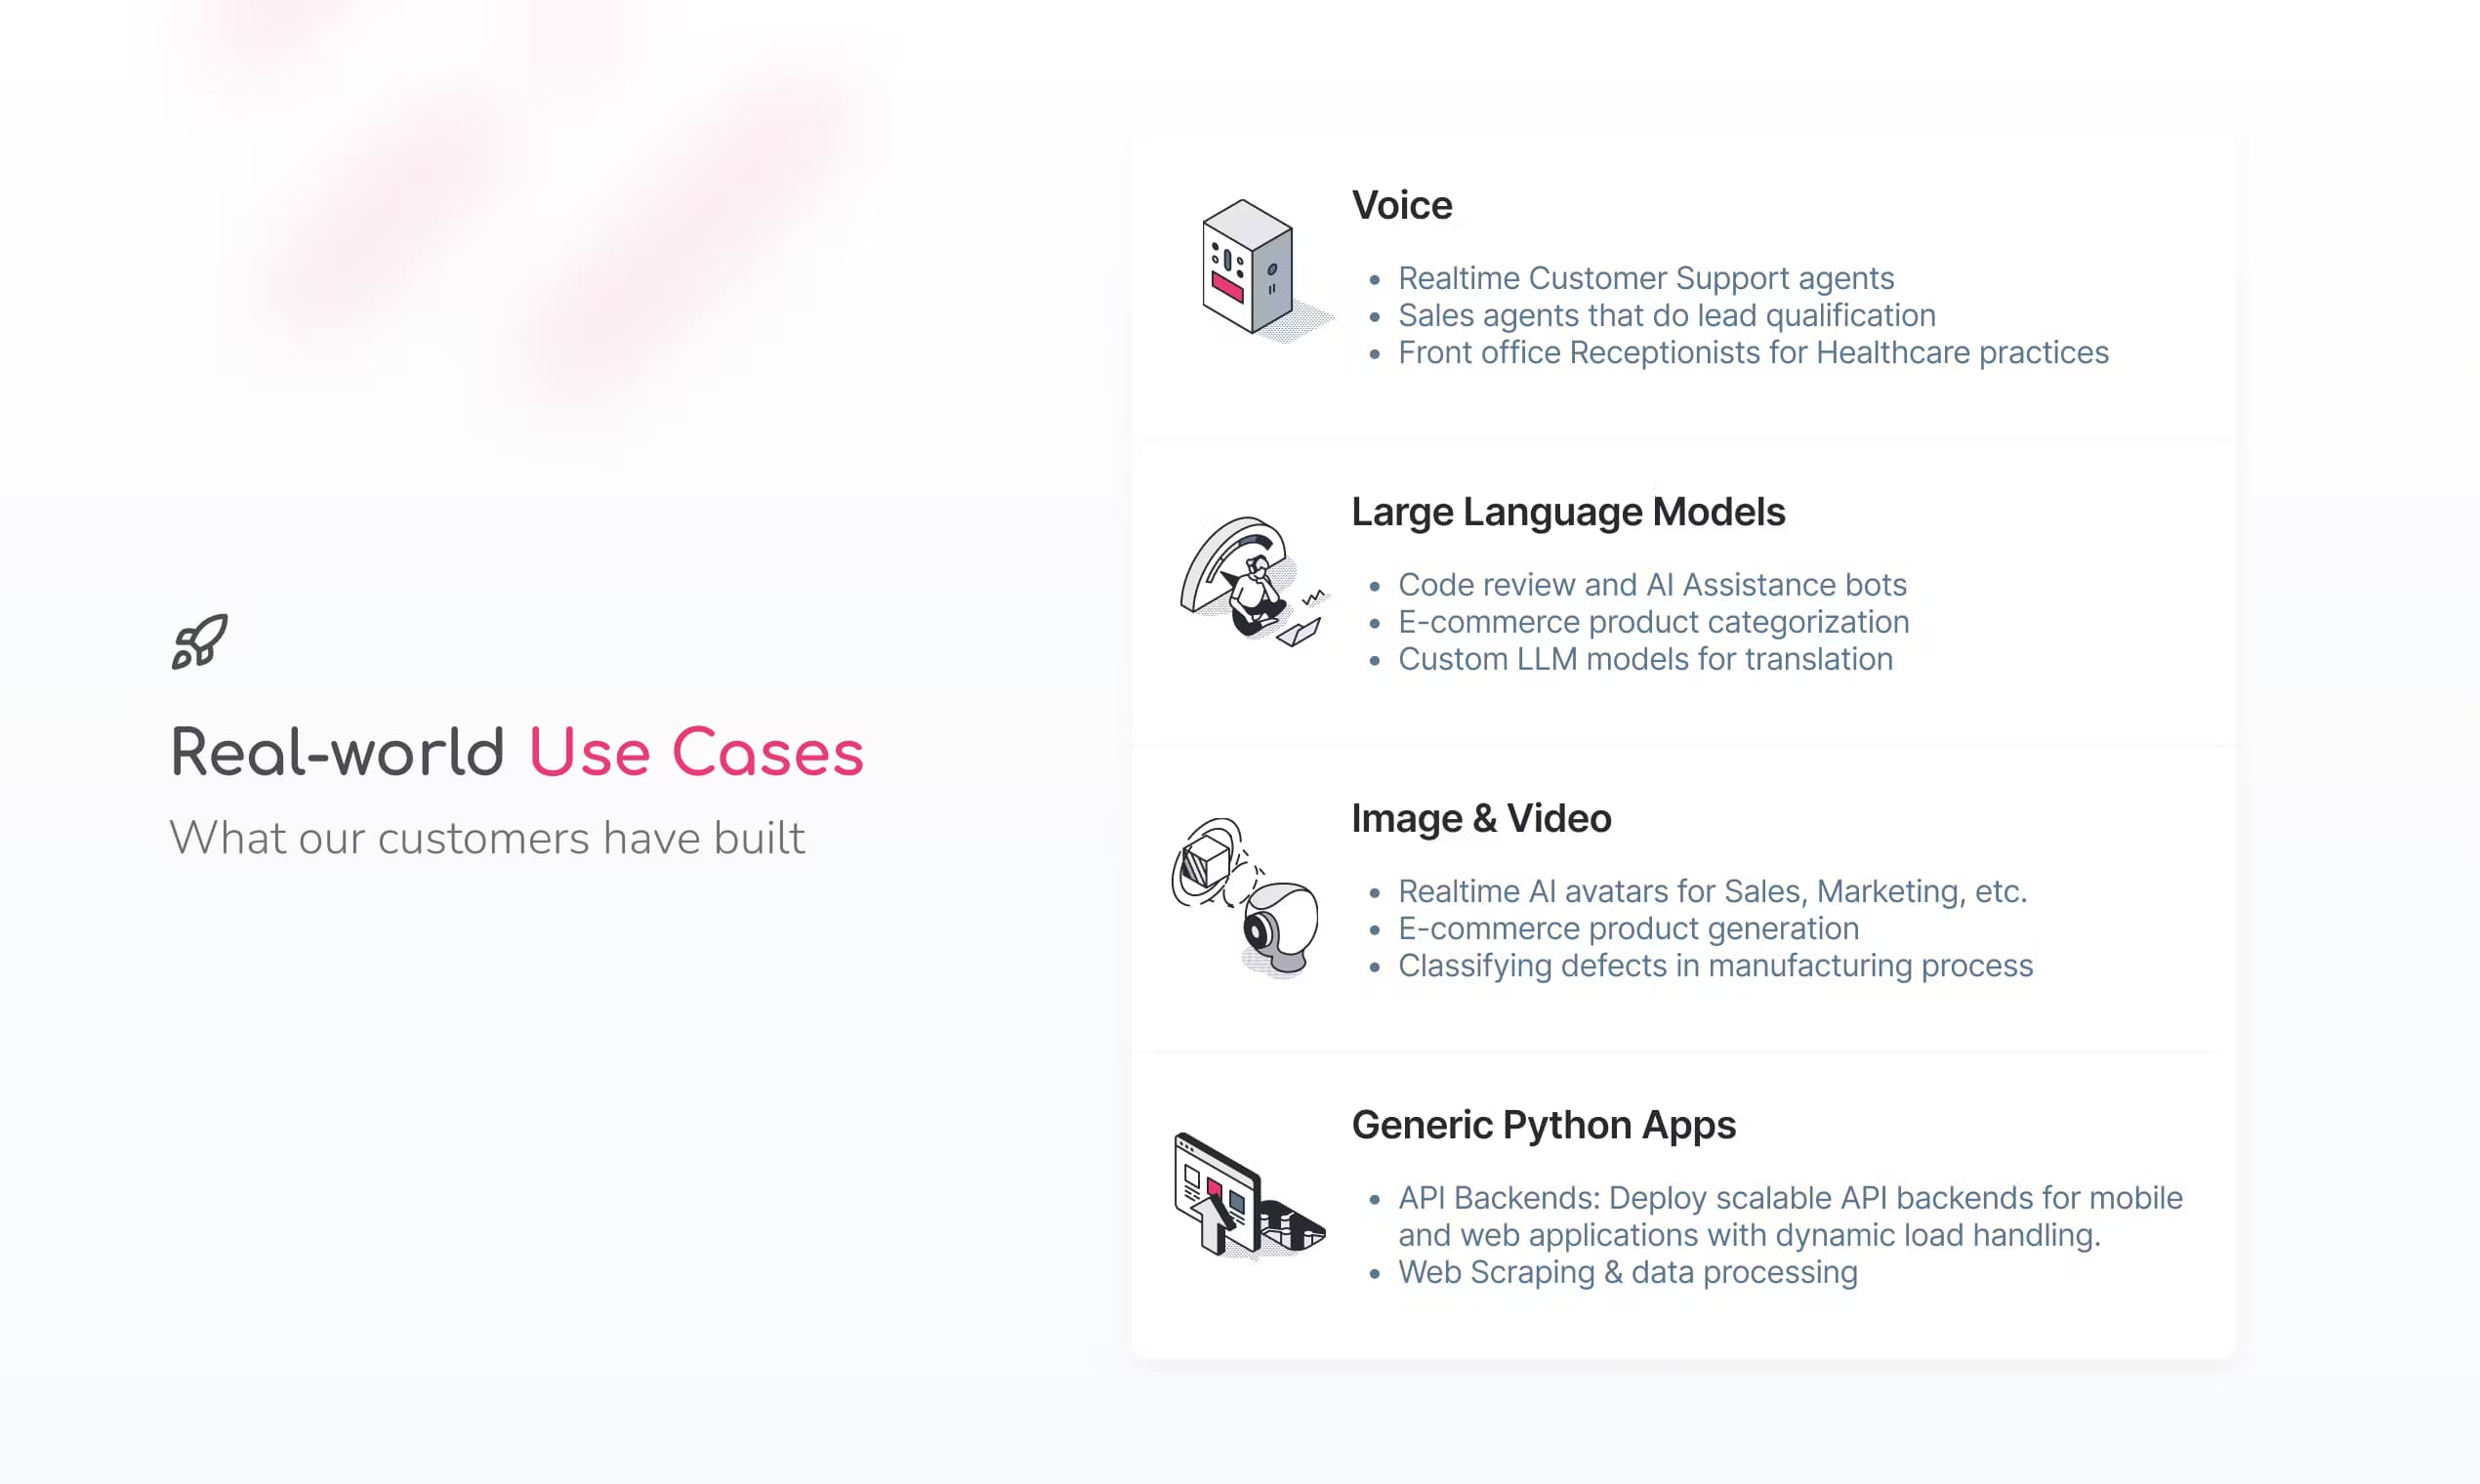
- Offene Modelle ausliefern
- Bilder und Videos erzeugen
- Langes Audio transkribieren
- Echtzeit-Sprachagenten bauen
- Embeddings und Reranking betreiben
Szenarien
- Ein Telefon-Support-Bot, der antwortet, während die Person noch spricht
- Eine Traffic-Spitze am Launch-Tag
- Ein nächtlicher Stapel Transkriptionen
- Eine globale App mit Nutzern in mehreren Regionen
Wichtigste Funktionen
Container-Start in unter einer Sekunde
Cerebrium startet Container in ein bis drei Sekunden, indem es Content-Aware Storage, das nur die nötigen Dateien zieht, mit dem Checkpointing von Speicher und GPU verbindet, das Importe, Modellladen und CUDA-Kompilierung überspringt. Der schnelle Start zählt besonders für Echtzeit-Apps, in denen eine langsame erste Anfrage wie ein kaputtes Produkt wirkt.
Serverlose GPUs und CPUs
Sie legen GPU-Typ und -Anzahl, vCPU-Kerne und Speicher in der cerebrium.toml fest und wählen NVIDIA-Karten wie H100, A100 und L40s. Instanzen skalieren mit dem Traffic, eine ruhige Stunde kostet also wenig und eine volle läuft nicht aus dem Ruder. Sie zahlen pro Sekunde nur für die zugewiesenen Ressourcen.
Multi-Region-Deployment
Ein Deployment kann in mehreren Regionen laufen, für geringere Latenz und höhere Verfügbarkeit, oder für die Datenhaltung auf eine festgelegt bleiben. Cerebrium läuft auf Google Cloud, AWS und Azure und nennt 99,999 Prozent Verfügbarkeit mit Failover, das Traffic umleitet, wenn eine Region ausfällt.
Flexible Endpunkt-Typen
Apps können eine REST-API, einen Streaming-Endpunkt über Server-Sent Events, einen WebSocket für bidirektionales Audio oder jeden ASGI-kompatiblen Webserver ausliefern. Diese Bandbreite lässt eine Plattform sowohl einen einfachen JSON-Aufruf als auch eine Live-Sprachsitzung hosten.
Autoscaling und Batching
Sie konfigurieren Replicas, Skalierungsmetriken und Rechen-Tiers und stellen dann Nebenläufigkeit und Batching auf echten Traffic ein. Framework-nahes Batching mit vLLM oder LitServe hebt den GPU-Durchsatz, was die Kosten pro Anfrage unter Last senkt.
Persistenter Speicher
Volumes speichern Modellgewichte und Dateien über Deployments hinweg, mit Befehlen zum Hochladen, Herunterladen und Auflisten in der CLI und projektweiser Größenanpassung bis 1TB. Gewichte bleiben zwischen Starts erhalten, Container laden sie also nicht bei jedem Start neu herunter.
Sicherheit und Isolation
Jeder Workload läuft auf gVisor in einer gehärteten Sandbox, was starke Container-Isolation ohne großen Performance-Verlust liefert. Die Plattform erfüllt SOC 2, HIPAA, DSGVO und ISO, und Secrets werden verschlüsselt und als Umgebungsvariablen bereitgestellt.
CI/CD und GitHub-Integration
Apps lassen sich mit einem GitHub-Repository verbinden, sodass ein Push oder Merge ein Deployment auslöst, über Service-Account-Schlüssel in einer Pipeline. Einstellungen für das schrittweise Deployment verschieben den Traffic zwischen Revisionen über ein festes Fenster, was das Risiko einer schlechten Version in der Produktion senkt.
Vor- und Nachteile
Vorteile
- Erste Anfragen kommen in ein bis drei Sekunden an, Echtzeit- und Sprach-Apps stocken beim Start also nicht.
- Die sekundengenaue Abrechnung über GPU, CPU und Speicher hält die Kosten an der echten Arbeit und macht die Infrastruktur für KI-Inferenz bezahlbar.
- Ein kostenloser Hobby-Plan und ein Standard-Plan für 100 Dollar machen das Ausprobieren und kleine Apps günstig.
- Multi-Region-Deployment und Compliance-Abdeckung passen zu globalen Teams oder regulierten Daten.
- Die Unterstützung von REST, Streaming, WebSockets und eigenen Docker- oder ASGI-Servern passt zu vielen Stacks.
Nachteile
- Das Checkpointing von Speicher und GPU ist noch in der Beta, die größten Kaltstart-Gewinne sind also noch nicht fest.
- Die Preisseite listet keine festen GPU-Preise, Sie schätzen die Kosten also über einen Kalkulator oder ein Angebot.
- AWS- und GCP-Guthaben lassen sich nicht einsetzen, was Teams überrascht, die schon auf diese Clouds setzen.
- Garantierte GPU-Kapazität verlangt einen monatlichen Mindestumsatz, was sie für kleine Projekte ausschließt.
Häufige Fragen
Cerebrium ist eine serverlose GPU-Plattform für Echtzeit- und Hochleistungs-KI-Workloads. Sie deployen einen Container und er wird zu einem skalierenden Endpunkt auf CPU oder NVIDIA-GPU, sekundengenau abgerechnet.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Cerebrium.
Alternativen zu Cerebrium
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.