
Context Gateway
Compresr · Coding
Context Gateway ist ein agentischer Proxy, der zwischen Ihrem KI-Coding-Agenten und der LLM-API sitzt und den Gesprächsverlauf im Hintergrund komprimiert, bevor die Sitzung überhaupt an die Grenze des Kontextfensters stößt. Entwickelt von Compresr, einem von YC unterstützten Unternehmen mit Fokus auf LLM-Kontextkomprimierung, arbeitet er mit Claude Code, Cursor und eigenen Agenten zusammen. Das Versprechen ist einfach: kein Warten mehr auf die Kompaktierung, denn die Zusammenfassung wurde bereits berechnet, während Sie weitergearbeitet haben.
Über Context Gateway
Was ist Context Gateway
Context Gateway ist ein lokaler Proxy für alle, die lange KI-Coding-Sitzungen fahren. Er installiert sich als kleines Binary und leitet dann den Verkehr Ihres Agenten auf dem Weg zur LLM-API durch sich selbst. Wird das Gespräch lang genug, komprimiert er den älteren Verlauf im Hintergrund, lange bevor dem Modell der Platz ausgeht.
Das Problem, das er angeht, kennen alle, die den ganzen Tag in Claude Code oder Cursor arbeiten. Sitzungen kriechen nahe der Kontextgrenze dahin, und das Tool hält an, um zusammenzufassen, ehe es weitergeht. Context Gateway nimmt diese Arbeit vom kritischen Pfad. Beim Überschreiten der Schwelle liegt die Kompaktierung schon bereit. Die Verwaltung des Kontextfensters ist keine Pflicht mehr, auf die man wartet.
Der Haken: Es ist noch ein Entwicklungswerkzeug aus einer frühen Phase. Sie installieren es über die Kommandozeile, wählen ein Zusammenfassungsmodell und hinterlegen einen API-Schlüssel, und Sie stellen die Auslöseschwelle selbst ein. Was bekommen Sie also für diese Einrichtungsarbeit? Ein wenig Montage ist nötig.
Erste Schritte
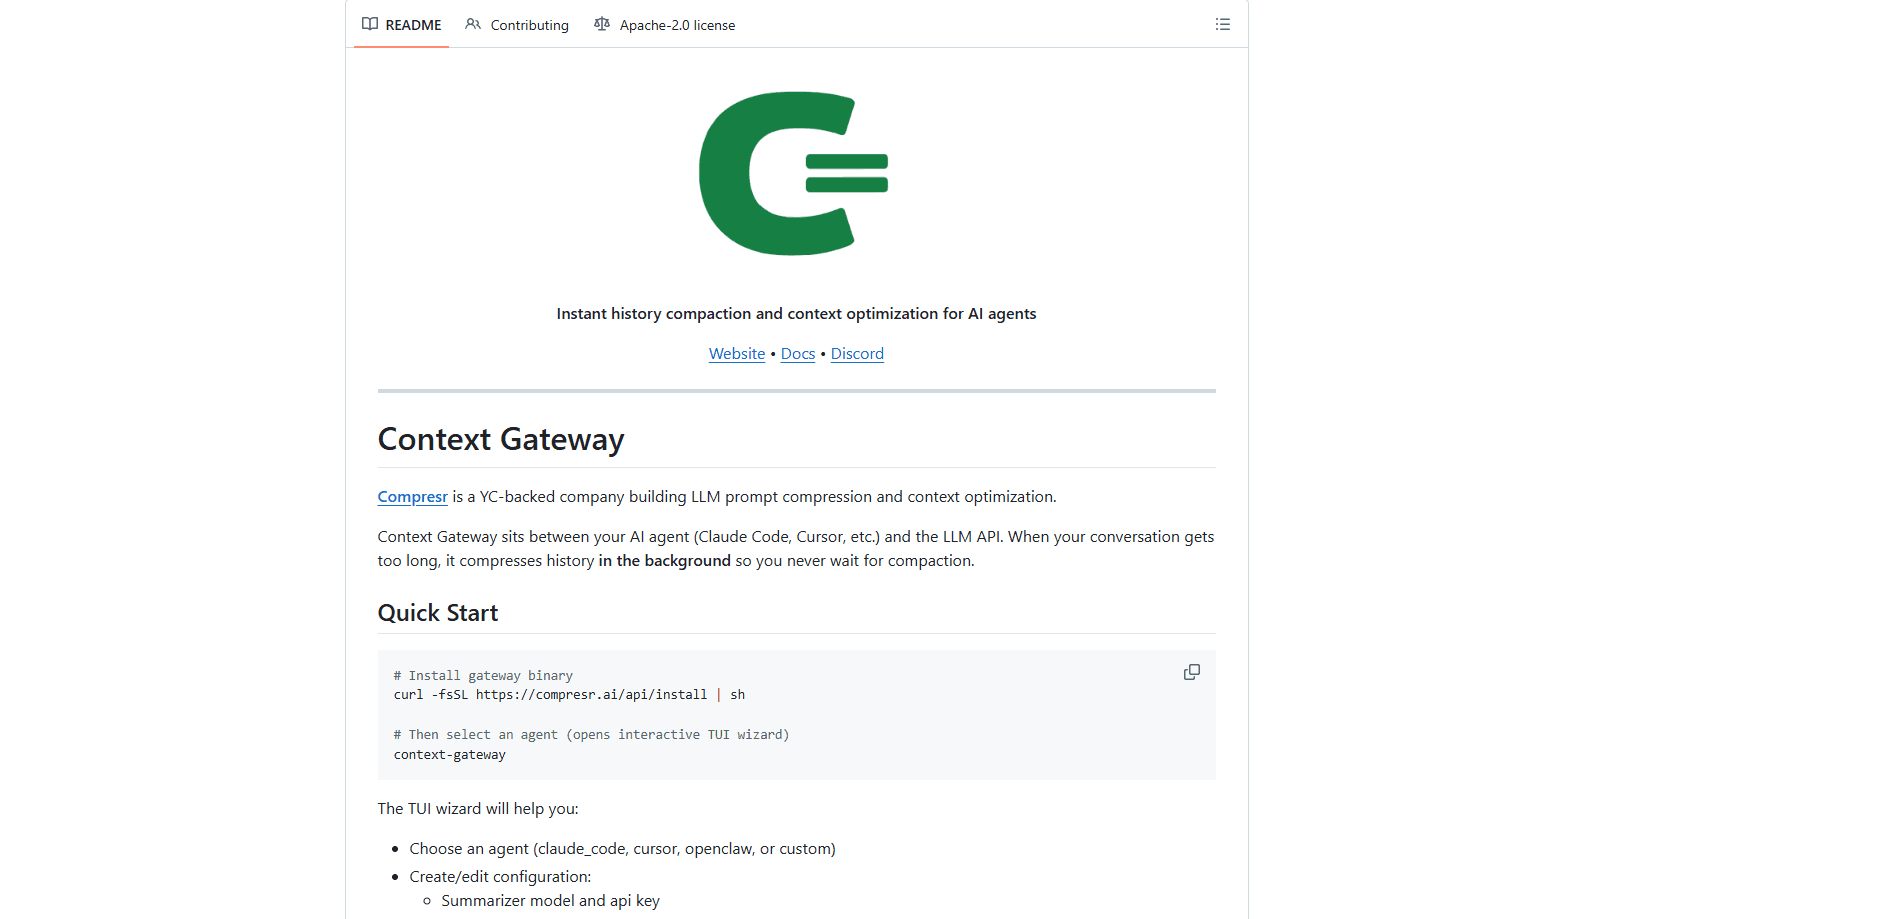
- Führen Sie das Installationsskript aus, um das Binary des Gateways zu holen:
curl -fsSL https://compresr.ai/api/install | sh. - Starten Sie es mit dem Befehl
context-gateway, der einen interaktiven Einrichtungsassistenten öffnet. - Wählen Sie Ihren Agenten aus der Liste:
claude_code,cursor,openclawodercustomfür eine eigene Konfiguration. - Legen Sie Ihr Zusammenfassungsmodell, den API-Schlüssel und die Auslöseschwelle der Komprimierung fest (75 % ist die Voreinstellung).
- Optional schalten Sie Slack-Benachrichtigungen ein und prüfen dann
logs/history_compaction.jsonl, um zu sehen, was komprimiert wird.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Context Gateway.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler mit langen Claude Code- oder Cursor-Sitzungen
- KI-Teams, die Agenten in Produktion bringen
- Kostensensible Entwickler mit großen Codebasen
Aufgaben
- Mehrstündige Coding-Sitzungen im Kontextfenster halten
- Abgerufene Abschnitte in einer RAG-Pipeline komprimieren
- Laute Tool-Ausgaben kürzen
Szenarien
- Ein langes Refactoring, bei dem das Gespräch stetig wächst und Sie den Agenten nicht neu starten wollen.
- Analyse juristischer, medizinischer oder finanzieller Dokumente, bei der eine einzige Frage auf dichtem Quellmaterial aufsetzt.
- Jeder Workflow, der regelmäßig an die Grenze des Kontextfensters stößt und für Tokens zahlt, die das Modell nie liest.
Wichtigste Funktionen
Verlaufskompaktierung im Hintergrund
Hier zählt das Timing. Statt zu warten, bis das Gespräch die Grenze erreicht, und dann zum Zusammenfassen anzuhalten, berechnet Context Gateway die Zusammenfassung im Hintergrund vor, während die Sitzung wächst. Überschreiten Sie die Schwelle, ist die Kompaktierung sofort fertig, weil die Arbeit bereits getan ist. Wer schon erlebt hat, wie ein Coding-Agent mitten in der Aufgabe einfriert, für den ist genau dieser Wechsel der Kern. Schluss mit dem Blick auf den drehenden Kreis.
Funktioniert mit den wichtigsten KI-Coding-Agenten
Der Assistent bringt Voreinstellungen für claude_code und cursor mit, die zwei gängigsten KI-Coding-Umgebungen, dazu openclaw und eine Option custom für Ihre eigene Konfiguration. Sie schreiben Ihren Agenten nicht um, um ihn zu nutzen. Die KI-Kontextkomprimierung läuft als Proxy vor der LLM-API, und Ihre bestehenden Werkzeuge bleiben, wo sie sind.
Anfragebewusste Komprimierung
Unter dem Gateway sitzt die Komprimierungs-API von Compresr, die Ihren Kontext gegen die tatsächliche Anfrage bewertet. Das ist LLM-Kontextoptimierung richtig gemacht. Sie behält die Spannen, die die Antwort tragen, und lässt den Rest fallen, statt blind zu komprimieren. Der eigene Benchmark des Unternehmens auf FinanceBench behauptet, dass die Genauigkeit bei leichter Komprimierung hält und sich sogar verbessern kann. Diese Zahlen stammen vom Anbieter, also behandeln Sie sie als Marketing, bis unabhängige Ergebnisse vorliegen.
Konfigurierbare Auslöseschwelle
Die Komprimierungsschwelle liegt standardmäßig bei 75 % des Kontextfensters, doch Sie setzen sie selbst in der Einrichtung. Senken Sie sie, wenn Sie lieber früh komprimieren und weit von der Grenze wegbleiben. Heben Sie sie an, wenn Sie mehr rohen Verlauf behalten wollen. Slack-Benachrichtigungen können Sie anpingen, wenn ein Komprimierungsereignis auslöst.
Sichtbare Protokolle
Jede Kompaktierung wird in logs/history_compaction.jsonl geschrieben, sodass Sie prüfen können, was wann komprimiert wurde. Diese Transparenz zählt, wenn Sie einem Werkzeug zutrauen, Ihren Gesprächsverlauf still umzuschreiben. Sieht die Ausgabe falsch aus, haben Sie ein Protokoll zum Nachsehen. Auf anderem Wege sollte man es besser nicht erfahren.
Gehostetes SDK und Vor-Ort-Betrieb
Über das Gateway hinaus bietet Compresr eine Prompt-Komprimierungs-API als gehostetes SDK, mit TypeScript- und Python-Clients und einem Preis pro Million Tokens. Eine Vor-Ort-Variante läuft in Ihrem eigenen VPC, wenn Ihre Daten das Netzwerk nicht verlassen dürfen. Der Vor-Ort-Weg kommt mit eigenen SLAs für Durchsatz und Latenz sowie dediziertem Support.
Vor- und Nachteile
Vorteile
- Die sofortige Kompaktierung beseitigt die Pause, die lange Agenten-Sitzungen unterbricht.
- Voreinstellungen für Claude Code, Cursor und openclaw sorgen für schnelle Einrichtung, ohne Codeänderungen.
- Jede Kompaktierung wird protokolliert, sodass Sie nachvollziehen können, was umgeschrieben wurde.
- Die anfragebewusste Komprimierung zielt auf die Tokens, die zählen, nicht auf einen blinden Schnitt.
- Gratis-Guthaben bei der Anmeldung lassen Sie die API ohne Kreditkarte testen.
Nachteile
- Es braucht eine Terminal-Installation und einen API-Schlüssel für das Zusammenfassungsmodell, ist also keine Klick-und-lauf-App.
- Die Komprimierung kann Kontext verwerfen, den das Modell später braucht, und Sie merken es nicht immer, bevor eine Antwort schiefgeht.
- Die Benchmark-Angaben stammen vom Anbieter und sind nicht unabhängig geprüft.
- Der Vor-Ort-Betrieb bedeutet ein Gespräch mit dem Vertrieb statt einer Anmeldung.
Häufige Fragen
Es ist ein Proxy, der zwischen Ihrem KI-Agenten und der LLM-API sitzt. Wird das Gespräch lang, komprimiert er den älteren Verlauf im Hintergrund, damit die Sitzung nie wartend auf eine Zusammenfassung an der Kontextgrenze hängt.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Context Gateway.
Alternativen zu Context Gateway
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.