
Custom Vision
Microsoft · Bilder
Custom Vision ist der Bilderkennungsdienst von Microsoft Azure. Sie laden beschriftete Fotos hoch, trainieren einen Klassifizierer oder Detektor und rufen ihn per API auf oder exportieren ihn für den Offline-Betrieb.
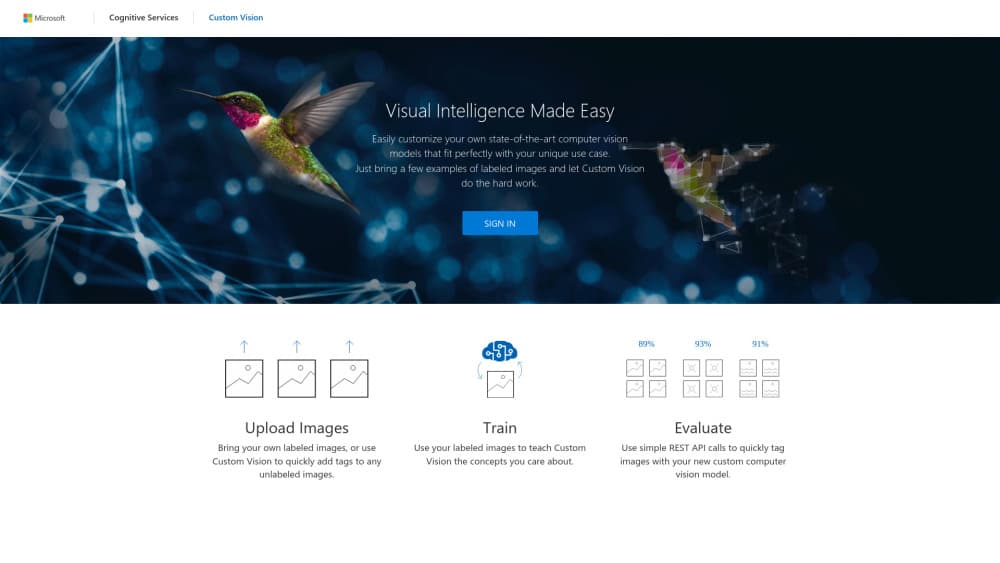
Über Custom Vision
What Is Custom Vision
Custom Vision ist der verwaltete Dienst von Microsoft, mit dem Sie einen Bilderkennungsdienst auf Basis eigener Daten aufbauen. Sie liefern die Fotos, versehen sie mit den Labels, die Sie brauchen, und die Plattform trainiert einen eigenen Bild-Identifikator, der neue Bilder gegen diese Labels bewertet. Zwei Projekttypen decken das Meiste ab: Klassifizierung, bei der ein Foto ein Label oder mehrere bekommt, und Objekterkennung, bei der das Modell zusätzlich einen Rahmen um jedes gefundene Objekt liefert.
Die Arbeit läuft im Browserportal customvision.ai oder über SDKs und die REST-API, wenn Sie die Kette lieber per Skript steuern. Das Training läuft auf Azure-Rechenleistung, die Sie stundenweise zahlen, und Vorhersagen gehen an eine getrennte Ressource. Ein stark ausgelasteter Produktionsendpunkt konkurriert deshalb nicht mit Ihren Tests. Modelle aus einer kompakten Domäne lassen sich auf ein Handy, eine Kamera oder einen lokalen Server exportieren, und genau das ist für viele Teams der Grund, den Dienst einer reinen Cloud-API vorzuziehen.
Der Haken ist der Termin. Microsoft hat das Ende von Azure Custom Vision angekündigt und unterstützt bestehende Kunden bis zum 25. September 2028. Die Frist ist lang, doch jedes neue Projekt zum Training von Computer-Vision-Modellen sollte vorher den Migrationsweg prüfen. Die Genauigkeit ist die zweite praktische Grenze: Hundert saubere, gut beschriftete Bilder schlagen oft tausend nachlässige, und ein Modell aus Studiofotos scheitert an verwackelten Aufnahmen vom Einsatzort.
Getting Started
- Legen Sie im Azure-Portal eine Trainingsressource für Custom Vision an und wählen Sie eine Region nahe Ihren Daten.
- Öffnen Sie customvision.ai, erstellen Sie ein Klassifizierungs- oder Erkennungsprojekt und wählen Sie eine Domäne.
- Laden Sie Bilder hoch und beschriften Sie sie, mit mindestens 15 bis 30 Beispielen pro Label vor dem ersten Training.
- Trainieren Sie, prüfen Sie Precision und Recall pro Label und passen Sie Labels an oder ergänzen Sie Bilder, bevor Sie erneut trainieren.
- Veröffentlichen Sie die Iteration auf einer Vorhersageressource und rufen Sie den Endpunkt aus Ihrer Anwendung auf.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Custom Vision.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler, die eine Bildsortierung in eine bestehende App einbauen
- Betriebsteams kleiner Fabriken
- Katalog- und Handelsmitarbeiter
Aufgaben
- Uploads von Nutzern nach Inhalt sortieren
- Prüfen, ob ein Bauteil vorhanden ist
- Den sichtbaren Zustand einer festen Kamera auslesen
- Eine Bildidee in einer Woche testen
Szenarien
- Eine Prüf-App im Außendienst, die ohne Netz funktionieren muss
- Ein Supportablauf, der Screenshots nach Typ verteilt
- Ein Pilot vor dem großen Ausbau
Wichtigste Funktionen
Bildklassifizierung mit eigenen Labels
Sie legen die Labels fest, das Bildklassifizierungsmodell lernt ihr Aussehen. Multiklassen-Projekte vergeben ein einziges Label pro Bild, Multilabel-Projekte erlauben mehrere gleichzeitig, was bei Fotos mit mehreren relevanten Dingen hilft. Nach dem Training kommt jede Vorhersage mit einer Wahrscheinlichkeit pro Label, und Ihr Code setzt die Grenze.
Objekterkennung mit Begrenzungsrahmen
Erkennungsprojekte liefern die Position jedes Vorkommens eines Labels, nicht nur sein Vorhandensein. Das zählt beim Stückzählen, beim Prüfen einer Position am Fließband oder beim Ausschneiden eines Bereichs für den nächsten Schritt. Sie zeichnen die Rahmen im Portal, und das trainierte Objekterkennungsmodell meldet Koordinaten und Konfidenz für jeden Treffer.
Vorgefertigte Domänen für schnelleres Training
Statt bei einem leeren allgemeinen Modell zu beginnen, wählen Sie eine Domäne für einen Inhaltsbereich: Essen, Sehenswürdigkeiten, Handel oder eine kompakte Variante für den Export. Ein näherer Startpunkt bedeutet meist weniger Bilder bis zu brauchbarer Genauigkeit. Der Preis dafür: Kompakte Domänen begrenzen die Modellgröße und erreichen nicht die Genauigkeit einer vollen Cloud-Domäne.
Iterationen, Kennzahlen und Schwellenwerte
Jedes Training wird zu einer benannten Iteration, die Sie vergleichen können. Das Portal zeigt Precision, Recall und mittlere Precision pro Label, und Sie setzen für jedes Label einen Wahrscheinlichkeitsschwellenwert, um Fehlalarme gegen übersehene Objekte abzuwägen. Das Veröffentlichen ist ein eigener Schritt, ein misslungener Versuch berührt den aktiven Endpunkt also nie.
Export an den Rand und in Container
Modelle aus kompakten Domänen gehen als TensorFlow, CoreML, ONNX oder Docker-Image für Linux und Windows hinaus. So läuft ein eigener Bild-Identifikator offline auf einem Handy, einem Raspberry Pi oder einem Industrie-PC. Exportierte Modelle senden nichts nach außen, was hilft, wenn Daten den Standort nicht verlassen dürfen.
Portal, SDKs und REST-API
Das Webportal deckt Beschriften, Training und Tests ohne Code ab. Für wiederholbare Abläufe erledigen die REST-API und Clientbibliotheken für .NET, Python, Java und Node.js dieselben Schritte per Programm. Training und Vorhersage liegen in getrennten Azure-Ressourcen, Sie können Versuche also in einer günstigen Region halten und den Verkehr aus der Region nahe Ihrer Nutzer bedienen.
Vor- und Nachteile
Vorteile
- Sie kommen von beschrifteten Fotos zu einem laufenden Endpunkt, ohne Trainingscode zu schreiben.
- Die kostenlose Stufe umfasst 2 Projekte, 1 Stunde Training pro Monat und 10.000 Vorhersagen.
- Kompakte Modelle lassen sich nach CoreML, ONNX, TensorFlow und Docker für Offline-Inferenz exportieren.
- Trainings- und Vorhersageressourcen werden getrennt abgerechnet, ruhende Versuche kosten daher wenig.
- Abrechnung, Zugriffskontrolle und Monitoring bleiben im Azure-Abo, das Sie ohnehin nutzen.
Nachteile
- Microsoft stellt den Dienst am 25. September 2028 ein, jede Installation braucht also einen Migrationsplan.
- Die Genauigkeit bricht bei kleinen oder uneinheitlichen Labelsätzen ein, und das zu beheben kostet mehr manuelle Beschriftung.
- Der Export klappt nur mit kompakten Domänen, die gegenüber vollen Cloud-Modellen etwas Genauigkeit abgeben.
- Die Vorhersagekosten wachsen mit dem Verkehr bei 2 USD pro 1.000 Transaktionen, was bei viel genutzten Apps ins Gewicht fällt.
Häufige Fragen
Es trainiert Bildmodelle auf Ihren eigenen beschrifteten Fotos. Typische Einsätze sind das Sortieren von Produktbildern, das Melden von Fehlern an einer Produktionslinie, das Auslesen des Zustands einer festen Kamera und das Verteilen von Nutzer-Uploads nach Inhalt.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Custom Vision.
Alternativen zu Custom Vision

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

Tractionwave
TractionWave · Bilder · MarketingTractionWave erstellt per KI eine Aufmerksamkeits-Heatmap für statische Anzeigen. Sie laden ein PNG oder JPG hoch und bekommen prognostizierte Aufmerksamkeit, sortierte Hotspots und Korrekturen, bevor Budget fließt.

Imejis.io
Imejis.io · Bilder · MarketingImejis.io ist ein KI-Designstudio für Agenten und Marketingteams. Sie beschreiben ein Bild in eigenen Worten, und das Werkzeug schreibt den Text, baut das Layout, passt es an jedes Format an und exportiert die fertige Datei.