
EnergeticAI
EnergeticAI open-source project · Coding
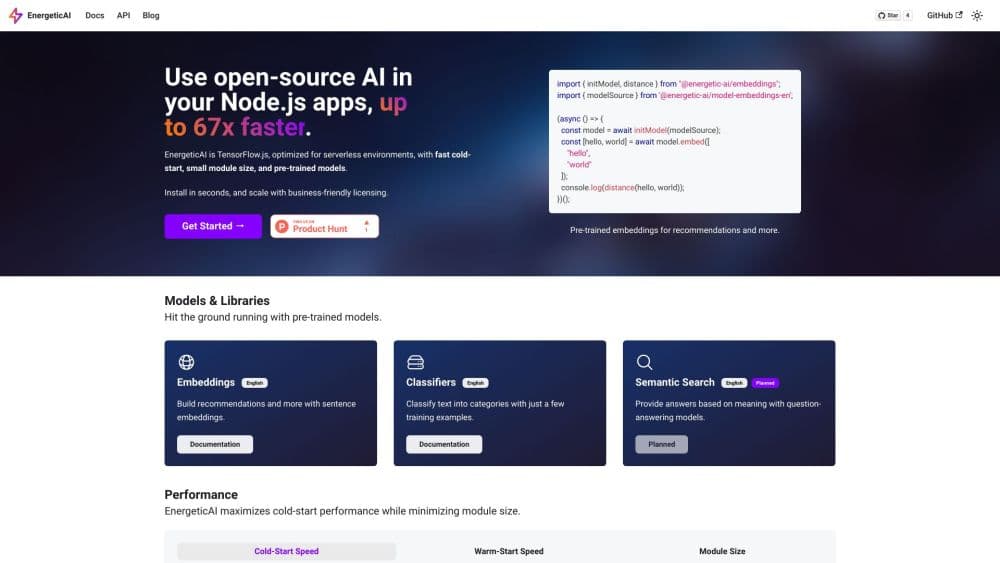
EnergeticAI ist eine Open-Source-Distribution von TensorFlow.js für Serverless-Funktionen: Ein Embeddings-Modell oder Textklassifikator antwortet nach einem Kaltstart von rund 50 ms.
Über EnergeticAI
What Is EnergeticAI
EnergeticAI ist eine abgespeckte Version von TensorFlow.js, zugeschnitten auf Serverless-Funktionen wie AWS Lambda, Vercel Functions oder Netlify Functions. Es löst ein sehr konkretes Deployment-Problem. Die Originalbibliothek belegt unkomprimiert 146 MB bis 513 MB, damit ist das Paketlimit oft schon gerissen, bevor Ihr Code überhaupt läuft. Dazu laden sich die Modellgewichte beim ersten Aufruf nach, was den Kaltstart über zwei Sekunden treibt.
Das Projekt behält nur, was für die Inferenz nötig ist. Das Modul landet bei etwa 3 MB, der Kaltstart bleibt nach der Messung des Teams nahe bei 50 ms, und das Kernpaket ersetzt @tensorflow/tfjs-core direkt. Vorhandener Code und bestehende Modelle laufen deshalb meist ohne Umbau.
Die Grenzen wiegen genauso schwer wie die Vorteile. Die vortrainierten Modelle decken nur englische Embeddings und Textklassifikation ab, die semantische Suche ist weiterhin als geplant markiert, und alles läuft über WebAssembly ohne GPU. Die npm-Version ist 0.2.0 von Juni 2023. Behandeln Sie das Projekt also als stabil, aber ruhend, nicht als wachsende Plattform.
Getting Started
- Installieren Sie Node 18 oder neuer und holen Sie das Kernpaket plus die gewünschte Modellbibliothek:
npm install @energetic-ai/core @energetic-ai/embeddings @energetic-ai/model-embeddings-en. - Importieren Sie
initModelaus der Modellbibliothek samt passender Quelle und laden Sie die Gewichte einmal pro Funktionsinstanz. - Rufen Sie
model.embed()mit einem Array von Strings auf, um Vektoren zu erzeugen, oder nutzen Sie das Klassifikator-Paket mit ein paar beschrifteten Beispielen. - Vergleichen Sie die Vektoren mit dem
distance-Helfer und geben Sie den Wert an Ihre Sortier-, Filter- oder Routing-Logik weiter. - Deployen Sie beim Serverless-Anbieter und prüfen Sie die Paketgröße, denn genau dieses Limit ist der Grund für den Wechsel zu EnergeticAI.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von EnergeticAI.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Node.js-Entwickler, die KI für Serverless suchen
- Soloentwickler und kleine Teams
- Teams mit strengen Datenregeln
- Backend-Entwickler mit dem ersten KI-Feature
Aufgaben
- Produktempfehlungen aus Embeddings bauen
- Support-Tickets oder Formulare mit einem Textklassifikator sortieren, der mit ein paar Dutzend beschrifteten Beispielen trainiert wurde.
- Feedback, Rezensionen oder doppelte Anzeigen über Vektorabstände gruppieren, statt Regeln für Schlüsselwörter zu schreiben.
- Eine leichte semantische Suche über einige hundert Dokumente legen, solange Sie akzeptieren, dass die speziellen Modelle dafür noch als geplant gelten.
Szenarien
- Auf einem kostenlosen oder günstigen Tarif mit hartem Paketdeckel deployen, wo ein 3-MB-Modul darüber entscheidet, ob der Rollout klappt.
- Inferenz auf Text fahren, der nicht an eine externe API gehen darf, etwa interne Tickets, klinische Notizen oder Kundendaten unter Vertrag.
- Ein KI-Feature auf dem Laptop prototypen und denselben Code nach Produktion schieben, ohne die Modellschicht auf das SDK eines Anbieters umzuschreiben.
Wichtigste Funktionen
Paketbau für Serverless
Das gesamte Projekt richtet sich an den Grenzen von Funktionsplattformen aus. Das Modul schrumpft auf rund 3 MB und passt damit in übliche Lambda- und Edge-Limits, die TensorFlow.js sprengt. Die Modellgewichte liegen im Paket statt beim ersten Aufruf nachgeladen zu werden, ein kalter Container wartet also nicht auf das Netz.
Kaltstart
Die Projektseite nennt bis zu 67-mal schnellere Inferenz als TensorFlow.js in Serverless-Funktionen, gemessen beim Initialisieren des Modells und beim Embedding eines Absatzes mit fünf Sätzen auf einem MacBook Pro mit M1 Max. Ihre Werte hängen von Anbieter und Eingabelänge ab. Die Richtung bleibt gleich: Zehntelsekunden statt Sekunden, und daran entscheidet sich, ob eine Anfrage in den Timeout läuft.
Vortrainiertes Embeddings-Modell
Das Embeddings-Paket wandelt Strings in Vektoren um, die Sie vergleichen, gruppieren oder sortieren können. Das englische Modell kommt als separates Gewichtspaket, Sie installieren also nur die Sprache, die Sie brauchen. Das ist der kürzeste Weg zu Empfehlungen und Textähnlichkeit ohne eigenes Training.
Textklassifikator mit wenigen Beispielen
Das Klassifikator-Paket trainiert zur Laufzeit mit einer kleinen Menge beschrifteter Beispiele. Für Routing und Tagging reicht das, wenn Sie 20 oder 50 Fälle haben und kein vollständiges Dataset. Die Labels liegen in Ihrem Repository, das Modell trainiert bei jedem Deployment neu, und das Verhalten bleibt so zusammen mit dem Code versioniert.
Direkte TensorFlow.js-Kompatibilität
Das Kernmodul bildet die API von @tensorflow/tfjs-core nach, vorhandene Imports und Modellcode funktionieren also meist weiter. Sie können einen einzelnen Endpoint testen, bevor der ganze Dienst umgestellt wird, was den Umstieg günstig macht.
WebAssembly-Backend
Die Inferenz läuft über WebAssembly, schnell genug für kurze Eingaben und auf jedem Node-Host ohne native Build-Schritte verfügbar. Eine GPU-Beschleunigung fehlt, große Stapel und lange Dokumente brauchen deshalb deutlich länger als auf einer Maschine mit CUDA.
Vor- und Nachteile
Vorteile
- Senkt die Paketgröße von mehreren hundert Megabyte auf etwa 3 MB, oft die einzige Möglichkeit, ein Modell in einem Serverless-Tarif zu deployen.
- Der Kaltstart liegt in der Projektmessung nahe 50 ms, die Nutzeranfrage hängt also nicht am Modellladen.
- Apache-2.0-Lizenz und vortrainierte Modelle unter ähnlichen Bedingungen, was den kommerziellen Einsatz unkompliziert hält.
- Keine Kosten pro Aufruf und keine Daten außerhalb Ihrer Funktion, ein echter Unterschied zu gehosteten Embedding-APIs.
- Das Kernpaket fügt sich in bestehenden TensorFlow.js-Code ein, die Migration ist meist ein Pakettausch.
Nachteile
- Die vortrainierten Modelle gibt es nur auf Englisch, mehrsprachige Produkte brauchen eigene Gewichte und zusätzliche Tests.
- Ohne GPU laufen große Stapel langsamer, und ein langer Dokumentensatz kann pro Anfrage Sekunden brauchen.
- Der Katalog ist dünn: Embeddings und Klassifikatoren sind da, die semantische Suche steht weiter auf geplant.
- Auf npm steht Version 0.2.0 von Juni 2023, Sie übernehmen also ein Projekt mit langsamem Release-Takt: Versionen fixieren und bei Fehlern den Quellcode lesen.
Häufige Fragen
Es führt Open-Source-KI-Modelle in Serverless-Funktionen aus. Typische Einsätze sind Produktempfehlungen, Textklassifikation, Duplikaterkennung und semantische Suche in Node.js-Backends, die keinen vollständigen Machine-Learning-Stack ausliefern können.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu EnergeticAI.
Alternativen zu EnergeticAI

Udon
Udon · Coding · ProduktivitätUdon macht aus einem Apple-Silicon-Mac einen Heimserver, den Sie im Browser steuern, mit Containern, Dateifreigaben und einem optionalen KI-Systemadministrator.

offstage
offstage cloud · Coding · Produktivitätoffstage gibt KI-Agenten und CI-Jobs einen echten Mac: ein frisches macOS-27-Konto auf Apple Silicon, per API gesteuert und sekundengenau abgerechnet.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Coding · ProduktivitätMit BotBus lassen sich KI-Agenten vom Smartphone steuern, auch wenn der Rechner im Büro steht: Befehle freigeben, Aufgaben starten, Ergebnisse lesen.