
Exla FLOPs
Exla · Coding · Sonstiges
Exla FLOPs ist ein GPU-Cluster-Dienst auf Abruf von Exla, der Multi-Node-NVIDIA-Cluster in Minuten startet und minutenweise abrechnet, mit Hardware der Klassen H100, H200 und A100.
Über Exla FLOPs
What Is Exla FLOPs
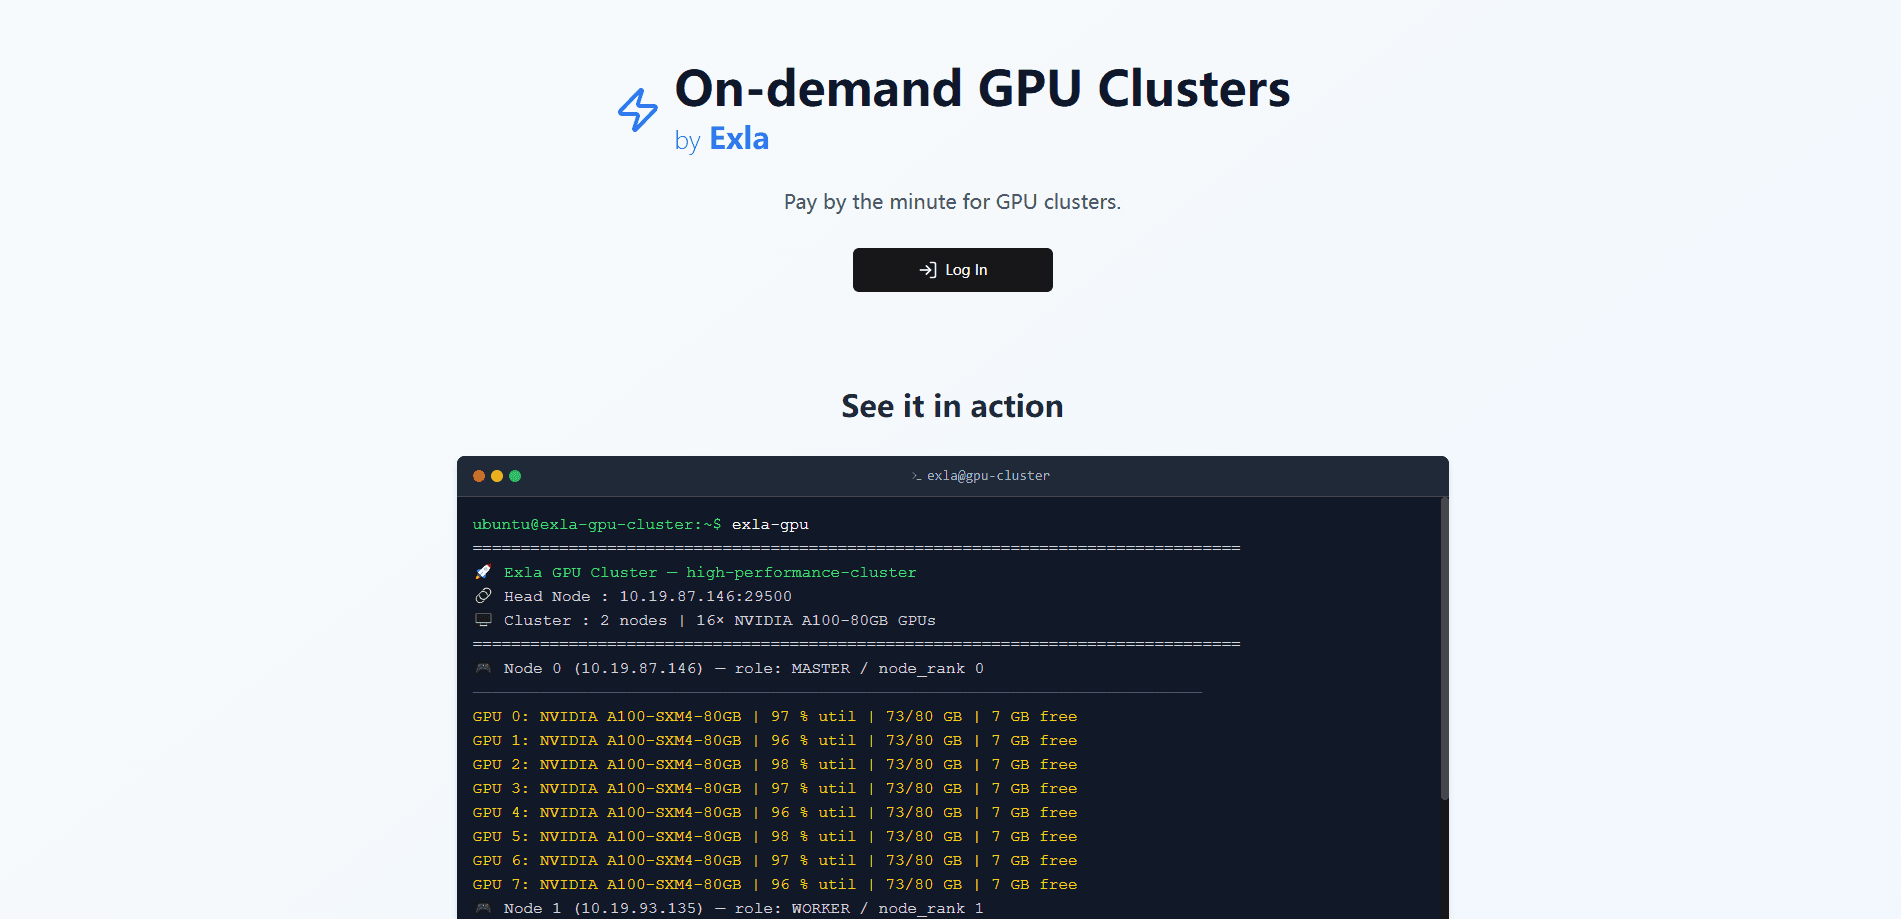
Exla FLOPs ist ein Dienst zum Mieten von GPU-Clustern auf Abruf, entwickelt von Exla, einem Y-Combinator-Unternehmen der Winter-2025-Kohorte. Sie wählen die GPU-Modelle, legen die Anzahl fest und haben in wenigen Minuten ein Multi-Node-Cluster mit SSH-Zugang. Keine Reservierung, kein Vertriebsanruf, keine Mindestlaufzeit, was zu Teams passt, die Trainingskapazität jetzt brauchen und nicht im nächsten Monat.
Das Problem dahinter ist der Zugang. Einen großen Block H100 zu bekommen heißt meist, auf das Vertriebsteam eines Cloud-Anbieters zu warten oder einen Vertrag zu unterschreiben, und genau diese Warteschlange bremst ein Experiment schon vor dem Start. Exla FLOPs nimmt die Warteschlange heraus, indem Cluster online bleiben und minutenweise abgerechnet wird, sodass ein Stoß von 16 oder 128 GPUs sich wie ein Wasserhahn auf- und zudrehen lässt.
Die Grenzen sollte man vorher kennen. Die Cluster laufen auf echter NVIDIA-Rechenzentrumshardware, und die Verfügbarkeit ist geschätzt und kann sich ändern, ein gefragter GPU-Typ kann also belegt sein, wenn Sie ihn brauchen. Sie zahlen außerdem minutenweise auf laufender Hardware, also kostet ein untätiges Cluster weiter Geld, bis Sie es beenden. Der Zugang läuft über SSH, was zu Leuten passt, die sich in einem Terminal oder mit einer API auskennen, und nicht zu einem verwalteten Notebook.
Getting Started
- Melden Sie sich im Exla-FLOPs-Dashboard an und laden Sie Ihr Guthaben auf, denn ein Cluster-Start erfordert ein Guthaben für mindestens eine Stunde Nutzung.
- Registrieren Sie einen öffentlichen SSH-Schlüssel, um sich mit den Knoten zu verbinden, sobald sie starten.
- Wählen Sie GPU-Modelle und Stückzahlen und starten Sie das Cluster. Exla verspricht, dass Sie in unter fünf Minuten trainieren können.
- Verbinden Sie sich per SSH oder fahren Sie dieselben Schritte im Code mit einem API-Schlüssel, und beenden Sie das Cluster, wenn Ihr Job fertig ist, um den Zähler zu stoppen.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Exla FLOPs.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- ML-Ingenieure mit Trainingsläufen
- Forschungslabore mit knappem Budget
- Startups mit Bedarf an Lastspitzen
- Plattform- und MLOps-Teams
Aufgaben
- Feinabstimmung eines großen Modells
- Verteiltes Training
- Kurze Inferenz- oder Benchmarktasks
Szenarien
- Zeitdruck vor einer Konferenz
- Ein Modell auf fremder Hardware testen
- Eine Nachfragespitze
Wichtigste Funktionen
Sofortige Multi-Node-Cluster
Exla FLOPs ist auf Geschwindigkeit ausgelegt. Sie stellen ein Cluster aus einem oder mehreren Knoten zusammen und starten es in Minuten, und die Seite verspricht Training in unter fünf Minuten ab dem Login. Für Teams, die Wochen auf Kapazität warten, ist genau dieser Wechsel der Punkt.
Abrechnung nach Minuten
Die Abrechnung läuft minutenweise auf der tatsächlich genutzten Rechenzeit, und ein beendetes Cluster stoppt den Zähler sofort. Es gibt kein Minimum und keine Gebühr für untätige Reserven, was kurze Experimente günstig und lange berechenbar macht. Sie laden Guthaben auf, und der Betrag muss vor dem Start mindestens eine Stunde abdecken.
GPU-Typen kombinieren
Ein einzelnes Cluster kann verschiedene GPU-Typen und Knotenzahlen verbinden, sodass Sie teure H100 mit günstigeren Karten mischen können, wo die Last es zulässt. Die Seite warnt, dass gemischte Architekturen Leistung und Genauigkeit beeinflussen können, es ist also ein Werkzeug für Lasten, die das verkraften, nicht die Standardwahl.
Verteiltes Training über SSH-Knoten
Jeder Knoten kommt mit vorbereitetem NCCL, Treibern und Ihren SSH-Schlüsseln, sodass der Aufbau verteilten Trainings nicht erst einen Tag Bereitstellung kostet. Sie registrieren einen öffentlichen Schlüssel einmal im Dashboard und nutzen ihn clusterübergreifend weiter.
Dedizierte, isolierte Knoten
Jedes Cluster erhält dedizierte Knoten mit privaten Verbindungen, sodass Ihre Gewichte und Daten sich nie eine Maschine mit einem anderen Kunden teilen. Die Seite behandelt diese Isolation als Standard und nicht als Zusatz, was zählt, wenn Sie mit eigenen Daten trainieren.
API- und Dashboard-Zugang
Über das Dashboard hinaus können Sie API-Schlüssel anlegen und Cluster aus Code oder einer CI-Pipeline starten oder abbauen. Die Dokumentation listet die Endpunkte für Menschen wie für Coding-Agenten, und ein öffentlicher Endpunkt für GPU-Typen liefert Preise und Kapazität in Echtzeit.
Reale Kapazität über GPU-Typen hinweg
Der Dienst reicht von Hardware der Klassen H100 SXM5, H200, A100 SXM, L40S, RTX 4090, RTX 5090 und A6000, wobei die Verfügbarkeit als Schätzung angezeigt wird. Die breite Abdeckung sorgt dafür, dass Sie oft eine passende Karte finden, auch wenn ein Top-Modell belegt ist.
Vor- und Nachteile
Vorteile
- Cluster starten in Minuten ohne Reservierung und ohne Vertriebsanruf, was die Wartezeit nimmt, die einen Lauf sonst blockiert.
- Die minutenweise Abrechnung ohne Minimum macht kurze Jobs günstig und stoppt den Zähler sofort beim Beenden.
- Multi-Node-Cluster kommen mit NCCL, Treibern und SSH-Schlüsseln bereit, was manuelle Bereitstellung spart.
- Dedizierte Knoten und private Verbindungen halten Ihre Trainingsdaten von geteilter Hardware fern.
- Eine API und ein öffentlicher Preis-Endpunkt lassen CI und Coding-Agenten Cluster programmatisch starten.
- Die Abdeckung reicht vom H100 und H200 bis zu L40S und RTX, sodass Sie die Hardware dem Job anpassen können.
Nachteile
- Es gibt kein Gratisangebot, und Sie müssen vor dem Start Guthaben einzahlen, ein Test des Dienstes kostet also trotzdem Geld.
- Die Verfügbarkeit ist eine Schätzung und kann sich ändern, ein Top-GPU-Typ kann also fehlen, wenn Sie ihn brauchen.
- Untätige Cluster werden weiter abgerechnet, bis Sie sie beenden, wer eines laufen lässt, verbraucht also Budget.
- Der Zugang läuft zuerst über SSH und API, ohne verwaltetes Notebook, was die Hürde für weniger technische Nutzer erhöht.
Häufige Fragen
Exla FLOPs ist ein GPU-Cluster-Dienst auf Abruf von Exla, einem Y-Combinator-Unternehmen der Winter-2025-Kohorte. Sie starten Multi-Node-NVIDIA-Cluster in Minuten und zahlen minutenweise, für Training, Feinabstimmung und andere rechenintensive Jobs.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Exla FLOPs.
Alternativen zu Exla FLOPs

Udon
Udon · Coding · ProduktivitätUdon macht aus einem Apple-Silicon-Mac einen Heimserver, den Sie im Browser steuern, mit Containern, Dateifreigaben und einem optionalen KI-Systemadministrator.

offstage
offstage cloud · Coding · Produktivitätoffstage gibt KI-Agenten und CI-Jobs einen echten Mac: ein frisches macOS-27-Konto auf Apple Silicon, per API gesteuert und sekundengenau abgerechnet.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Coding · ProduktivitätMit BotBus lassen sich KI-Agenten vom Smartphone steuern, auch wenn der Rechner im Büro steht: Befehle freigeben, Aufgaben starten, Ergebnisse lesen.