
extract by Firecrawl
Firecrawl · Coding
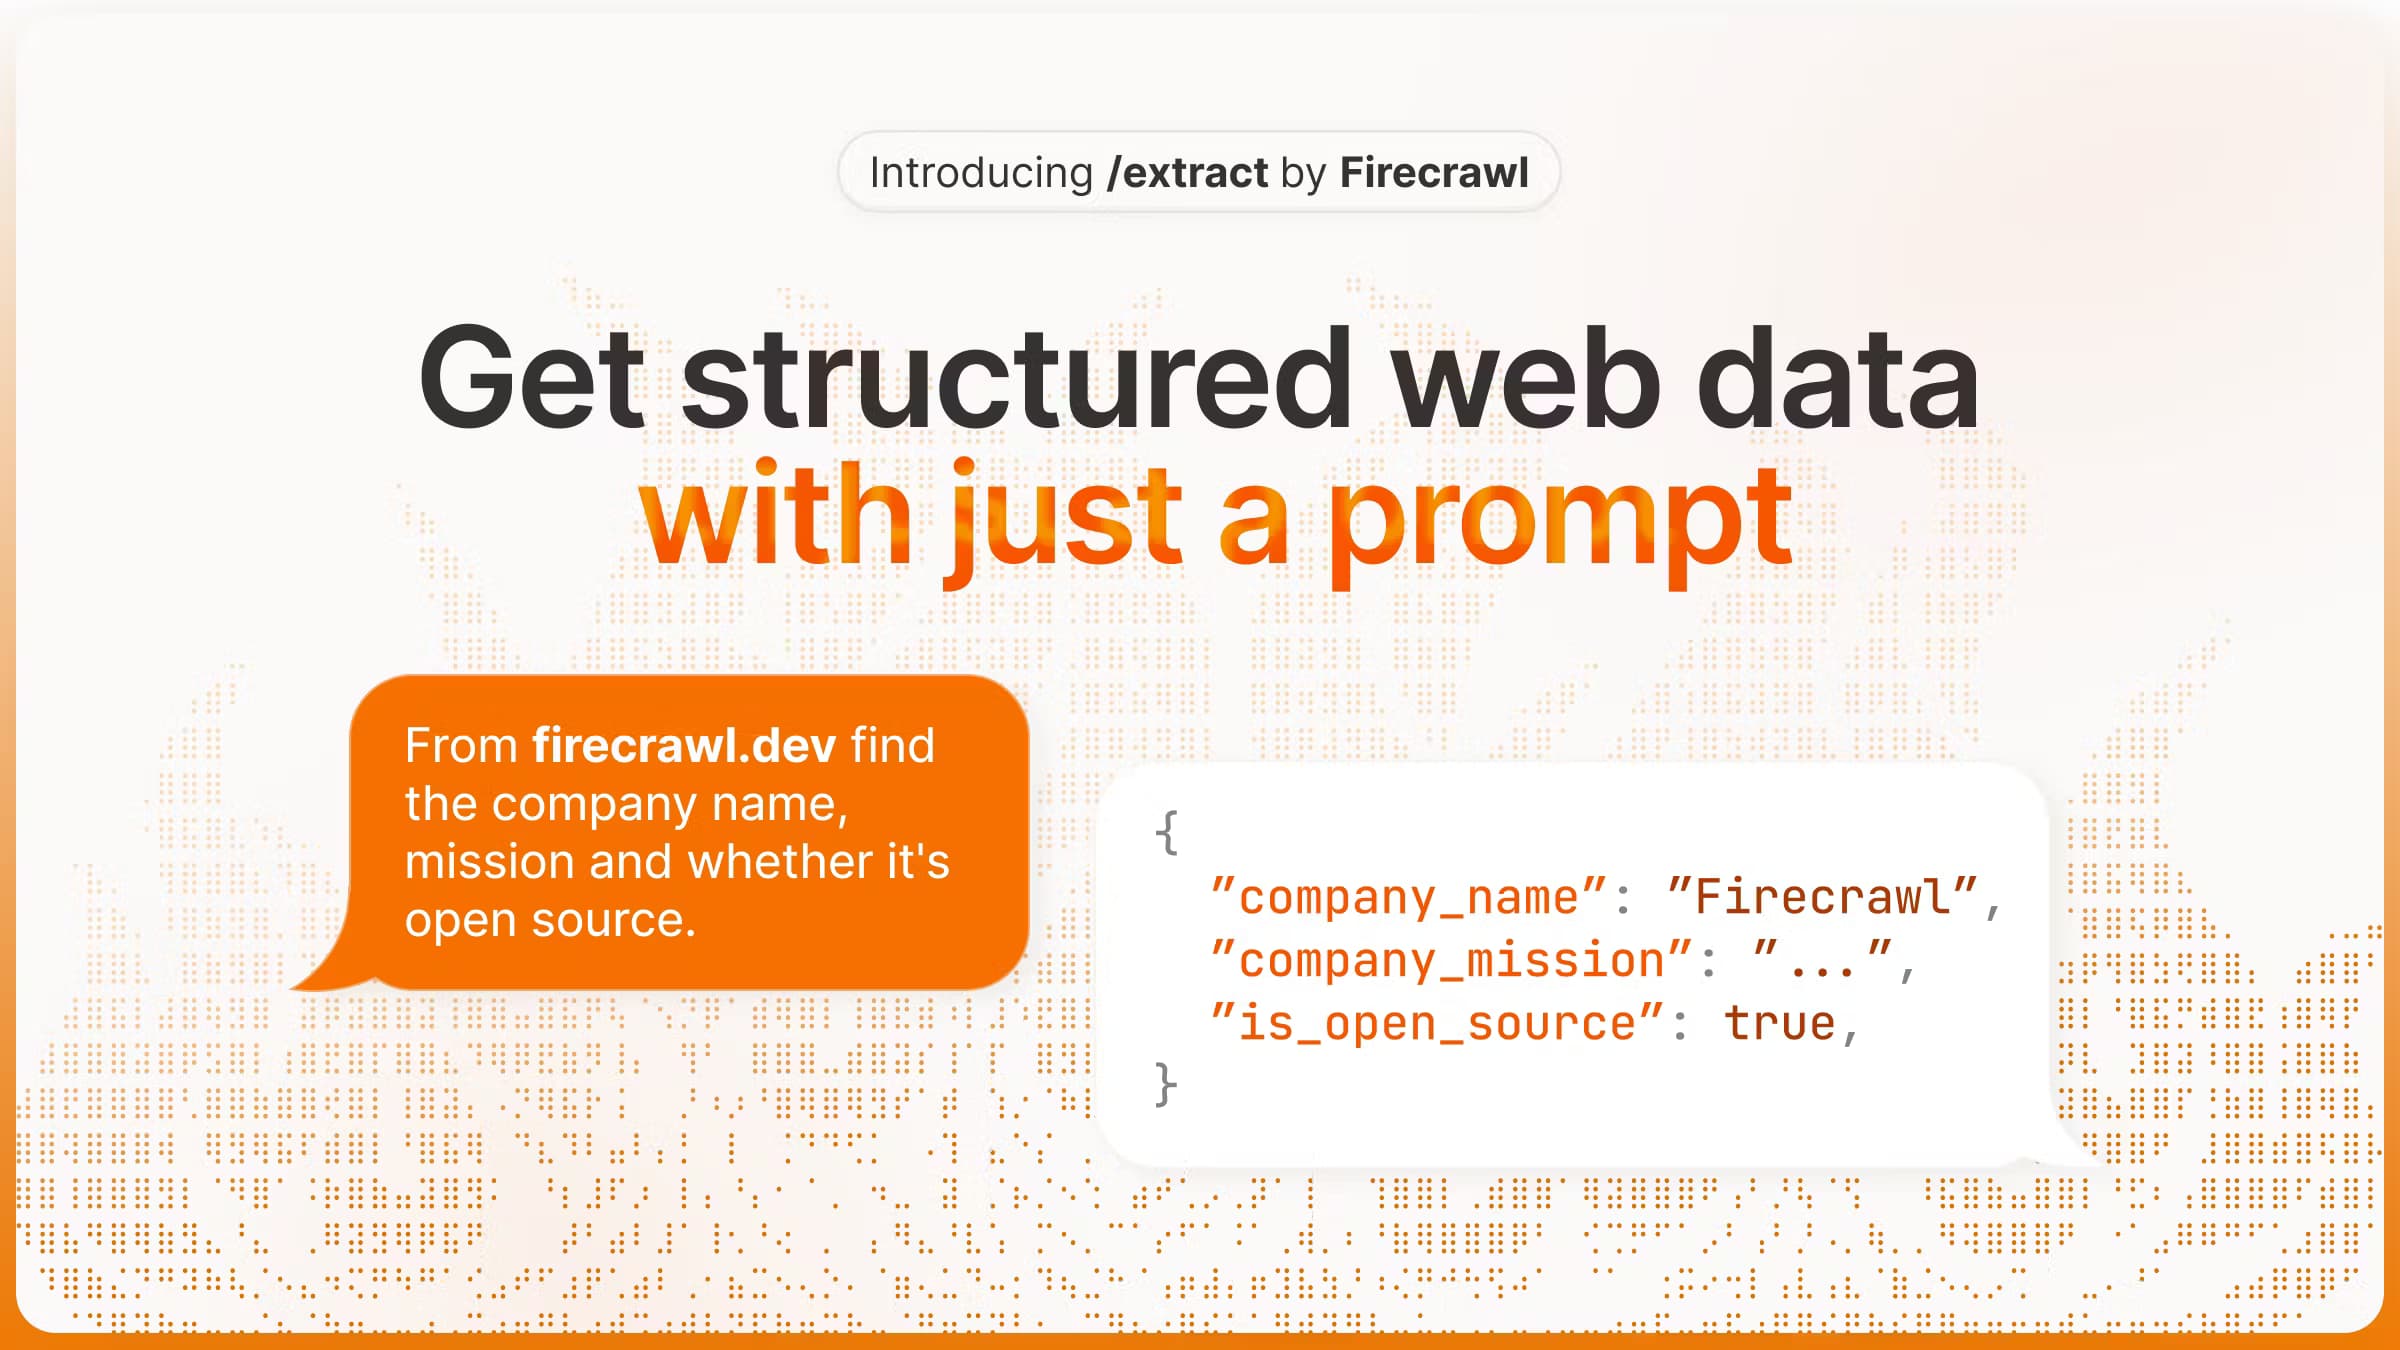
extract by Firecrawl ist der Endpoint der Firecrawl-API, der jede URL oder eine ganze Domain in strukturiertes JSON verwandelt. Sie geben Links plus einen Prompt oder ein Schema an, und er liefert die gewünschten Felder zurück.
Über extract by Firecrawl
What Is extract by Firecrawl
extract by Firecrawl ist der Endpoint /extract von Firecrawl, einer Web-Data-API für KI-Anwendungen. Er scrapt die Seiten, auf die Sie ihn richten, und zieht dann mit einem Sprachmodell bestimmte Felder als JSON heraus. Statt für jede Seite Selektoren von Hand zu schreiben, beschreiben Sie die Daten in Worten oder übergeben ein JSON-Schema, und Firecrawl liefert die Werte schon sortiert.
Der Endpoint erledigt die unangenehmen Teile des Web-Scrapings: JavaScript-lastige Seiten, Bot-Abwehr und Layoutwechsel zwischen Websites. Sie können eine Seite, eine Liste oder eine ganze Domain per Platzhalter wie example.com/* ansteuern, und Firecrawl crawlt, was es findet, bevor es extrahiert. Er passt zu Teams, die wiederkehrende Datensätze, Preise oder Firmenangaben direkt in eine Datenbank oder einen Folgeschritt brauchen.
Zwei Grenzen prägen die Nutzung. extract läuft als asynchroner Job, Sie senden also URLs und fragen eine Job-ID für Ergebnisse ab, statt sofort eine Antwort zu bekommen. Und Firecrawl lenkt neue Arbeit inzwischen auf /agent, den Nachfolger, der seine URLs selbst findet. extract funktioniert noch, ist aber der ältere Weg.
Getting Started
- Registrieren Sie sich auf firecrawl.dev und kopieren Sie Ihren API-Schlüssel aus dem Dashboard
- Installieren Sie das SDK (pip install firecrawl-py oder npm install firecrawl) und initialisieren Sie einen Client mit dem Schlüssel
- Rufen Sie extract mit einer Liste von URLs, einem Prompt für die Felder oder einem JSON-Schema auf, wenn Sie eine feste Form brauchen
- Lesen Sie die zurückgegebenen Daten, oder fragen Sie die Job-ID ab, wenn Sie die Start-Methode für lange Läufe genutzt haben
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von extract by Firecrawl.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler, die KI-Apps bauen
- Data- und Analytics-Teams
- Gründer bei der Marktrecherche
- Leute, die Automatisierung bauen
Aufgaben
- Datensätze von vielen Seiten ziehen
- Unordentliche Seiten in JSON verwandeln
- Preise und Verfügbarkeit überwachen
- Wissensbasen für RAG aufbauen
- Daten aus mehreren Quellen zusammenführen
Szenarien
- Ein Research-Team verfolgt wöchentlich Wettbewerbspreise
- Ein Entwickler versorgt einen KI-Assistenten mit frischen Web-Fakten
- Ein Gründer scannt erstmals einen Markt
- Ein Ops-Team hält ein Verzeichnis aktuell
- Ein Data Engineer normalisiert verstreute Quellen
Wichtigste Funktionen
Extraktion strukturierter Daten per Prompt oder Schema
extract funktioniert auf zwei Wegen. Sie können einen Prompt in natürlicher Sprache schreiben, der die gewünschten Daten beschreibt, und das Modell wählt eine sinnvolle Form. Oder Sie geben ein JSON-Schema vor, sodass jeder Datensatz mit genau den Feldern und Typen zurückkommt, die Sie festgelegt haben. Teams, die eine stabile Form für eine Datenbank brauchen, nehmen das Schema; wer eine unbekannte Seite erkundet, startet mit einem Prompt und schärft ihn später.
Extraktion ganzer Domains mit Platzhaltern
Sie können extract auf eine einzelne Seite, eine kurze Liste oder eine ganze Website richten. Eine URL mit Platzhalter, etwa example.com/*, weist Firecrawl an, die Domain zu crawlen und jede gefundene Seite zu lesen, bevor es die Felder extrahiert. So wird aus einer Suche über die ganze Website ein Aufruf, ohne dass Sie die Liste der URLs selbst zusammenstellen. Der Ganze-Domain-Modus gilt als experimentell, weshalb Sie die Ergebnisse prüfen sollten.
Anreicherung per Websuche
Die Option für Websuche lässt die Extraktion über die angegebenen URLs hinausgehen. Firecrawl folgt verwandten Seiten, um fehlenden Kontext zu füllen, was hilft, wenn eine einzelne Seite nicht alles trägt. Ein dokumentiertes Beispiel zieht Preise, Funktionen und Bewertungen von Dashcams, indem es von einer Produktseite startet und die Suche das Netz weiter spannt.
Asynchrone Jobs mit Statusabfrage
extract läuft als Job, nicht als blockierender Aufruf. Sie senden die Anfrage und bekommen eine Job-ID zurück, dann fragen Sie den Status-Endpoint ab, bis er "completed" meldet. Die Zustände sind completed, processing, failed und cancelled, sodass Sie das in eine Warteschlange oder einen Hintergrund-Worker einhängen können. Die Ergebnisse eines Jobs bleiben über die API noch 24 Stunden nach dem Abschluss erreichbar.
Offizielle SDKs für Python und Node
Firecrawl liefert SDKs für Python und Node, Sie schreiben die HTTP-Aufrufe also nicht selbst. Der Python-Client nimmt ein Pydantic-Modell als Schema, der Node-Client ein Zod-Objekt, was typisierte und validierte Ausgabe bringt. Beide bieten eine Start-Methode, die sofort eine Job-ID liefert, dazu eine Status-Methode für die Ergebnisse, sobald der Job durch ist.
Credit-Abrechnung, geteilt über alle Endpoints
Extract rechnet jetzt in Credits ab, derselben Währung wie die anderen Endpoints. Diese KI-Datenextraktion fällt in dieselbe Abrechnung wie jeder andere Aufruf des Kontos. Ein Credit entspricht 15 Tokens bei extract, während ein einfacher Scrape 1 Credit pro Seite kostet. Credits werden über alle Endpoints geteilt, Suchergebnisse und gecrawlte Seiten zehren also von einem Guthaben. Das macht die Ausgaben leichter planbar, wenn ein Job Extraktion und Crawling mischt.
Ein dokumentierter Migrationspfad zu Agent
Firecrawl kennzeichnet extract als das ältere Werkzeug und lenkt neue Arbeit auf /agent, den Nachfolger. Agent behält Prompt und Schema, lässt aber die URL-Pflicht fallen, sodass er selbst suchen und navigieren kann. Wenn Ihr Fall "finde diese Daten irgendwo im Web" lautet, ist Agent der Weg; wenn Sie die URLs schon kennen, erledigt extract die Arbeit weiterhin.
Vor- und Nachteile
Vorteile
- Ausgabe per Prompt oder JSON-Schema erspart Ihnen handgeschriebene Selektoren für jede Seite
- Platzhalter-URLs lassen einen Job eine ganze Domain abdecken, ohne dass Sie die Seitenliste bauen
- Die offiziellen Python- und Node-SDKs unterstützen Pydantic und Zod für typisierte, validierte Ergebnisse
- Die Credit-Abrechnung wird über alle Endpoints geteilt, was die Ausgaben planbar macht, wenn ein Job mehrere Aufgaben mischt
- Ein kostenloser Tarif mit 1.000 Credits pro Monat deckt leichte Tests ohne Kreditkarte ab
Nachteile
- Die Extraktion ist asynchron, Sie können sie also nicht in eine Anfrage stecken, die sofort eine Antwort braucht
- Firecrawl lenkt neue Nutzer inzwischen zu Agent, extract ist also der ältere Weg und bleibt hinter dem neueren Werkzeug zurück
- Die Ganze-Domain-Extraktion mit Platzhalter gilt als experimentell, breite Crawls können also eine Ergebnisprüfung verlangen
- Job-Ergebnisse verschwinden nach 24 Stunden aus der API, die Langzeitspeicherung bleibt also bei Ihnen
- Seiten, die einen Fehlerstatus wie 403 oder 404 zurückgeben, kosten trotzdem einen Credit
Häufige Fragen
Es ist der Endpoint /extract von Firecrawl, einer Web-Data-API. Sie geben URLs plus einen Prompt oder ein JSON-Schema an, und ein Sprachmodell liefert die gewünschten Felder als strukturiertes JSON. Er eignet sich, um wiederkehrende Datensätze von Seiten zu ziehen, die kein festes Layout teilen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu extract by Firecrawl.
Alternativen zu extract by Firecrawl

Udon
Udon · Coding · ProduktivitätUdon macht aus einem Apple-Silicon-Mac einen Heimserver, den Sie im Browser steuern, mit Containern, Dateifreigaben und einem optionalen KI-Systemadministrator.

offstage
offstage cloud · Coding · Produktivitätoffstage gibt KI-Agenten und CI-Jobs einen echten Mac: ein frisches macOS-27-Konto auf Apple Silicon, per API gesteuert und sekundengenau abgerechnet.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Coding · ProduktivitätMit BotBus lassen sich KI-Agenten vom Smartphone steuern, auch wenn der Rechner im Büro steht: Befehle freigeben, Aufgaben starten, Ergebnisse lesen.