
Fish Speech
Fish Audio · Stimme & Sprache · Video
Fish Speech ist das Open-Source-Modell für Text zu Sprache von Fish Audio, aktuell als Drama 3: Stimmklon aus 10 bis 30 Sekunden Audio, 83 Sprachen und Emotions-Tags.
Über Fish Speech
About
Was ist Fish Speech
Fish Speech ist ein Open-Source-Text-zu-Sprache-Modell von Fish Audio, dem Unternehmen hinter der Plattform fish.audio. Der Name umfasst zwei Dinge, die zusammen ausgeliefert werden: die Modellgewichte auf Hugging Face und den Code auf GitHub, dazu den gehosteten Dienst, der dieselben Modelle hinter einer Website und einer API betreibt. Sie können sich anmelden und das Ganze wie jeden KI-Sprachgenerator nutzen, oder die Gewichte herunterladen und die Infrastruktur selbst betreiben.
Die Modellreihe hat sich schnell entwickelt. Fish Speech 1.x und OpenAudio S1 setzten das Versprechen: eine Stimme aus einem kurzen Sample klonen und den Ton in normaler Sprache steuern. S2 und S2.1 Pro verbesserten Genauigkeit und Streaming. Drama 3, am 13. Oktober 2026 veröffentlicht, ist der aktuelle Stand: 35B Parameter mit 3B aktiven pro Token, dazu lokale Audiobearbeitung und mehrstufige Überarbeitung.
Gelöst wird die Lücke zwischen offen und fertig. Fast jedes Open-Source-TTS-Projekt klingt flach neben kommerziellen Werkzeugen, und fast jedes kommerzielle Werkzeug zwingt Sie in seine Cloud. Hier stehen beide Türen offen: Die Gewichte kommen unter der Fish-Audio-Community-Lizenz, die kommerzielle Nutzung für Firmen unter 500.000 Dollar Jahresumsatz erlaubt, und die gehosteten Tarife starten kostenlos.
Die Grenzen zählen ebenso. Selbst hosten verlangt eine NVIDIA-GPU und etwas Geduld mit Python-Umgebungen. Die Klonqualität folgt der Sauberkeit Ihrer Referenzaufnahme, ein clipendes Handyvideo im Cafélärm ergibt einen ebenso unsauberen Klon. Und die meisten Benchmark-Zahlen stammen aus eigenen Tests von Fish Audio; Artificial Analysis ist der belastbarste unabhängige Vergleich.
Erste Schritte
- Öffnen Sie fish.audio und legen Sie ein kostenloses Konto an. Der Gratis-Tarif umfasst rund 7 Minuten generiertes Audio pro Monat, genug für ein Urteil, ob die Stimmen zu Ihrem Projekt passen.
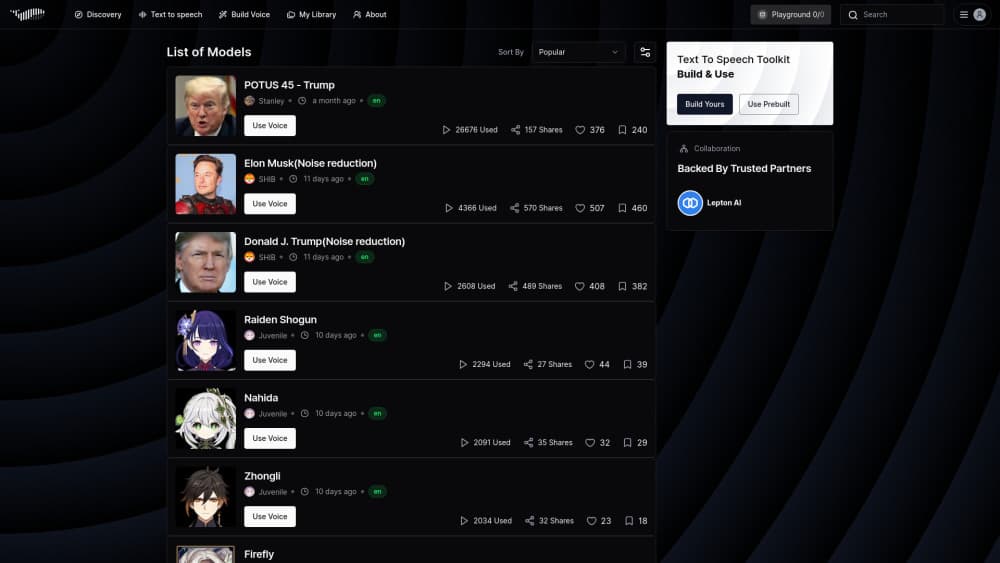
- Wählen Sie eine Stimme aus der Bibliothek oder klonen Sie Ihre eigene. Für einen Klon laden Sie 10 bis 30 Sekunden klare Sprache ohne Musik und ohne Raumhall hoch.
- Fügen Sie Ihr Skript in das Textfeld ein und setzen Sie Richtungs-Tags dort, wo sich die Stimmung ändert, etwa [whisper] vor einer Zeile oder [laughing] danach.
- Generieren, anhören, dann an den Tags feilen statt am Text. Ein geänderter Tag bewegt die Interpretation mehr als ein umformulierter Satz.
- Für den Eigenbetrieb klonen Sie das GitHub-Repository, richten die Umgebung ein, laden die Gewichte von Hugging Face und starten WebUI oder API-Server auf einem Rechner mit aktueller NVIDIA-Karte.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Fish Speech.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- YouTube-Creator und Podcaster
- Spieleentwickler und Animationsstudios
- Entwickler, die Sprachausgabe einbauen
- Lokalisierungsteams
Aufgaben
- Ein Video in eine andere Sprache synchronisieren
- Figurendialoge für eine Szene entwerfen
- Einen Blogbeitrag vertonen
- Einem App-Prototyp eine Stimme geben
Szenarien
- Eine Idee prüfen, bevor Studiokosten entstehen
- Einen Kanal in mehreren Märkten betreiben
- Eine Demo unter Termindruck abliefern
Wichtigste Funktionen
Stimmklon aus einem kurzen Sample
10 bis 30 Sekunden Referenzaudio genügen, um ein Timbre zu reproduzieren, und Fish Audio nennt auf der Startseite 15 Sekunden. Der Klon übernimmt Akzent, Tonhöhe und Sprechrhythmus, nicht bloß einen vagen Eindruck. Am besten funktioniert eine Monoaufnahme nah am Mikrofon; Musik im Hintergrund ruiniert das Ergebnis am schnellsten.
Richtungs-Tags im Text
Die Darbietung steuern Sie mit Anweisungen in eckigen Klammern, gesetzt dort, wo die Stimmung kippt: [whispering], [angry], [sighing], [laughing], [pause]. Drama 3 versteht auch freie Formulierungen, [barely holding it together, forcing a smile] wirkt als Tag. Gepaarte Tags wie die für Betonung richten nur einzelne Wörter einer Zeile aus. Genau das trennt das Modell von älteren Engines, bei denen Sie Tempo und Tonhöhe drehten und auf Glück hofften.
Breite Sprachabdeckung
Drama 3 spricht 83 Sprachen, deutlich mehr als die 13 von Fish Speech 1.5. Damit gehört es zu den breitesten mehrsprachigen TTS-Modellen, die Sie herunterladen können. Ein mehrsprachiges TTS mit dieser Abdeckung ist selten. Entscheidend ist das Klonen über Sprachgrenzen: Sie klonen eine Stimme einmal und generieren in einer anderen Sprache, während die Sprecheridentität bleibt. Richtungs-Tags dürfen in der Sprache stehen, in der Sie denken, das Modell wendet sie trotzdem an.
Mehrere Sprecher in einer Szene
Ein Text kann mehrere Figuren über Sprecher-IDs enthalten, und das Modell erzeugt den ganzen Dialog in einem Durchlauf. Für Hörspiele, Zwischensequenzen oder Videos mit zwei Moderatoren entfällt die Schleife aus Generieren, Zusammenkleben und neu Taktieren, die Mehrsprecherarbeit mühsam machte.
Lokale Bearbeitung und mehrstufige Überarbeitung
Drama 3 lässt Sie eine fertige Aufnahme wie ein Dokument bearbeiten. Ein Wort ersetzen, und Timbre sowie Übergänge drumherum bleiben intakt, statt fünf Minuten Audio wegen eines Fehlers neu zu erzeugen. Die mehrstufige Überarbeitung wirkt andersherum: Sie sagen, die letzte Aufnahme solle sanfter oder trauriger sein, und das Modell generiert mit diesem Kontext neu.
Offene Gewichte zum Selbsthosten
Code und Gewichte sind öffentlich, und die Community-Lizenz erlaubt kommerzielle Nutzung unter 500.000 Dollar Jahresumsatz. Für Teams mit Datenschutzauflagen oder planbarem Volumen ist das eine echte Option: Lokale Inferenz kostet nichts pro Zeichen. Dafür zahlen Sie mit GPU-Hardware, Einrichtungszeit und der Pflege eines Python-Stacks.
Streaming-API mit niedriger Latenz
Die gehostete API liefert Audio während der Generierung, mit dem ersten Ton nach rund 100 ms und einem Echtzeitfaktor von 0,195 auf einer H200 nach Messungen von Fish Audio. Sprachsynthese, Spracherkennung und ein Voice-Agent-Endpunkt teilen sich denselben Schlüssel. In einem Sprachprodukt entscheidet diese Latenz, ob ein Assistent ins Wort fällt oder abwartet.
Vor- und Nachteile
Vorteile
- Der Stimmklon gelingt mit einer kurzen Referenz, eine Studiositzung ist für eine brauchbare Stimme nicht nötig.
- Emotion und Tempo steuern Sie über Tags in normaler Sprache, was schneller zu justieren ist als mit Parameterschiebern.
- Gratis-Tarif und offene Gewichte bieten zwei günstige Wege, das Modell vor jeder Zahlung zu prüfen.
- 83 Sprachen mit sprachübergreifendem Klon decken einen großen Teil der Lokalisierung mit einer Stimmidentität ab.
- Streaming-Latenz und offene API machen das Modell in einem echten Produkt nutzbar, nicht nur für einzelne Dateien.
Nachteile
- Selbsthosten verlangt eine NVIDIA-GPU und Sicherheit mit Python-Umgebungen, was Gelegenheitsnutzer ausschließt.
- Die Klonqualität hängt stark vom Referenzaudio ab: Eine verrauschte Aufnahme klingt dumpf, ein Aufräumwerkzeug ist nicht eingebaut.
- Die Community-Lizenz begrenzt kostenlose kommerzielle Nutzung auf Firmen unter 500.000 Dollar Jahresumsatz, größere Häuser brauchen eine eigene Vereinbarung.
- Fast alle veröffentlichten Benchmarks stammen vom Hersteller, und die unabhängigen Vergleiche messen Aussprache, nicht emotionale Bandbreite.
Häufige Fragen
Ja. Der gehostete Dienst hat einen Gratis-Tarif mit rund 7 Minuten Generierung pro Monat, und die Gewichte lassen sich kostenlos herunterladen. Kommerzielle Nutzung der offenen Gewichte ist für Organisationen unter 500.000 Dollar Jahresumsatz frei.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Fish Speech.
Alternativen zu Fish Speech

Prosp
Prosp · Schreiben · Stimme & Sprache · MarketingProsp ist ein KI-Tool für LinkedIn-Ansprache, gebaut für Agenturen und Vertriebsteams, und es schreibt die Nachricht und die Sprachnachricht mit Ihrer eigenen Stimme für jeden Interessenten, damit sie wirklich antworten. Sie verbinden Ihre Konten, finden Leads und lassen die KI personalisierte Nachrichten in großem Umfang entwerfen und versenden, alles aus einem Posteingang. Es ist für Menschen gemacht, die Outbound in großem Stil betreiben. Das ist das ganze Versprechen. Jeder Kontaktpunkt muss trotzdem menschlich wirken.

Wordly AI Translation
Wordly · Stimme & Sprache · ProduktivitätWordly AI Translation ist eine KI-Echtzeitübersetzungs- und Untertitelungsplattform für Besprechungen, Konferenzen und Veranstaltungen. Sie liefert Live-Übersetzung, Untertitel, Transkripte und Zusammenfassungen in mehr als 60 Sprachen, und Teilnehmer treten per QR-Code-Scan oder über einen Link bei, statt eigene Kopfhörer zu nutzen. Die Plattform arbeitet mit Zoom, Microsoft Teams, Google Meet und Webex zusammen und richtet sich an Organisationen, die mehrsprachigen Zugang wollen, ohne für jede Sitzung menschliche Dolmetscher zu engagieren. So einfach ist das.
Musicful
Musicful AI · Stimme & Sprache · VideoMusicful ist ein KI-Musikgenerator und KI-Musikvideo-Ersteller, der Text in Minuten in Musik verwandelt. Du gibst einen Text, einen Songtext oder eine gesummte Melodie ein und erhältst einen fertigen Track mit Gesang und Instrumenten. Er dient außerdem als KI-Songgenerator, erstellt Musikvideos aus den Songs, die du machst, und bietet ein KI-Cover-Werkzeug plus eine Entwickler-API. Die Plattform läuft im Webbrowser und über eine Android-App, sodass du einen Song am Desktop beginnen und am Handy fortsetzen kannst.