
Fleak
Fleak · Coding
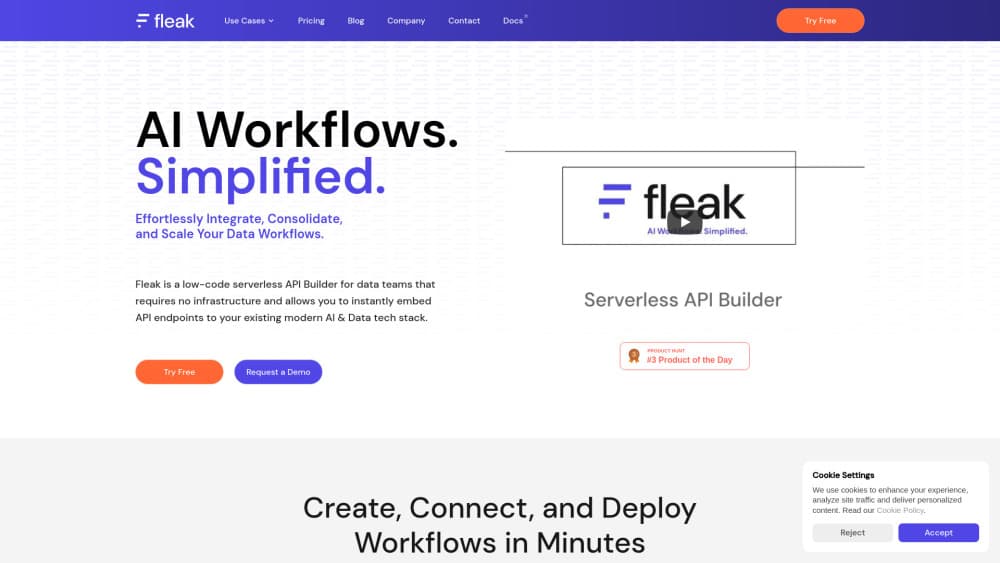
Fleak ist eine Low-Code-Plattform ohne Server, die unordentliche Daten bereinigt, lenkt und an KI-Apps liefert, gebaut für Daten- und Engineering-Teams.
Über Fleak
Was ist Fleak
Fleak sitzt zwischen Ihren Rohdaten und den KI-Anwendungen, die sie verbrauchen. Die Formulierung des Unternehmens ist deutlich: Ihre KI ist nur so klug wie Ihre schlechteste Datenquelle. Rohe, ungeprüfte Ereignisse fließen in Modelle und Datenspeicher, und die Modelle denken über alles gleich nach, was bedeutet, dass sie bei allem gleich falsch liegen.
Fleaks Antwort ist eine Datenschicht, die entscheidet, was jeder eingehende Datenpunkt wert ist, bevor er eine nachgelagerte App erreicht. Was Echtzeitwert trägt, läuft schnell. Was Compliance-Wert trägt, geht in die Langzeitspeicherung. Was keinen Wert trägt, geht nirgendwohin. Das Ziel ist, nicht mehr für das Speichern und Verarbeiten von Müll zu zahlen. Sie können das Produkt als Low-Code-API-Builder für serverseitige Datenintegration sehen, der die Leitungen übernimmt, damit Ihr Team nicht jeden Konnektor von Hand schreibt.
Es ist für Teams gebaut, die diesen Schmerz schon spüren. Jede neue Quelle braucht Monate bis zur Anbindung, jede Schemaänderung bricht etwas, und das Datenteam kommt nie aus dem Wartungsmodus heraus. Fleak geht diese Last direkt an, mit selbstheilenden Pipelines und wertbewusstem Routing. Es meldet SOC 2 Type II und protokolliert jede Transformation.
Die wichtigsten Grenzen sind praktisch, nicht technisch. Fleak ist Infrastruktur, richtet sich also an Teams mit echten Pipelines und echtem Datenvolumen, nicht an einzelne Nutzer. Es hängt auch stark davon ab, sich mit Ihren bestehenden Quellen zu verbinden, was bedeutet, dass der Aufwand für die Einrichtung mit der Verflechtung Ihres Stacks wächst. Nach dem, was auf der Seite veröffentlicht ist, gibt es keine öffentlichen Preise, also sollten kleinere Teams mit dem Vertrieb sprechen, bevor sie annehmen, dass es in ein knappes Budget passt.
Erste Schritte
- Verbinden Sie eine Quelle. Fleak koppelt sich an Cloud-Dienste, OT-Systeme, Endpunkte, APIs und Datenbanken und erklärt, dass keine eigenen Konnektoren nötig sind.
- Beschreiben Sie in natürlicher Sprache, was Sie wollen. Der Copilot baut die Pipeline-Konfiguration aus dieser Beschreibung in Minuten.
- Lassen Sie transformieren und lenken. Fleak erkennt Ereignistypen, verzweigt nach der Absicht des Ziels und normalisiert Daten auf das richtige Schema.
- Liefern Sie an jedes Ziel. Saubere, geregelte Daten gehen in Ihre KI-Apps, Data Lakes, Ihr SIEM oder andere Ziele, in Echtzeit.
- Bestätigen Sie Änderungen, wenn Schemata abweichen. Fleak erkennt eine Änderung stromaufwärts, erzeugt eine neue Config und fragt Sie um Bestätigung, bevor es neu ausrollt.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Fleak.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Data Engineers
- Plattform- und Infrastrukturteams
- Security-Operations-Teams
- Teams im Finanzdienstleistungsbereich
Aufgaben
- Datenquellen zusammenführen
- KI-Eingaben normalisieren
- Speicherausgaben senken
- Nach Wert lenken
- Serverlose APIs bauen
- Schritte von KI-Workflows automatisieren
Szenarien
- Ein nachgelagertes Modell liefert schlechtere Antworten, nachdem ein Team stromaufwärts ein Feld umbenannt hat
- Ein Datenteam verbringt die Woche mit Konnektor-Pflege statt mit neuer Arbeit
- Die Compliance fragt, was ein Agent tatsächlich mit Kundendaten gemacht hat
- Ein Security-Team muss Ereignisse mit hohem Volumen im Moment ihres Eintreffens sortieren, ohne Monate an Rauschen zu speichern.
Wichtigste Funktionen
Wertbewusstes Routing
Fleak bewertet jeden eingehenden Datenpunkt gegen das, was die nachgelagerte Anwendung braucht, und lenkt ihn auf dieser Grundlage. Echtzeitsignale gehen direkt durch, Compliance-Daten gehen in die Langzeitspeicherung, und wertlose Daten werden verworfen. Für Teams, die sowohl Speicher als auch LLM-Tokens zahlen, entstehen die Einsparungen genau in dieser Sortierung.
KI-orchestrierte, selbstheilende Pipelines
Wenn sich ein Schema stromaufwärts ändert, erkennt Fleak es, erzeugt eine neue Config und rollt neu aus, mit optionaler menschlicher Prüfung. Das Unternehmen gibt die durchschnittliche Selbstheilungszeit mit etwa drei Minuten an. Das ist der Unterschied zwischen einem stillen Pipeline-Bruch und einer Config, die Sie bestätigen und hinter sich lassen.
Pipeline-Bau in natürlicher Sprache
Sie beschreiben das gewünschte Ergebnis in klarer Sprache, und der Copilot baut die Pipeline zusammen. Fleak vermarktet das als Einrichtung in Minuten, gegen eine traditionelle Zahl von etwa sechs Monaten, um eine erste Quelle live zu bekommen. Der Punkt ist nicht die Marketingzahl, sondern dass ein Data Engineer nicht jede Transformation von Hand schreibt, und in einem Stack mit einem Dutzend Quellen verstärkt sich dieser Unterschied schnell.
Geregelte Lieferung mit Audit-Trails
Zugriffskontrolle wird in der Datenschicht durchgesetzt, statt pro Anwendung angeschraubt zu werden, und jede Transformation wird protokolliert. Fleak gibt SOC 2 Type II an. Für Teams, deren Auditoren fragen, was ein bestimmter Agent mit einem bestimmten Datensatz gemacht hat, ist dieses Log die Antwort, und es macht Data Governance zu einer Eigenschaft der Plattform statt zu einer Checkliste, die jedes Anwendungsteam allein erfüllen muss.
Konnektivität zu jeder Quelle
Cloud-Dienste, OT-Systeme, Endpunkte, APIs und Datenbanken verbinden sich über die Plattform, und Fleak sagt, dass keine eigenen Konnektoren nötig sind. Das zählt für Teams mit industriellen oder IoT-Daten, wo ein Konnektor für jedes Protokoll ein eigenes Projekt ist.
Echtzeit-Durchsatz bei hohem Volumen
Fleak verarbeitet Ereignisse in einem Maßstab, den es mit Millionen pro Sekunde beschreibt, in Echtzeit und ohne Speicherbedarf für den Durchlauf. Die Deduplizierung bei der Aufnahme soll die Speicherkosten um 50 Prozent senken und normalisierte Eingaben die LLM-Token-Kosten um 40 Prozent. Das sind Fleaks eigene Zahlen, keine unabhängigen Messungen.
Lieferung an jedes Ziel
Saubere Daten landen im Schema, das Sie angeben, und gehen an KI-Anwendungen, Data Lakes, SIEM oder andere Ziele. Derselbe geregelte Strom kann mehrere Verbraucher gleichzeitig versorgen, statt für jeden neu gebaut zu werden.
Vor- und Nachteile
Vorteile
- Wertbewusstes Routing senkt Speicher- und Token-Kosten, indem es Daten verwirft, die niemand braucht.
- Selbstheilende Pipelines behandeln Schemaabweichungen automatisch, sodass ein umbenanntes Feld stromaufwärts nicht zum Bereitschaftsvorfall wird.
- Zugriffskontrolle und ein vollständiger Audit-Trail liegen in der Datenschicht, was die Compliance-Arbeit vereinfacht.
- Die Einrichtung in natürlicher Sprache senkt den Aufwand, eine erste Quelle live zu bekommen, gegenüber von Hand gebauten Pipelines.
- Echtzeit-Durchsatz bei hohem Volumen ohne Speicherbedarf für Durchlaufereignisse.
Nachteile
- Keine veröffentlichten öffentlichen Preise, also bedeutet Budgetplanung, den Vertrieb zu kontaktieren.
- Es ist Infrastruktur für Teams mit echtem Datenvolumen, was es für ein kleines Projekt oder einen Solo-Entwickler überdimensioniert macht.
- Der Nutzen hängt davon ab, Ihre bestehenden Quellen zu verbinden, also wächst der Einrichtungsaufwand mit der Verflechtung Ihres Stacks.
- Die Einsparzahlen sind Fleaks eigene Angaben und wurden nicht unabhängig geprüft.
Häufige Fragen
Fleak ist eine Datenschicht zwischen Ihren Rohquellen und Ihren KI-Anwendungen. Sie bereinigt, filtert, normalisiert und lenkt Daten und liefert sie dann an Ziele wie KI-Apps, Data Lakes oder ein SIEM. Das Versprechen ist einfach: Modelle antworten nur so gut wie die Daten, die sie bekommen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Fleak.
Alternativen zu Fleak
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.
Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.