
General Compute
General Compute · Coding
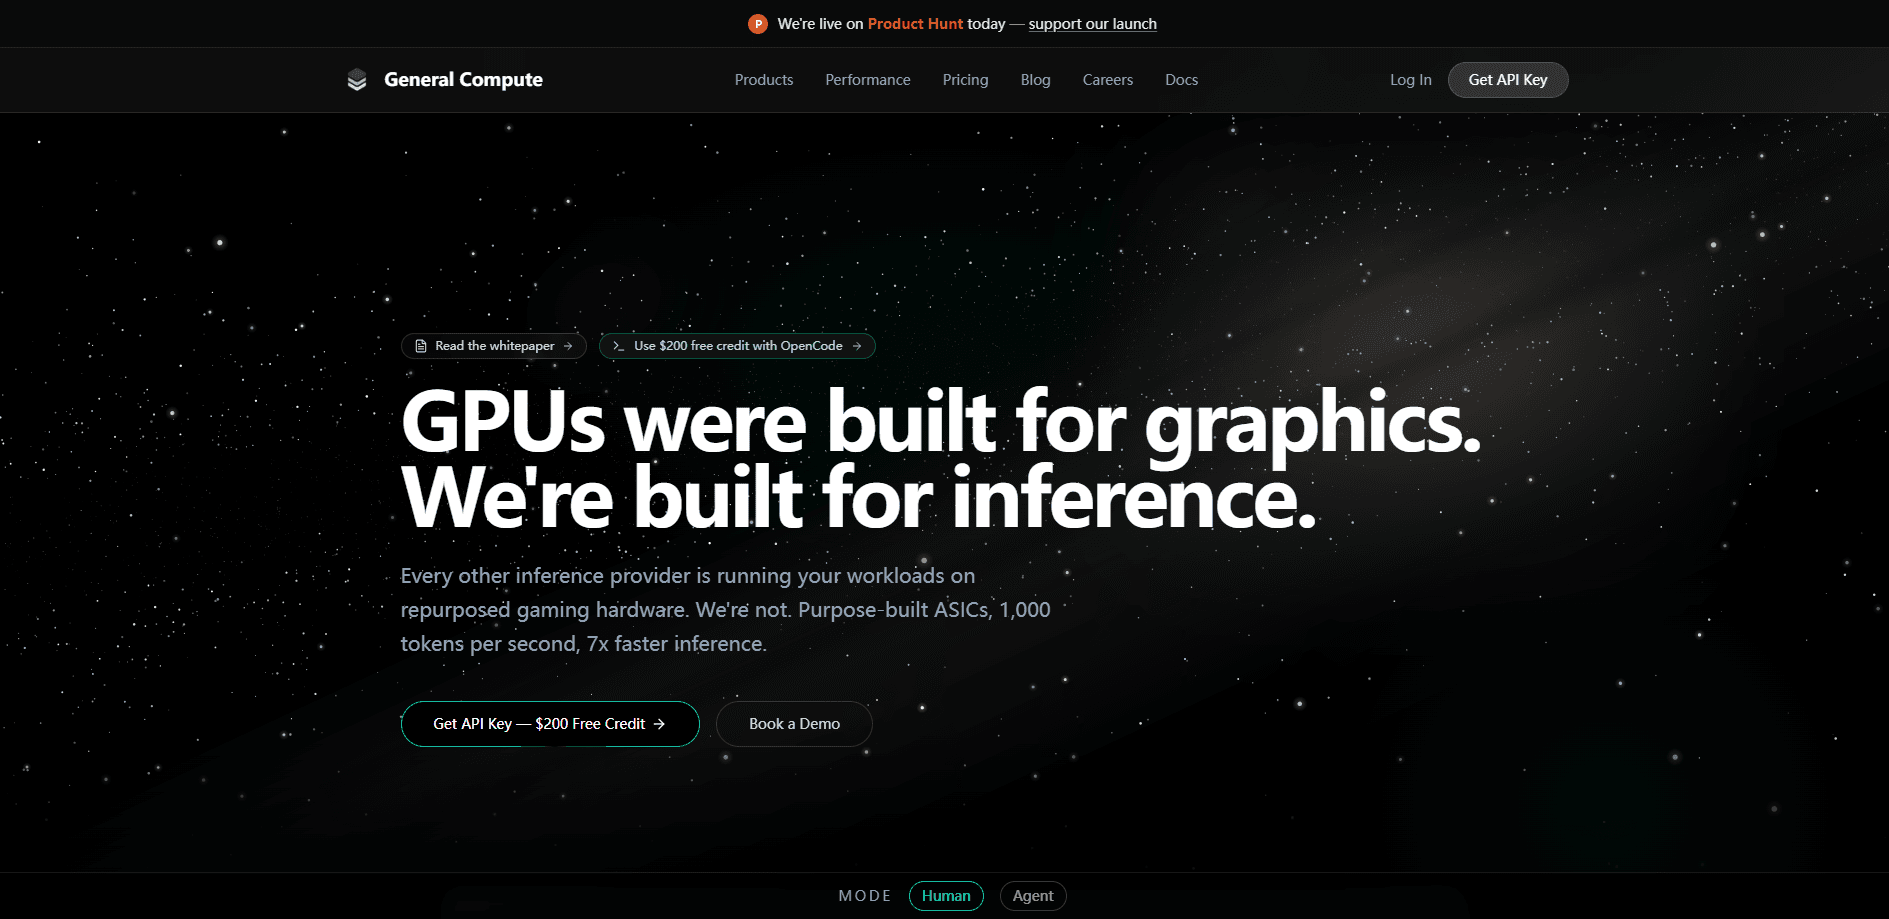
General Compute ist eine KI-Inferenz-Cloud, die für eine einzige Aufgabe gebaut wurde: große Sprachmodelle schneller bereitzustellen, als es Anbieter mit ausschließlich GPUs können. Sie betreibt OpenAI-kompatible Endpunkte auf eigens gebautem Decoding-Silizium von SambaNova, Cerebras, Positron und d-Matrix, während der Prefill auf NVIDIA-B300-Racks bleibt. Neue Konten erhalten 100 Dollar Gratisguthaben, und Teams, die reservierte Kapazität oder private Gewichte brauchen, können einen dedizierten Vertrag abschließen. Auch die Preise sind transparent. Der Preis der Inferenz-API wird pro Million Tokens abgerechnet, ohne monatliche Gebühr pro Nutzer im Self-Service-Tarif. Keine versteckten Plattformkosten.
Über General Compute
Was ist General Compute
General Compute ist ein Inferenzanbieter, der LLM-Arbeitslasten auf zwei Arten von Hardware aufteilt. Der Prefill, der rechenintensive erste Durchlauf, läuft auf GPUs. Das Decoding, der speichergebundene Teil, der Tokens einzeln erzeugt, läuft auf ASIC-Beschleunigern, die genau dafür gebaut sind. Das Versprechen ist einfach: Die Decoding-Geschwindigkeit lässt Agenten langsam wirken, und mehr GPU-Rechenleistung behebt das nicht.
Das Produkt zeigt sich als REST-API, auf die Sie Ihr bestehendes OpenAI-SDK richten können. Tauschen Sie Basis-URL und API-Schlüssel, und Ihre Tool-Aufrufe, der JSON-Modus und das Streaming funktionieren weiter. Zu den verfügbaren Modellen gehören MiniMax M2.7, DeepSeek V3.2, DeepSeek V3.1 und GPT-OSS 120B.
Die größte Einschränkung ist die Reife. General Compute ist ein junger Anbieter, und die eigenen Benchmarks sind die Quelle für die beworbenen Geschwindigkeitswerte. Wenn Sie eine zehn Jahre alte Cloud mit jeder Region und jedem Compliance-Zertifikat brauchen, ist es diese nicht. Wenn Sie schnelle Token-Generierung und einen einfachen Migrationspfad wollen, lohnt ein Blick.
Erste Schritte
- Legen Sie ein Konto auf app.generalcompute.com an und sichern Sie sich die 100 Dollar Gratisguthaben.
- Erzeugen Sie einen API-Schlüssel im Dashboard und kopieren Sie Ihre Basis-URL.
- Richten Sie Ihr OpenAI-SDK auf den General-Compute-Endpunkt, indem Sie den Import und den Schlüssel tauschen.
- Wählen Sie eine Modell-ID wie
minimax-m2.7oderdeepseek-v3.2in Ihrer Anfrage. - Führen Sie Ihren ersten Aufruf aus und skalieren Sie die Nutzung dann über den Pay-as-you-go-Tarif.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von General Compute.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Entwickler
- Agent-Entwickler
Aufgaben
- Latenzempfindlicher Chat
- Strukturierte Agent-Workflows
- Privates Modell-Hosting
Szenarien
- Prototyp für ein neues KI-Feature
- Inferenz in Produktion im großen Maßstab
Wichtigste Funktionen
Eigens gebautes Decoding-Silizium
Die meisten Inferenz-Clouds betreiben alles auf GPUs. General Compute schickt den Decoding-Schritt auf Chips, die dafür gebaut sind, darunter der SambaNova SN50 im Produktivbetrieb und die Wafer-Scale-Hardware von Cerebras für den schnellsten Tarif. Das Unternehmen sagt, dass dies 1.000 bis 2.000 Tokens pro Sekunde und Nutzer bei Modellen mit mehreren Billionen Parametern liefert, gegenüber unter 320 Tokens pro Sekunde auf einem B300-Rack mit einem 230B-MoE. Diese Lücke ist der ganze Daseinsgrund des Produkts. Riesiger Unterschied. Decoding ist speichergebunden, daher bewegt das Stapeln von GPUs es kaum.
OpenAI-kompatible API
Die API spricht dieselben Endpunkte, Parameter und Streaming-Semantik wie OpenAI. Sie behalten Ihre Orchestratoren, Ihre Tool-Definitionen und Ihre Wiederholungslogik. Die Migration ist in den meisten Codebasen eine Änderung von einer Zeile. So einfach ist das. Für Teams, die schon tief im OpenAI-SDK stecken, ist das der Unterschied zwischen einem Wochenendprojekt und einem Quartal Nacharbeit.
Modellvielfalt inklusive Reasoning-Modellen
Der Katalog deckt Allzweck- und Reasoning-Modelle ab. MiniMax M2.7 übernimmt Chat und Generierung mit einem Kontextfenster von 192k. DeepSeek V3.2 und V3.1 ergänzen eingebautes Gedankenketten-Reasoning für Mathe, Code und Analyse. GPT-OSS 120B rundet die Liste für Freunde offener Gewichte ab.
Eigenes Modell mitbringen
Sie können private Gewichte bereitstellen, sei es ein LoRA, eine GGUF-Datei oder ein vollständiges Finetuning. General Compute packt den Checkpoint in einen Container, hängt Beschleuniger in us-west-2 an und stellt ihn hinter einer privaten Modell-ID bereit. Ihre eigenen Modelle verhalten sich dann wie jeder andere Modellparameter, Streaming und Tool-Aufrufe inbegriffen. Für Teams mit proprietären Gewichten ist dieses Modell-Hosting der Grund, über die Consumer-API hinauszuschauen.
Dedizierte Racks mit Root-Zugriff
Über die Self-Service-API hinaus können Sie dedizierte Prefill- und Decoding-Kapazität unter einer Vereinbarung mit SLAs vertraglich sichern. Sie bekommen Bare Metal mit Root-Zugriff, preisgeschütztes Kontingent über drei Anbieter und die Orchestrierung von Prefill und Decoding als einen einzigen Dienst für die Laufzeit des Vertrags.
Multi-Anbieter-Kapazität
Das Kontingent verteilt sich auf SambaNova, Cerebras, Positron und d-Matrix, sodass Sie nicht an einen Chip-Lieferanten gebunden sind. Reservierte Decoding-Kapazität kann bei Verkehrsspitzen auf die gekoppelte B300-Flotte birsten, was verhindert, dass eine unregelmäßige Last ein Rack stilllegt.
Vor- und Nachteile
Vorteile
- Decoding-Geschwindigkeiten, die reine GPU-Clouds bei großen Modellen nicht erreichen, laut den eigenen Benchmarks des Unternehmens.
- Die OpenAI-kompatible API sorgt dafür, dass die meisten Teams ohne Umschreiben von Code migrieren.
- Tool-Aufrufe, JSON-Modus und Reasoning-Unterstützung sind im ganzen Katalog verfügbar.
- Multi-Anbieter-Hardware plus 100 Dollar Gratisguthaben senken die Kosten eines Tests.
- Die Unterstützung für eigene Modelle deckt LoRA, GGUF und vollständige Finetunings ab.
Nachteile
- Die beworbenen Geschwindigkeitswerte stammen aus den eigenen Benchmarks von General Compute, nicht aus unabhängigen Tests, also behandeln Sie sie als Anbieteraussagen, bis Sie Ihre eigene Last testen.
- Der gesamte Produktionsverkehr läuft derzeit in einer einzigen US-Region, was zählt, wenn Sie Datenresidenz anderswo oder niedrige Latenz außerhalb der USA brauchen.
- Reseryierte und Enterprise-Tarife nutzen individuelle Preise, sodass Sie die Kosten dedizierter Kapazität nicht schätzen können, ohne mit dem Vertrieb zu sprechen.
- Pay-as-you-go-Tarife erhalten Best-Effort-Zuverlässigkeit, vertragliche SLAs bleiben dem Enterprise vorbehalten.
Häufige Fragen
Es ist eine KI-Inferenz-Cloud zum Betreiben großer Sprachmodelle, besonders decodierungsintensiver Lasten wie mehrstufiger Agent-Schleifen, bei denen sich die Latenz summiert. Sie rufen es über eine OpenAI-kompatible API auf, statt eigene GPUs zu verwalten.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu General Compute.
Alternativen zu General Compute
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.