
GMI Cloud
GMI Cloud · Coding
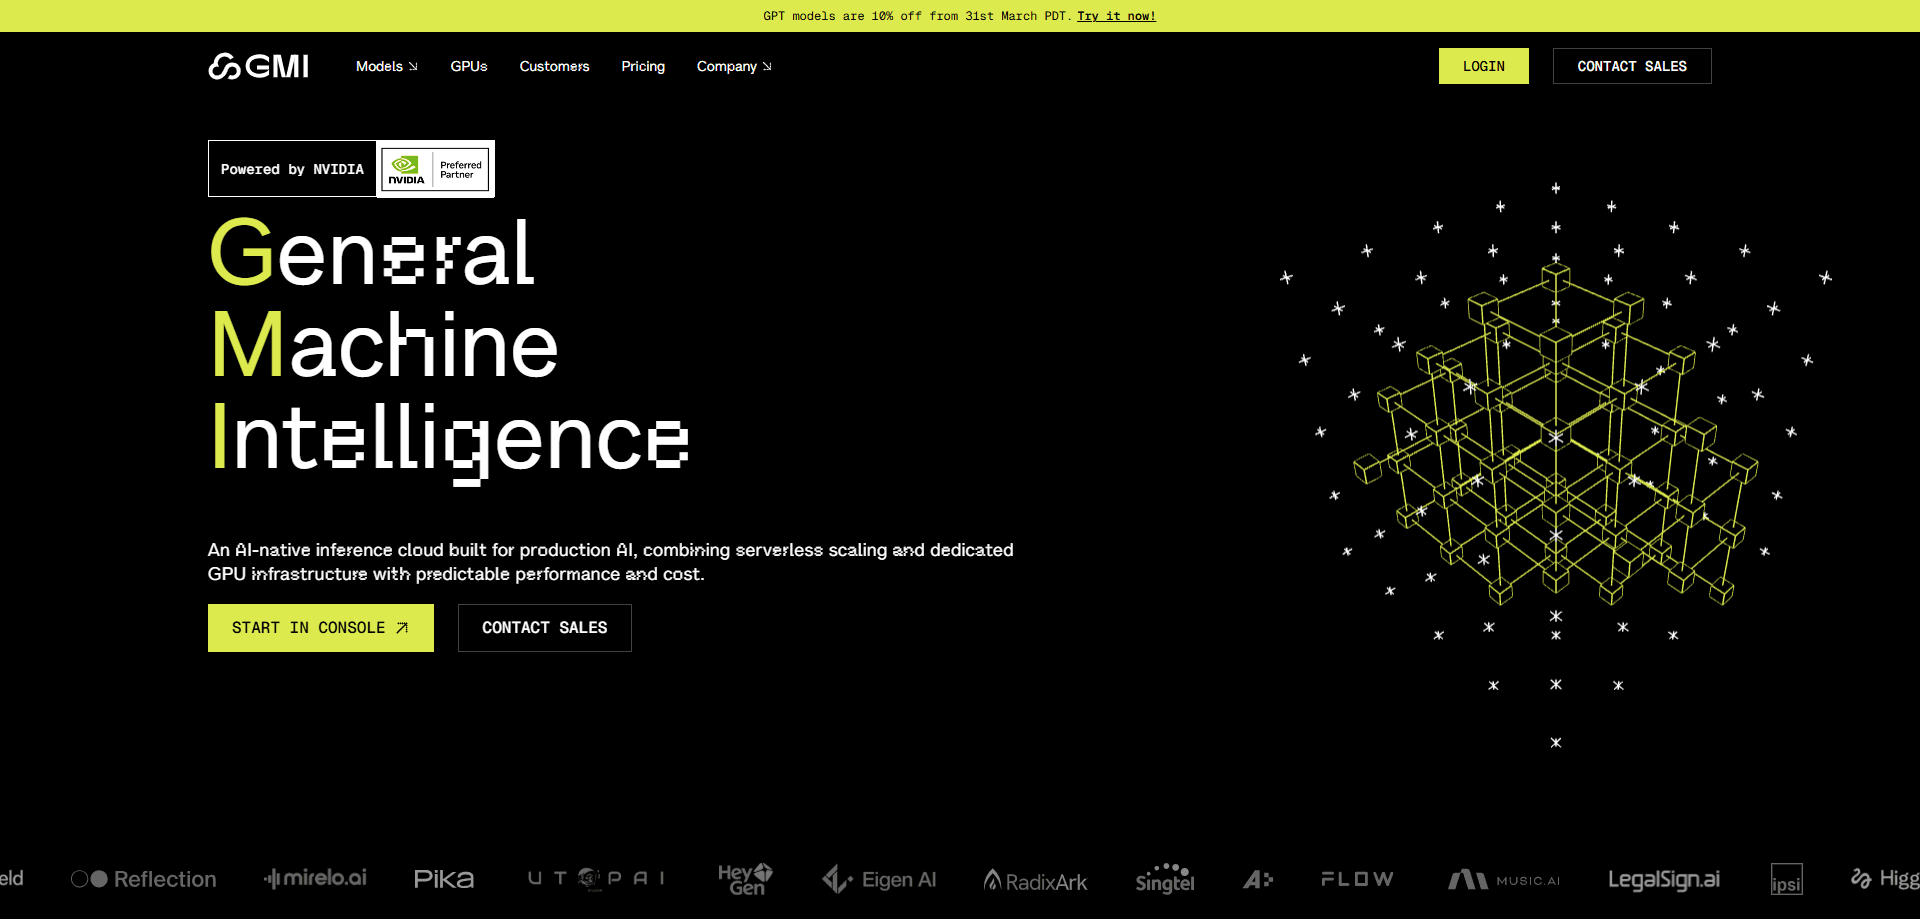
GMI Cloud ist eine KI-native Cloud-Plattform, die serverlose Inferenz mit dedizierter NVIDIA-GPU-Infrastruktur in einem System verbindet. Teams starten mit einem API-Aufruf und wechseln dann zu Bare-Metal-GPU-Clustern, wenn ihre Workloads wachsen, ohne ihren Stack neu zu bauen. Sie ist für Entwickler und Unternehmen gedacht, die Training, Fine-Tuning und Produktionsinferenz im großen Maßstab betreiben.
Über GMI Cloud
Was ist GMI Cloud
GMI Cloud ist eine Cloud-Plattform für KI-Workloads, die auf NVIDIA-Hardware läuft. Sie teilt die Aufgabe in zwei Schichten: serverlose Inferenz für Modelle, die sofort laufen müssen, und dedizierte GPU-Cluster für Teams, die rohe Rechenleistung unter eigener Kontrolle brauchen. Beide liegen auf demselben Konto, sodass Skalieren keine Migration bedeutet.
Fast jede GPU-Cloud zwingt dich, dich für eine Seite zu entscheiden. Mietest du API-Zugang, stößt du an eine Decke. Mietest du Bare Metal, kümmerst du dich selbst um Orchestrierung, Netzwerk und Kostenrechnung, was gut geht, bis ein Traffic-Spike um 2 Uhr nachts auf deinem Schreibtisch landet. GMI Cloud versucht, diese Lücke zu schließen, indem Workloads je nach Nachfrage zwischen den beiden Modi wechseln.
Das Unternehmen wurde 2023 gegründet und hat seinen Sitz im Silicon Valley, mit Rechenzentren in Nordamerika, Europa und Asien. Es trägt den Status Reference Platform NVIDIA Cloud Partner, eine Auszeichnung, die nur eine kleine Gruppe von Anbietern besitzt. Das zählt für die Versorgung, denn knappe GPU-Kapazität geht meist zuerst an Partner, die der Hardwarehersteller gut kennt.
Die größte Einschränkung ist die Zielgruppe. GMI Cloud ist ein Infrastrukturprodukt, keine Consumer-App. Es gibt kein freundliches Dashboard für Gelegenheitsnutzer, und die Preisgestaltung richtet sich nach GPU-Stunden statt nach festen Monatsplänen. Wenn du nur mit einem Modell chatten willst, ist das nicht das richtige Werkzeug. Wenn du eines bereitstellst, ist es für dich gedacht.
Erste Schritte
- Erstelle ein Konto unter console.gmicloud.ai und wähle serverlose Inferenz oder GPU-Infrastruktur.
- Erzeuge einen API-Schlüssel in der Konsole für die Inferenz oder reserviere eine dedizierte GPU-Instanz für Training und Fine-Tuning.
- Wähle ein Modell aus dem Katalog für die Arbeit über die API oder richte deinen eigenen Stack auf einer Bare-Metal-GPU ein.
- Führe eine Testanfrage oder einen Testjob aus und prüfe Latenz, Durchsatz und Ausgaben in der Konsole.
- Skaliere, indem du Cluster hinzufügst oder zu gebuchter Kapazität wechselst, sobald sich die Nutzungsmuster stabilisiert haben.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von GMI Cloud.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Entwickler
- ML-Ingenieure
- Startups
- Enterprise-KI-Teams
Aufgaben
- Modellinferenz in Produktion betreiben
- Große Modelle trainieren und feintunen
- Viele Modelle über eine API aufrufen
- Für Traffic-Spitzen skalieren
Szenarien
- Eine KI-Funktion mit kleinem Budget starten
- Einen Prototyp in Produktion bringen
- Eine globale Nutzerbasis bedienen
- Auf High-End-GPUs forschen
Wichtigste Funktionen
Serverlose Inferenz als Standard
Die Inferenz läuft serverlos, sofern du nichts anderes sagst. Skalierung, Traffic-Handling und kostenbewusste Planung laufen ohne manuelles Setup, einschließlich Herunterskalieren auf null, wenn nichts läuft. Keine Autoscaling-Regeln, die du überwachen musst. Für Teams, die den Einstieg mit wenig Aufwand wollen, ist das der richtige.
Dedizierte NVIDIA-GPU-Cluster
Wenn serverlos nicht reicht, wechselst du zu Bare-Metal-GPUs mit vorhersehbarer Leistung. Die Hardware umfasst Plattformen der Generationen H100, H200, B200 und Blackwell. Jede Instanz ist dediziert, sodass du keinen Knoten mit anderen Mietern teilst und keine schwankende Leistung bekommst.
Cluster Engine
Cluster Engine ist die eigene Orchestrierungsschicht von GMI Cloud für Multi-Node-Cluster. Sie übernimmt Planung und Ressourcenzuteilung über Knoten hinweg und unterstützt reservierte und On-Demand-Kapazität nebeneinander. Root-Zugriff und eigene Stacks stehen bereit, wenn der Workload sie braucht, was zählt, wenn dein Modell nicht auf einem Standard-Image läuft.
Inference Engine
Inference Engine ist die Modell-Serving-Plattform hinter der API. Sie gibt Zugang zu einem breiten Modellkatalog, darunter LLMs, Sprache und Videogenerierung, über einen einzigen Endpoint. Laut GMI Cloud zielen die Abstimmung auf Chipebene und die Lastplanung auf höheren Durchsatz und niedrigere Latenz als bei einem Standard-Setup.
Transparente Preise pro GPU-Stunde
Die Preise werden pro GPU-Stunde ohne versteckte Gebühren gelistet, von 2,00 $ für die H100 bis 8,00 $ für die GB200. On-Demand- und gebuchte Optionen lassen dich Flexibilität gegen niedrigere Stückkosten tauschen, wenn sich die Nutzung stabilisiert. Unternehmen erhalten einheitliche Abrechnung und regionale Preise.
Globale Rechenzentrumspräsenz
GMI Cloud betreibt eigene Rechenzentren in Nordamerika, Europa und Asien, statt Kapazität von anderen weiterzuverkaufen. Für Teams, die globale Nutzer bedienen, bedeutet das Platzierungsoptionen und gleichmäßigere Leistung über Regionen hinweg.
Flexibler Skalierungspfad
Der ganze Sinn ist, einen Neubau zu vermeiden. Starte mit API-basierter Inferenz und wachse in volle GPU-Cluster, ohne deinen Stack neu zu architektieren. Skalieren ist eine Konfigurationsänderung, kein Migrationsprojekt.
Vor- und Nachteile
Vorteile
- Eine Plattform deckt serverlose Inferenz und dedizierte GPU-Cluster ab, was Migrationsarbeit beim Wachsen reduziert.
- Transparente Preise pro GPU-Stunde machen die Kostenplanung für rechenintensive Workloads unkompliziert.
- Der Status Reference Platform NVIDIA Cloud Partner hilft beim Zugang zu knappen GPUs der aktuellen Generation.
- Regionale Rechenzentren unterstützen Latenz- und Datenplatzierungsanforderungen für globale Produkte.
- API-Zugang zu einem breiten Modellkatalog, darunter LLMs, Sprache und Video, über einen einzigen Endpoint.
Nachteile
- Kein Gratisplan, also kostet Testen Geld, bevor du weißt, ob es passt.
- Wenig anfängerfreundlich: GPU-Stunden-Abrechnung und Bare-Metal-Optionen setzen voraus, dass du deinen Rechenbedarf kennst.
- Die Self-Service-Werkzeuge stützen sich auf Konsole und Doku, sodass die Supporttiefe je nach Plan variiert.
Häufige Fragen
GMI Cloud betreibt KI-Workloads, vor allem Modellinferenz, Training und Fine-Tuning. Du kannst Modelle über die API aufrufen oder dedizierte NVIDIA-GPUs für schwerere Jobs reservieren. Es ist Infrastruktur für Entwickler, keine Chat-App für Endnutzer.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu GMI Cloud.
Alternativen zu GMI Cloud
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.