
Google Genie 2
Google DeepMind · Bilder
Google Genie 2 ist ein fundamentales Weltmodell von DeepMind, das ein Bild in spielbare 3D-Umgebungen verwandelt. Es dient dem Training und Testen von KI-Agenten.
Über Google Genie 2
Was ist Google Genie 2
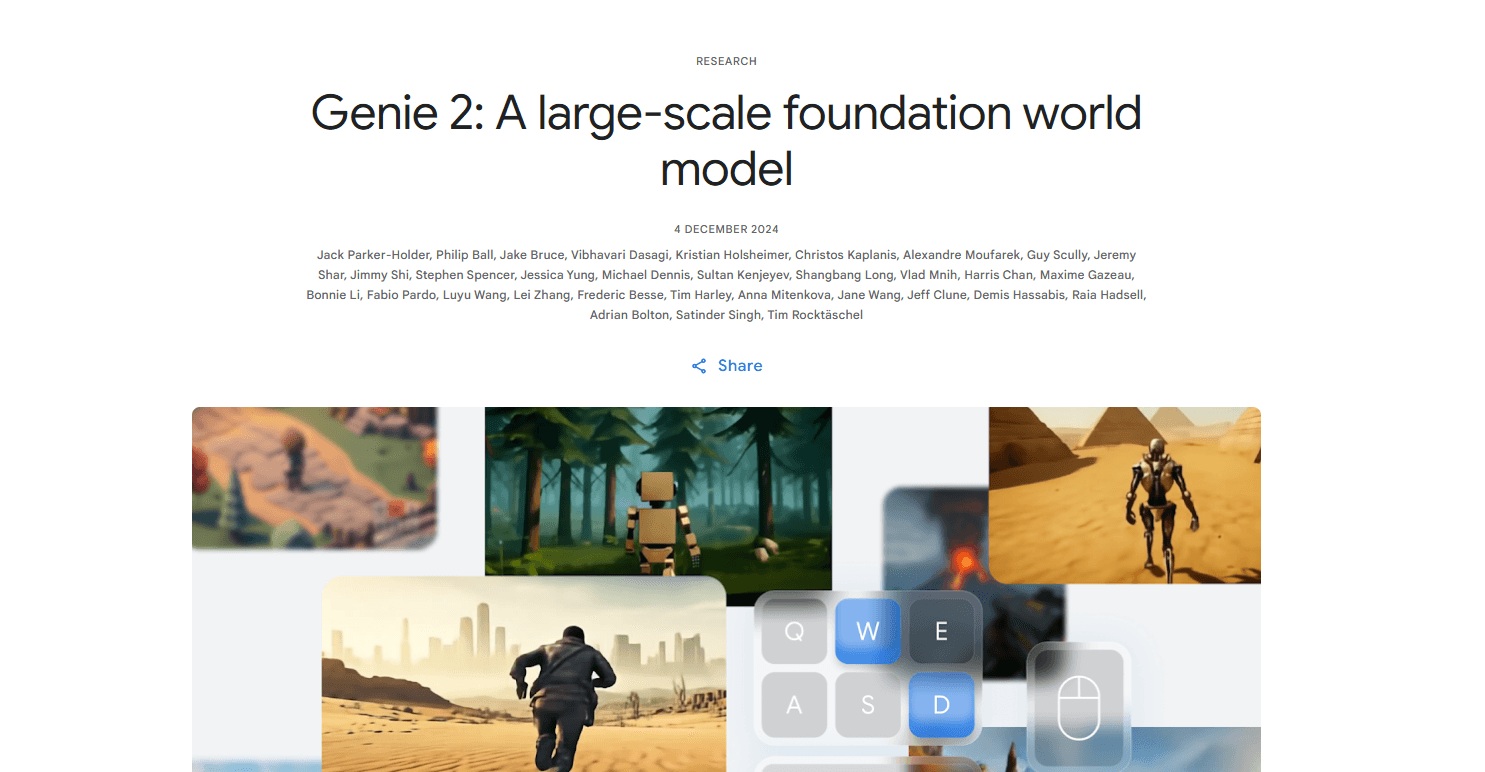
Google Genie 2 ist ein fundamentales Weltmodell von Google DeepMind und gehört zu einer neueren Klasse von KI-Weltmodellen, die Umgebungen simulieren, statt sie nur zu beschreiben. Man gibt ihm ein einziges Bild, und es baut eine kleine 3D-Welt, durch die man sich mit Tastatur und Maus bewegen kann. Das Modell erkennt, was die Figur ist, was die Kulisse ist und wie die Welt reagieren soll, wenn man eine Taste drückt. Es ist für die KI-Forschung gebaut, nicht für Spiele, die man verkaufen würde.
Das Problem, das es löst, ist ein Versorgungsproblem. Das Training eines Allzweck-Agenten braucht Tausende verschiedener Umgebungen, und solche Welten von Hand zu bauen ist langsam und teuer. Genie 2 erzeugt stattdessen einen endlosen Strom spielbarer 3D-Umgebungen, jede steuerbar und konsistent genug, um nützlich zu sein. DeepMind sieht noch einen zweiten Nutzen: Künstler und Designer können Konzeptkunst in Minuten in etwas Interaktives verwandeln, um Ideen zu prototypen. Das ist das ganze Versprechen in einem Satz. Welten auf Abruf, kein Studio nötig.
Der große Haken ist die Verfügbarkeit. Genie 2 ist eine Forschungsvorschau, es gibt also kein öffentliches Produkt, keine Anmeldung und keinen Preis. Zumindest noch nicht. Die Welten bleiben zudem höchstens etwa eine Minute lang zusammenhängend, und die beeindruckendsten Beispiele stammen aus einem nicht destillierten Modell, das nicht in Echtzeit läuft, was eine echte Einschränkung ist, wenn Sie sich hoffentlich selbst hinsetzen wollten, um eine zu erkunden. Wenn Sie auf ein Werkzeug warten, das Ihr nächstes Spiellevel erzeugt, dann ist es dieses nicht.
Erste Schritte
Da Genie 2 kein öffentliches Produkt ist, gibt es keinen normalen Anmeldeablauf. So sieht der Forschungsablauf tatsächlich aus.
- Erzeugen Sie ein Ausgangsbild, meist mit einem Text-zu-Bild-Modell wie DeepMinds Imagen 3.
- Geben Sie dieses einzelne Bild als Welt-Prompt in Genie 2 ein.
- Spielen Sie die erzeugte Welt selbst mit Tastatur und Maus oder übergeben Sie die Steuerung an einen KI-Agenten wie SIMA.
- Beobachten Sie, wie die Welt reagiert, passen Sie dann das Prompt-Bild an und wiederholen Sie den Vorgang für eine andere Umgebung.
- Nutzen Sie die entstandenen Welten als Trainings- oder Bewertungsaufgaben für einen verkörperten Agenten.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Google Genie 2.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Forscher
- Spiel- und Level-Designer
- Reinforcement-Learning-Ingenieure
Aufgaben
- Trainingsumgebungen erzeugen
- Generalisten-Agenten bewerten
- Interaktive Szenen schnell prototypen
Szenarien
- Prüfen, ob ein Agent in unbekannter Umgebung Anweisungen befolgt
- Einen hypothetischen Zweig im Training erkunden
- Eine Umgebungsidee früh in einem Projekt vorstellen
Wichtigste Funktionen
Erzeugung von Bild zu Welt
Google Genie 2 startet mit einem einzigen Bild und baut eine 3D-Umgebung darum herum. Und wie bekommt man dieses Bild? Es kann aus einem Text-zu-Bild-Modell stammen oder aus einem echten Foto. Sie beschreiben eine Welt in Text, wählen ein Rendering, das Ihnen gefällt, und steigen dann hinein. Diese niedrige Einstiegshürde ist genau der Punkt, denn Welten von Hand zu bauen ist der Engpass, den das Modell beseitigen will, für alle, die einen stetigen Vorrat an frischen, abwechslungsreichen Umgebungen brauchen statt einer Handvoll sorgfältig gestalteter.
Durch Aktionen steuerbares Spiel
Das Modell reagiert auf Tastatur- und Mauseingaben und erkennt, welches Objekt der Spieler tatsächlich steuert. Drücken Sie in einer Waldszene eine Pfeiltaste, und der Roboter bewegt sich, nicht die Bäume oder die Wolken. Das klingt banal. Ist es nicht, denn dem Modell wurde nie gesagt, welche Pixel die Figur sind, und es muss das allein aus dem Bild ableiten, bevor irgendeine Aktion etwas bedeutet. Genau diese Ableitung macht die Welten spielbar statt nur anschaubar.
Langfristiges Gedächtnis
Genie 2 merkt sich Teile einer Welt, die den Bildschirm verlassen haben, und zeichnet sie korrekt neu, wenn Sie zurückkommen. Gehen Sie hinter ein Haus. Drehen Sie sich um. Das Haus ist noch da, mit denselben Details, und das kann ein gewöhnlicher Videogenerator nicht versprechen. Diese Konsistenz unterscheidet ein Weltmodell von einem Videogenerator, und deshalb halten erzeugte Welten als Testumgebungen für Agenten stand, statt zusammenzubrechen, sobald sich Ihr Blick ändert.
Kontrafaktische Trajektorien
Vom selben Ausgangsbild aus können Sie verschiedene Aktionen ausführen und verschiedene Ergebnisse erhalten. Das gibt Forschern kontrafaktische Erfahrungen zum Trainieren, die sich aus aufgezeichnetem Video nur schwer gewinnen lassen. Video zeichnet nur den tatsächlich genommenen Pfad auf. Es weiß nicht, was passiert wäre, wenn Sie nach links abgebogen wären, und genau diese Lücke füllen Kontrafaktuale. Wenn Sie wissen wollen, wie ein Agent mit einem Zweig umgeht, den er nicht genommen hat, ist dies eine Möglichkeit, das zu simulieren.
Emergente Physik und Effekte
Genie 2 modelliert Wasser, Rauch, Schwerkraft, Beleuchtung, Reflexionen und Bloom, ohne dass ihm jedes davon ausdrücklich beigebracht wurde. Ballons platzen, Türen öffnen sich, Fässer explodieren. Die Verhaltensweisen zeigen sich in der Masse, statt von Hand programmiert zu sein. Sie sind nicht perfekt, aber sie genügen, damit sich die Welten wie Orte mit Regeln anfühlen, und jene Regeln prägen, wie Agenten um Hindernisse herum planen, die sie sehen und vorhersagen, was erstaunlich viel Struktur ist für ein Modell, das nie etwas anderes lernen sollte, als das nächste Bild zu erraten.
Simulation anderer Agenten
Das Modell kann NPCs und Interaktionen mit ihnen simulieren, dazu Charakteranimation für eine Reihe von Avataren. Für die Agentenforschung ist das wichtig, weil viele Aufgaben den Umgang mit etwas anderem erfordern, das sich bewegt und reagiert. Genie 2 gibt solchen Szenarien ein Zuhause ohne Spielestudio.
Unterstützung verschiedener Perspektiven
Welten lassen sich in Ego-Perspektive, isometrisch oder als Third-Person-Fahransicht rendern, und unterschiedliche Avatare animieren je nach Prompt. Ein Papierflieger, ein Drache, ein Falke und ein Fallschirm bekommen jeweils ihren eigenen Bewegungsstil. Diese Bandbreite kommt aus der Out-of-Distribution-Generalisation, die ein Stück Konzeptkunst in eine funktionierende, spielbare Szene verwandelt, und sie ist der Unterschied zwischen einem Modell, das seine Trainingsdaten kopiert, und einem, das improvisiert, wenn der Prompt es an neues, unbekanntes Terrain führt.
Vor- und Nachteile
Vorteile
- Erzeugt reiche 3D-Welten aus einem einzigen Bild-Prompt und senkt so die Kosten für den Bau von Trainingsumgebungen.
- Bewältigt die Aktionssteuerung intelligent und erkennt die zu bewegende Figur korrekt.
- Hält Welten bis zu einer Minute konsistent, auch Objekte, die aus dem Blickfeld geraten und zurückkehren.
- Modelliert Physik und Effekte wie Wasser, Schwerkraft und Reflexionen von selbst.
- Lässt sich mit Agenten wie SIMA kombinieren, um Bewertungsaufgaben in ungesehenen Welten zu erstellen.
Nachteile
- Keine öffentliche Veröffentlichung, keine Anmeldung und kein Preis, sodass die meisten Menschen es gar nicht nutzen können.
- Die Konsistenz der Welt endet bei etwa einer Minute, was lange Trainingsläufe einschränkt.
- Die hochwertigsten Beispiele in DeepMinds Demos stammen aus einem nicht destillierten Basismodell, das gewählt wurde, um die Obergrenze des Möglichen zu zeigen, und diese Version läuft nicht in Echtzeit, die gestochen scharfen Welten aus dem Blogbeitrag sind also nicht dieselben, mit denen Sie interagieren würden, selbst wenn Sie Zugang hätten.
- Keine öffentliche API, sodass Teams es noch nicht in eigene Pipelines einbinden können.
Häufige Fragen
Es wird genutzt, um steuerbare 3D-Umgebungen zum Trainieren und Bewerten von KI-Agenten zu erzeugen. Statt Welten von Hand zu bauen, geben Forscher dem Modell ein Bild und bekommen eine spielbare Umgebung zurück. Spielbar ist hier das Schlüsselwort. Es bedeutet, dass ein Agent wirklich handeln und Folgen sehen kann, nicht nur einen gerenderten Clip ablaufen sieht. Deshalb funktionieren diese Welten als Trainings- oder Testaufgaben und nicht als hübsche Demo-Videos.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Google Genie 2.
Alternativen zu Google Genie 2

Tractionwave
TractionWave · Bilder · MarketingTractionWave erstellt per KI eine Aufmerksamkeits-Heatmap für statische Anzeigen. Sie laden ein PNG oder JPG hoch und bekommen prognostizierte Aufmerksamkeit, sortierte Hotspots und Korrekturen, bevor Budget fließt.

Imejis.io
Imejis.io · Bilder · MarketingImejis.io ist ein KI-Designstudio für Agenten und Marketingteams. Sie beschreiben ein Bild in eigenen Worten, und das Werkzeug schreibt den Text, baut das Layout, passt es an jedes Format an und exportiert die fertige Datei.

Layoutr
Van Dijk Ontwikkeling · Bilder · KI aus ChinaLayoutr ist ein Grundriss-Tool im Browser: Es skaliert Ihren vorhandenen Plan, stellt Möbel in echter Größe ab, zeigt den Raum in 3D und rendert ihn mit KI.