
Griffin by Tavus
Tavus · Stimme & Sprache · Video · Chatbot
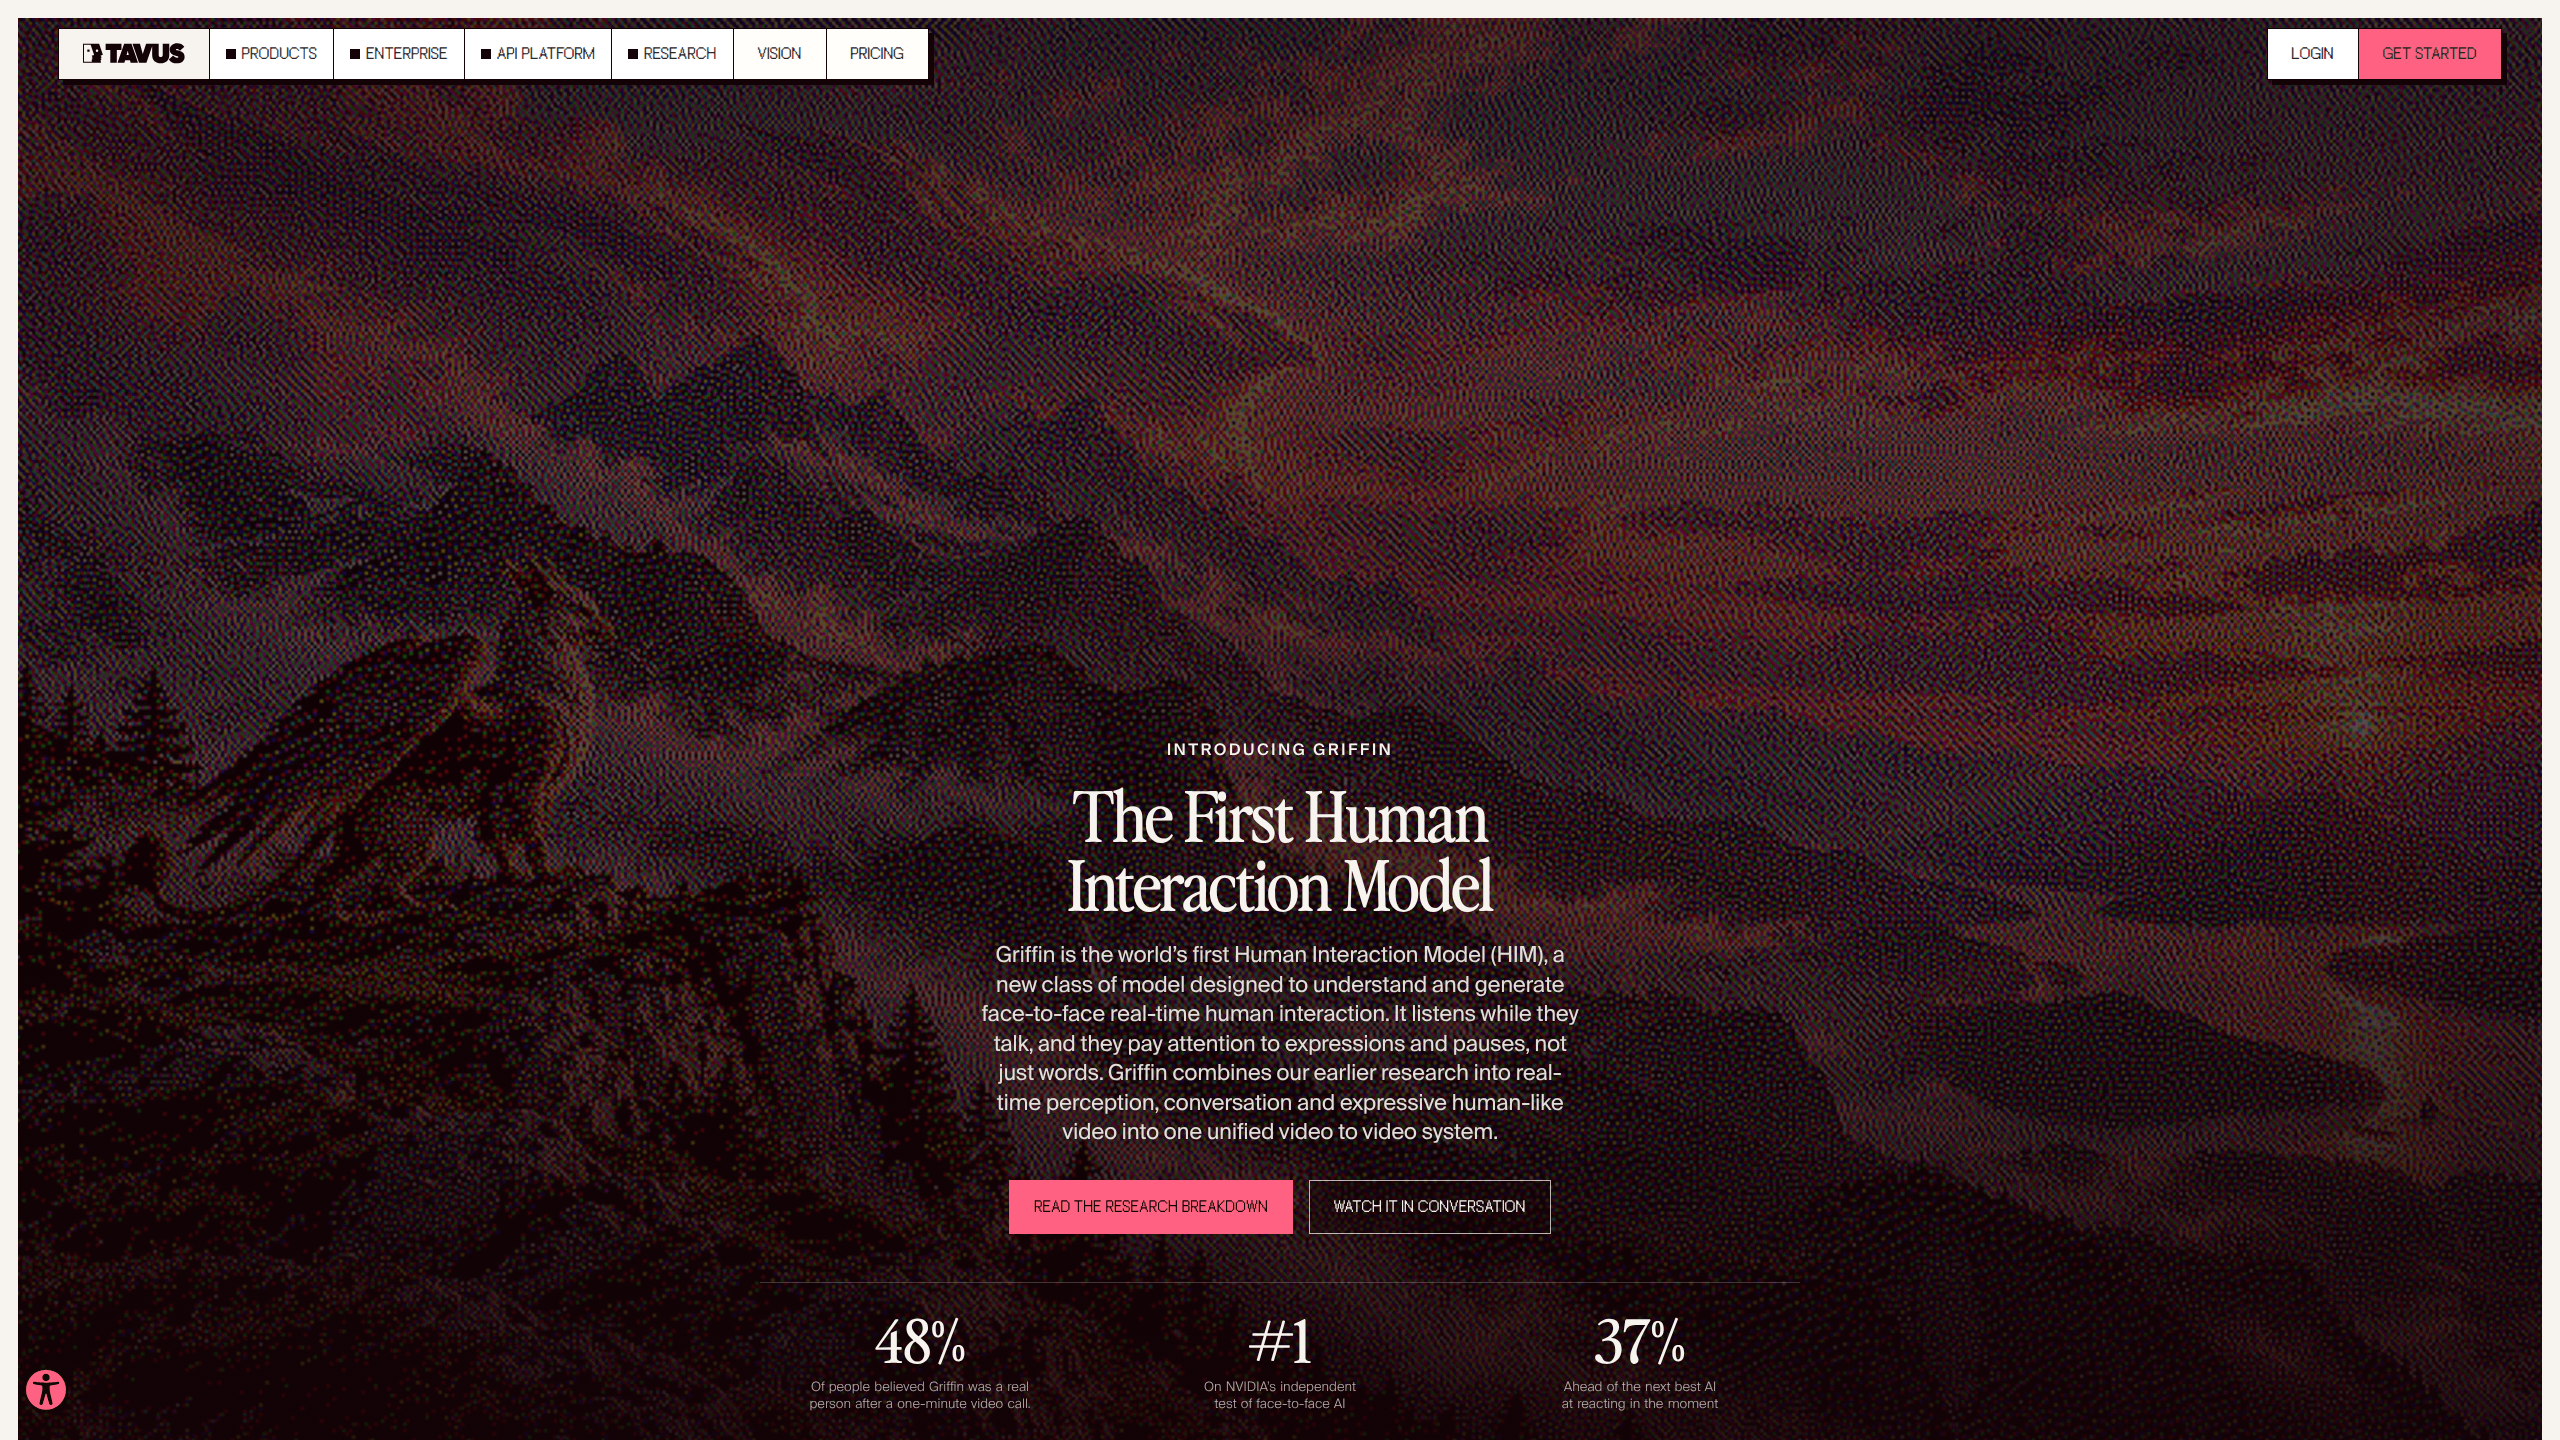
Griffin by Tavus ist das erste Modell für menschliche Interaktion: ein Full-Duplex-System von Video zu Video, das in einem KI-Videoanruf in Echtzeit beobachtet, zuhört und antwortet.
Über Griffin by Tavus
What Is Griffin by Tavus
Griffin ist ein Forschungsmodell von Tavus, das ein Gespräch von Angesicht zu Angesicht in einem Videoanruf führt. Es liest Kamera und Mikrofon gleichzeitig, entscheidet, wann es spricht, und erzeugt Gesicht und Stimme des Gegenübers während des Gesprächs. Tavus hat das Modell am 1. Oktober 2026 veröffentlicht und nennt es das erste Modell für menschliche Interaktion, kurz HIM.
Der Aufbau bricht mit dem üblichen Weg der Videokonversation mit KI. Fast alle Systeme verketten Spracherkennung, Sprachmodell, Sprachsynthese und einen Avatar-Renderer und warten, bis Sie ausgesprochen haben. Griffin entscheidet in Bruchteilen einer Sekunde. So kann es nicken, während Sie reden, eine Pause als Nachdenken lesen und den Faden wieder aufnehmen, wenn Sie dazwischenreden.
Der Preis dafür ist der Zugang. Griffin-Lite, die heute verfügbare Version, ist eine Forschungsvorschau für wenige ausgewählte Tester. Tavus sagt, das Modell sei noch nicht auf der eigenen Plattform, es gebe keine veröffentlichten Preise und keine öffentliche API. Die Zahl von 48% stammt aus einer Studie des Unternehmens selbst, mit 54 Personen und Anrufen von einer Minute.
Getting Started
- Öffnen Sie tavus.io/griffin und senden Sie das Antragsformular. Der Zugang läuft über Einladungen, ein Registrierungsbutton verschafft Ihnen also keinen Platz.
- Wenn Sie angenommen werden, treten Sie dem KI-Videoanruf über den zugesandten Link bei. Auf Ihrem Rechner wird nichts installiert.
- Geben Sie Kamera und Mikrofon frei und sprechen Sie wie mit einer Kollegin. Der KI-Avatar erzeugt seine Antwort, während Sie sprechen.
- Testen Sie jeweils ein Verhalten. Unterbrechen Sie mitten im Satz, halten Sie inne oder halten Sie einen Gegenstand in die Kamera und beobachten Sie, was das Modell damit macht.
- Behandeln Sie die Sitzung als Test. Es gibt kein Dashboard, keinen Export und keine Abrechnungsseite, denn Griffin-Lite ist kein Produkt für Kunden.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Griffin by Tavus.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Produktteams, die Videoagenten in Echtzeit bauen
- Teams in der Weiterbildung
- Forschende zu konversationeller KI
Aufgaben
- Ein Verkaufsgespräch üben
- Vorstellungsgespräche vorbereiten
- Sprachen üben
- Eskalationen im Support vorbereiten
Szenarien
- Prüfen, ob ein Videoagent in einen Ablauf passt
- Unterbrechungen vor der Entwicklung testen
- Ein reguliertes Gespräch bewerten
Wichtigste Funktionen
Voll-Duplex-Gespräch
Griffin hört zu, während es spricht. Es kann den Turn halten, abgeben oder stoppen, wenn Sie dazwischenreden, und verfolgt das Gespräch während der eigenen Antwort weiter. Tavus hat das als durchgehende Schleife gebaut und nicht als Übergabe von Turn zu Turn. Darum beendet eine Pause in Ihrem Satz nicht automatisch Ihren Redebeitrag.
Erzeugung der ganzen Szene
Das Modell erzeugt jedes Pixel im Bild aus einem einzigen Referenzfoto. Das umfasst Gesicht, Hände, den Stuhl, auf dem die Person sitzt, Schatten und Hintergrund. Die meisten Avatar-Systeme bewegen einen freigestellten Kopf, sodass eine bewegte Hand die Illusion zerstört. Griffin hat diese Nahtstelle nicht.
720p in Echtzeit
Das Video kommt als Echtzeitvideo in 720p aus dem laufenden Anruf, ein Latent nach dem anderen. Tavus hat auf einer H100 im Schnitt 0,43 Sekunden für das kleinste Videostück gemessen, im besten Fall 0,27 Sekunden. Im Gespräch zählt der Abstand zwischen Ihrer Unterbrechung und der Reaktion des Gesichts, und eine halbe Sekunde wirkt bereits aufmerksam.
Visuelle Wahrnehmung
Griffin nimmt Video auf, nicht nur Ton. Es erfasst Blickrichtung, Mimik, Gesten und Gegenstände, die Sie in die Kamera halten, und liest einen geteilten Bildschirm. So reagiert es, wenn Sie ein defektes Teil hochhalten oder zum Nachdenken wegschauen, statt nur das Transkript Ihrer Worte zu beantworten.
Verhalten und Emotion
Das Modell ändert Ton, Ausdruck und Gestik mit dem Kontext des Gesprächs. Es lacht im richtigen Moment, wird ernst, wenn das Thema kippt, und bestätigt mit nonverbalen Signalen, was Sie gesagt haben. Tavus hat diese Verhaltensweisen im selben System trainiert, das über den Inhalt entscheidet, nicht als nachträglich aufgesetzte Schicht.
Stimmklon aus kurzem Audio
Der Sprachgenerator von Griffin klont eine Stimme aus etwa zehn Sekunden Referenzaudio. Er läuft auf Tavec, dem Audiocodec von Tavus, der in Paketen von bis zu 10 Millisekunden streamt. Wer einen eigenen Marken-Avatar baut, spart sich mit dieser kurzen Probe eine Aufnahmesitzung.
Vor- und Nachteile
Vorteile
- 48% der Teilnehmenden an Tavus' Live-Studie glaubten, mit einem Menschen zu sprechen, gegenüber 2,4% beim bisherigen Phoenix-4.5-Stack des Unternehmens.
- Griffin-Lite erreicht 3,83 auf der Generierungsspur von NVIDIAs VideoFDB, mit der menschlichen Referenz bei 3,92 und dem nächsten KI-System bei 2,80.
- Es verkraftet Unterbrechungen und Zwischenrufe, ohne den Faden zu verlieren. Genau dort brechen verkettete Sprach- und Avatar-Pipelines meist zusammen.
- Die Szenengenerierung bewegt Hände, Haltung und Hintergrund mit dem Gespräch, statt sie einzufrieren.
- Der Stimmklon braucht rund zehn Sekunden Audio, ein eigener KI-Avatar ist damit schnell aufgesetzt.
Nachteile
- Kaufen lässt es sich nicht. Griffin-Lite ist auf freigegebene Tester beschränkt, einen allgemeinen Starttermin gibt es nicht, also kann kein Team einen Launch darauf planen.
- Es gibt keine öffentliche API, keine Modellkennung und keinen Preis. Entwickler können es weder im eigenen Stack messen noch einplanen.
- Die 48% beruhen auf 54 Personen und Ein-Minuten-Anrufen des Herstellers. Lange Gespräche und unabhängige Wiederholungen sind ungetestet.
- Die Wahrnehmungsspur zeigt einen echten Abstand: 3,73 gegen 4,20 bei Menschen, mit 2,2 Sekunden Antwortzeit gegen 1,4. Komplexer visueller Kontext bringt das Modell noch durcheinander.
Häufige Fragen
Griffin ist ein Full-Duplex-Modell von Video zu Video, das ein Gespräch von Angesicht zu Angesicht in Echtzeit führt. Tavus nennt es ein Modell für menschliche Interaktion, weil Wahrnehmung, Gesprächsführung und audiovisuelle Erzeugung in einem System laufen, statt separate Sprach-, Sprachmodell- und Avatar-Systeme zu verketten.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Griffin by Tavus.
Alternativen zu Griffin by Tavus

Foley
Hanamori Labs, LLC · Stimme & Sprache · Produktivität · KI-AssistentFoley ist eine Sprach-To-do-Liste: Ein gesprochener Satz wird zur einsortierten Aufgabe mit Projekt, Datum und Uhrzeit, und danach plant die App den Tag um das, was schon auf der Liste steht.

HireKey
HireKey · Stimme & Sprache · Produktivität · LernenHireKey ist ein KI-Copilot für die Jobsuche, entwickelt von einer erfahrenen Tech-Recruiterin. Er prüft die Passung, passt den Lebenslauf an, trainiert Interviews und sammelt jede Bewerbung.

Fluence
Yay Software (Yannick Huchard) · Schreiben · Stimme & Sprache · ProduktivitätFluence ist eine Android-App, die PDF, EPUB, Word-Dateien und Web-Artikel vorliest, den gesprochenen Satz mitführt und Fragen zum Text direkt auf dem Telefon beantwortet.