
Helicone
Helicone, Inc. · Coding
Helicone ist eine Open-Source-Plattform für LLM-Observability und ein KI-Gateway. Eine geänderte Basis-URL reicht, um jeden Prompt zu protokollieren, Kosten zu verfolgen und über 100 Modelle zu routen.
Über Helicone
About
Was ist Helicone
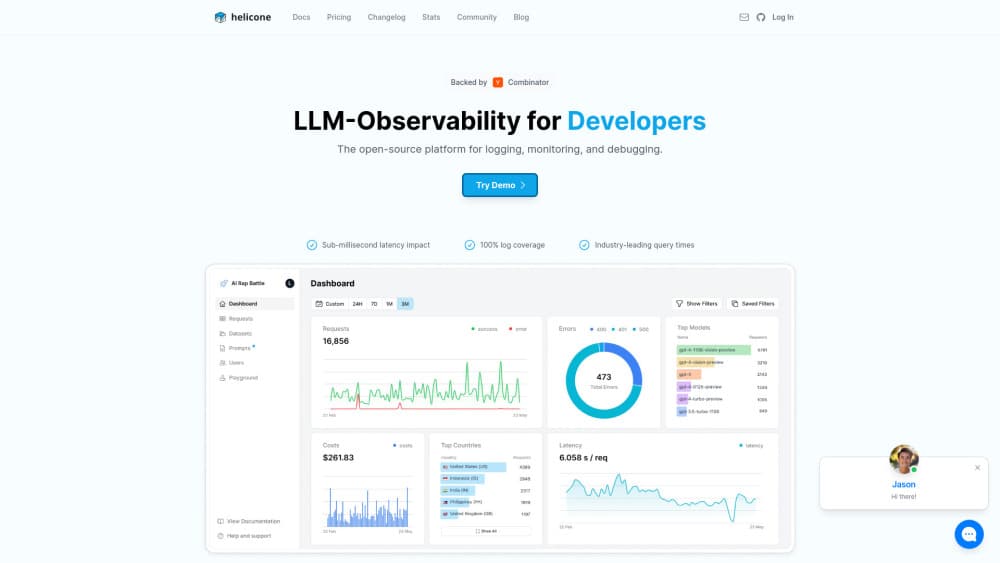
Helicone sitzt zwischen Ihrer Anwendung und dem Modellanbieter. Sie richten das OpenAI-SDK auf die Adresse des Gateways, oder Sie hängen die Proxy-URL an die Aufrufe, die Sie ohnehin machen, und jede Anfrage erscheint in einem Dashboard mit Prompt, Antwort, Token-Zahl, Kosten und Latenz.
Damit beantworten Sie Fragen, die eine Woche nach dem Start auftauchen. Warum der Chat eines Kunden 40 Cent kostet. Welcher Prompt die JSON-Ausgabe zerstört hat. Ob die Verzögerung von Ihrem Server oder vom Anbieter kommt. Request-Logs bleiben durchsuchbar, und Sie gruppieren sie nach Nutzer, Sitzung oder einer eigenen Property.
Das Projekt ist Open Source unter Apache 2.0, mit einer selbst gehosteten Variante für Teams, die keine Prompts an Dritte schicken. Zwei Grenzen entscheiden, wer wirklich davon profitiert. Sie brauchen Zugriff auf den Code, der das Modell aufruft, denn die Einrichtung besteht aus einer neuen Basis-URL und einem Header. Die Evaluationsseite ist schlanker als bei spezialisierten Plattformen, deshalb behalten Teams mit vielen Experimenten ein zweites Werkzeug.
Erste Schritte
- Legen Sie das kostenlose Konto an und erzeugen Sie einen API-Schlüssel in den Einstellungen.
- Richten Sie Ihren OpenAI-Client auf das Helicone-Gateway, oder schicken Sie bestehende Aufrufe über die Proxy-URL mit einem Helicone-Auth-Header.
- Senden Sie eine Anfrage und öffnen Sie den Requests-Tab; der Eintrag steht in Sekunden da.
- Versehen Sie Aufrufe mit eigenen Properties wie Nutzer-ID oder Tarif, damit sich Kosten später aufteilen lassen.
- Setzen Sie einen Alarm auf Kosten oder Fehlerquote und laden Sie das Team ein.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Helicone.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwicklungsteams mit LLM-Funktionen in Produktion
- Einzelentwickler und kleine Startups
- Plattform- und DevOps-Teams
- Teams mit Datenschutzvorgaben
Aufgaben
- Eine schlechte Antwort debuggen
- Kosten beobachten
- Anbieter wechseln
- Prompts vergleichen
- Nutzung prüfen
Szenarien
- Ein Chatbot, der nach dem Start teuer wurde
- Ein Prototyp, der diese Woche drei Modelle testen muss
- Eine regulierte Umgebung
Wichtigste Funktionen
Integration in einer Zeile
Die Einrichtung ist eine neue Basis-URL plus API-Schlüssel, ein bestehender Client für OpenAI, Anthropic, Azure oder LiteLLM behält also seine Codeform. Auf dem Server ist nichts zu installieren, kein Agent läuft mit, und deshalb sehen Teams ihre Logs am selben Nachmittag. Der Proxy-Weg funktioniert mit jeder Sprache, die eine HTTP-Anfrage senden kann.
Request-Logs und Traces
Jeder Eintrag speichert den vollständigen Prompt, die Antwort des Modells, Token-Zahlen, Latenz und berechnete Kosten. Sie filtern nach Modell, Status, Zeitraum oder eigener Property und öffnen dann eine einzelne Anfrage, um zu sehen, wo die Zeit geblieben ist. Prompt-Logging auf diesem Niveau macht aus einer vagen Beschwerde eine konkrete Textzeile, die Sie ändern können.
KI-Gateway mit Cache und Fallback
Das KI-Gateway ist ein OpenAI-kompatibler Endpunkt für über 100 Modelle von OpenAI, Anthropic, Google, Vertex, Groq und anderen. Es bringt Antwort-Cache, Rate Limits pro Schlüssel und automatische Fallbacks mit, wenn ein Anbieter ausfällt, und Credits werden zum Anbieterpreis ohne Aufschlag abgerechnet. Eigene Anbieterschlüssel lassen sich weiterhin verwenden, wenn die Abrechnung getrennt bleiben soll.
Analyse von Nutzern und Sitzungen
Eigene Properties hängen eine Nutzer-ID, einen Tarif, einen Funktionsnamen oder ein anderes Etikett an eine Anfrage. Sitzungen fassen danach ein Gespräch mit mehreren Runden in eine Ansicht zusammen, und Sie sehen Kosten und Länge eines echten Kundenverlaufs. Für ein Support-Team ist das der Unterschied zwischen «der Bot ist langsam» und «dieses Konto löst jedes Mal einen Tool-Aufruf von 12 Sekunden aus».
Playground und Prompt-Verwaltung
Der Playground schickt Prompts parallel an mehrere Modelle und zeigt die Reasoning-Einstellungen bei Modellen, die sie anbieten. Prompts lassen sich speichern, versionieren und aus dem Code wiederverwenden, Ausgaben bekommen Bewertungen, damit eine Änderung nach Ergebnis beurteilt wird und nicht nach Gefühl. So testen Sie ein günstigeres Modell, bevor echter Traffic darauf läuft.
Alarme, Berichte und HQL
Alarme lösen bei Schwellen für Kosten, Fehlerquote oder Latenz aus, geplante Berichte schicken eine Zusammenfassung per E-Mail oder Slack. HQL, die eingebaute Abfragesprache, beantwortet, was die Filter im Dashboard nicht ausdrücken, etwa Kosten pro Nutzer über 30 Tage. Ergebnisse gehen per Export oder API in Ihr Warehouse.
Open Source und Self-Hosting
Der Code ist unter Apache 2.0 öffentlich, mit Tausenden Sternen auf GitHub und regelmäßigen Releases. Wer Open-Source-LLM-Observability selbst betreiben will, findet alle Teile des Stacks im Repository. Sie betreiben den ganzen Stack mit Docker in Ihrer eigenen Cloud, was zählt, wenn Prompts Kundendaten enthalten, die die Rechtsabteilung nicht herausgeben lässt. Gehostete und selbst gehostete Version teilen Dashboard und API.
Vor- und Nachteile
Vorteile
- Eine neue Basis-URL startet das Logging, ohne SDK-Umbau und ohne Migrationsprojekt.
- Das Gateway deckt über 100 Modelle zum Anbieterpreis ohne Aufschlag ab, mit Cache und Fallbacks im selben Schlüssel.
- Open Source unter Apache 2.0, mit einem Self-Hosting-Weg für Teams mit Datenschutzvorgaben.
- Der kostenlose Tarif ist brauchbar und keine Demo: 10.000 Anfragen pro Monat, 1 GB Speicher, keine Karte nötig.
- Kosten, Latenz und Fehler stehen auf einem Bildschirm pro Anfrage, pro Nutzer und pro Sitzung, die Tabellenarbeit entfällt.
Nachteile
- Das Werkzeug ist für Entwickler gebaut. Ohne Zugriff auf den Code, der das Modell aufruft, hat das Dashboard nichts zu zeigen.
- Evaluation und Datensätze sind dünner als bei spezialisierten Plattformen, wer Experimente ernsthaft verfolgt, braucht ein zweites Werkzeug.
- Pro beginnt bei 79 $/Monat, und die nutzungsabhängige Abrechnung von Anfragen und Speicher macht die Rechnung bei wachsendem Traffic schwer kalkulierbar.
- Der kostenlose Tarif hält Logs 7 Tage und 1 GB vor, jede langfristige Historie verlangt also einen bezahlten Tarif.
Häufige Fragen
Es protokolliert und analysiert die Aufrufe, die Ihre Anwendung an LLM-Anbieter schickt. Sie bekommen Request-Logs mit Prompts, Antworten, Tokens, Kosten und Latenz, dazu ein Gateway, das diese Aufrufe an über 100 Modelle weiterleitet.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Helicone.
Alternativen zu Helicone

Udon
Udon · Coding · ProduktivitätUdon macht aus einem Apple-Silicon-Mac einen Heimserver, den Sie im Browser steuern, mit Containern, Dateifreigaben und einem optionalen KI-Systemadministrator.

offstage
offstage cloud · Coding · Produktivitätoffstage gibt KI-Agenten und CI-Jobs einen echten Mac: ein frisches macOS-27-Konto auf Apple Silicon, per API gesteuert und sekundengenau abgerechnet.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Coding · ProduktivitätMit BotBus lassen sich KI-Agenten vom Smartphone steuern, auch wenn der Rechner im Büro steht: Befehle freigeben, Aufgaben starten, Ergebnisse lesen.