
Honcho
Plastic Labs · Coding
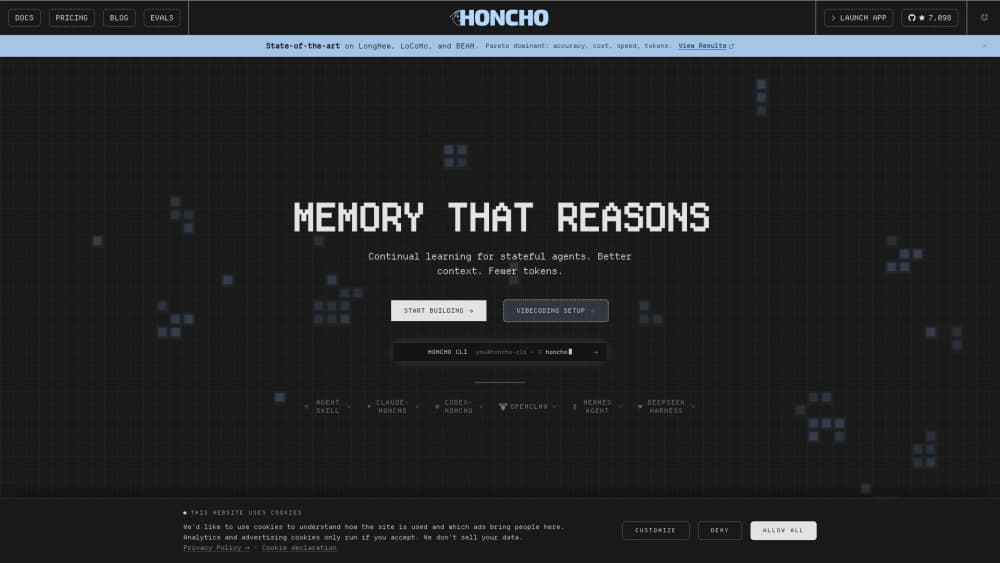
Honcho ist eine Plattform für KI-Gedächtnis von Plastic Labs, die zustandsbehafteten Agenten über Sitzungen hinweg persistenten Kontext gibt. Statt Fakten zu speichern und später abzurufen, schließt sie aus allem, was ein Nutzer sagt, auf ein Modell dieser Person, das sich mit der Zeit verändert. Entwickler erreichen sie über eine gehostete API oder einen selbst gehosteten Stack, und sie lässt sich in Tools wie Claude Code, Codex und OpenClaw einbinden.
Über Honcho
Was Honcho ist
Honcho ist eine Gedächtnis- und Kontextschicht für KI-Agenten. Das Unternehmen dahinter, Plastic Labs, beschreibt sie als Open-Source-Gedächtnisbibliothek mit einem Managed Service, sodass Sie sie selbst betreiben oder für die gehostete Version bezahlen können. Das Versprechen ist einfach: Die meisten Agenten vergessen, widersprechen sich oder verlieren zwischen Sitzungen den Faden, und Honcho soll das beheben.
Der Kern der Idee: Gedächtnis ist Schlussfolgern, nicht Speichern. Ein einfacher Faktenstore merkt sich, dass ein Nutzer einmal ein Nebenprojekt erwähnt hat. Honcho verfolgt, was dieses Projekt ist, wie oft es zur Sprache kommt und wie wichtig es der Person zu sein scheint. Jede eingehende Nachricht löst dieses Schlussfolgern aus, und so will das System nachgelagert Tokens sparen und zugleich reicheren Kontext liefern.
Es gibt echte Grenzen, die man kennen sollte. Honcho ist Entwicklerinfrastruktur, keine Verbraucher-App, also braucht man etwas Programmierkenntnis, um sie gut zu nutzen. Sie schlussfolgert außerdem für Sie, was heißt, dass Sie das Urteil darüber abgeben, was zählt, und dem Ergebnis vertrauen. Teams, die volle Kontrolle über jeden Abrufschritt brauchen, könnte dieser Kompromiss unangenehm sein. Für wen ist das also wirklich?
Erste Schritte
- Legen Sie ein Konto unter app.honcho.dev an und holen Sie sich einen API-Schlüssel aus dem Dashboard.
- Installieren Sie das SDK für Ihren Stack:
pip install honcho-aifür Python,npm install @honcho-ai/sdkfür TypeScript. - Richten Sie einen Workspace ein und definieren Sie die Peers, die Ihr Agent verfolgen soll, etwa einen Nutzer und einen Assistenten.
- Fügen Sie Nachrichten zu Sitzungen hinzu, damit Honcho beginnt, Zustand aufzubauen und über jeden Peer zu schlussfolgern.
- Fragen Sie die synthetisierten Erkenntnisse ab und speisen Sie sie zurück in die Prompts Ihres Agenten.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Honcho.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler, die Chat-Agenten bauen
- Teams, die Begleit- oder Coaching-Apps ausliefern
- Solo-Entwickler auf Claude Code oder Codex
Aufgaben
- Nutzerprofile über Sitzungen hinweg führen
- Prompt-Tokens reduzieren
- Widersprüche und Drift behandeln
Szenarien
- Langlebige Assistenten, die sich an frühere Gespräche erinnern müssen
- Multi-Agenten-Setups, in denen mehrere Agenten Zustand über dieselben Entitäten teilen.
- Das Prototyping einer Gedächtnisschicht, bevor man sich für einen Eigenbau entscheidet.
Wichtigste Funktionen
Schlussfolgerndes Gedächtnis
Honcho speichert und ruft nicht nur ab. Es läuft bei jeder Nachricht ein Schlussfolgerungsdurchlauf, um herauszuziehen, was zählt, und darin liegt der zentrale Unterschied zu einem einfachen Vektorspeicher oder einer RAG-Pipeline. Dieser Durchlauf lässt das System die sich ändernden Vorlieben eines Nutzers verfolgen, statt sie bei der ersten Erwähnung einzufrieren. Gewaltiger Unterschied.
Vier Speicherprimitive
Das System baut auf Workspaces, Peers, Sitzungen und Nachrichten auf. Workspaces trennen verschiedene Apps oder Umgebungen, Peers stehen für jede Entität, die fortbesteht und sich ändert, Sitzungen bündeln Gespräche, und Nachrichten sind die rohe Eingabe. Peers verbinden sich in einer Viele-zu-viele-Beziehung mit Sitzungen, sodass eine Person viele Threads umspannen kann. Diese Struktur ist bewusst einfach.
Gehostete API und Selbsthosting
Sie können den Managed Service abonnieren und die Infrastrukturarbeit überspringen oder die CLI installieren und einen lokalen Stack mit Docker betreiben. Der Selbsthosting-Weg verlangt Ihren eigenen LLM-Anbieter-Schlüssel, hält Ihre Daten aber auf Ihren eigenen Maschinen. Beide Wege legen dieselbe Kern-API offen. Nehmen Sie, was passt.
Direkte Integrationen
Honcho liefert Plugins für Claude Code, OpenAI Codex, OpenClaw und Hermes Agent. Die meisten lassen sich mit einem einzigen Befehl installieren und registrieren Hooks, die Gespräche leise ins Gedächtnis einspeisen. Für Entwickler, die ohnehin in einem dieser Tools leben, ist das der schnellste Weg, es auszuprobieren.
Neuromancer-Schlussfolgerungsmodelle
Plastic Labs hat eigene Schlussfolgerungsmodelle namens Neuromancer gebaut, um die Lernschleife anzutreiben. Das Unternehmen sagt, diese Modelle erreichten in Gedächtnis-Benchmarks Spitzengenauigkeit bei geringeren Kosten und Latenz als Frontier-Modelle. Betrachten Sie das als Anbieteraussage, bis Sie eigene Zahlen messen. Ihre können abweichen.
Python- und TypeScript-SDKs
Offizielle SDKs decken die zwei gängigsten Agenten-Stacks ab. Sie initialisieren einen Client, erstellen Peers und fügen Nachrichten hinzu, ohne rohes HTTP anzufassen. Die SDKs sind der empfohlene Weg, und die zugrunde liegende REST-API steht jeder Sprache offen.
Vor- und Nachteile
Vorteile
- Schlussfolgert über Kontext, statt ihn nur zu speichern, was zu Agenten passt, die sich Nutzern mit der Zeit anpassen müssen.
- Open Source mit einer Managed Option, sodass Sie selbst hosten oder zahlen können, um die Betriebsarbeit zu überspringen.
- Neue Konten erhalten $100 Gratisguthaben, und ein Schnellstart-Durchlauf kostet nur ein paar Cent.
- Funktioniert mit jedem Modell oder Framework und liefert fertige Plugins für gängige Coding-Agenten.
- Behandelt Widersprüche und langfristige Muster, die einfache RAG-Setups oft übersehen.
Nachteile
- Es ist Entwicklerinfrastruktur, also kommen Nicht-Programmierer ohne Hilfe nicht weit.
- Der Schlussfolgerungsschritt fügt Latenz und Kosten pro Nachricht hinzu, was bei hohem Volumen zählt.
- Die Preise jenseits des Gratisguthabens sind nicht klar veröffentlicht, das Budgetieren braucht also etwas Rätselraten.
- Das Urteil an das System abzugeben bedeutet weniger Kontrolle darüber, was genau erinnert wird.
Häufige Fragen
Honcho gibt KI-Agenten ein persistentes Gedächtnis. Es nimmt Nachrichten auf, schlussfolgert über sie und erzeugt Kontext zu jedem Nutzer oder jeder Entität, damit Ihr Agent über Sitzungen hinweg stimmig bleibt, statt jedes Mal von vorn zu beginnen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Honcho.
Alternativen zu Honcho
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.