

HunyuanVideo-Avatar
Tencent Hunyuan · Bilder · Video
HunyuanVideo-Avatar ist das offene Modell von Tencent, das aus einem Bild und einer Audiospur ein sprechendes oder singendes Video macht, mit Emotionssteuerung und mehreren Figuren.
Über HunyuanVideo-Avatar
What Is HunyuanVideo-Avatar
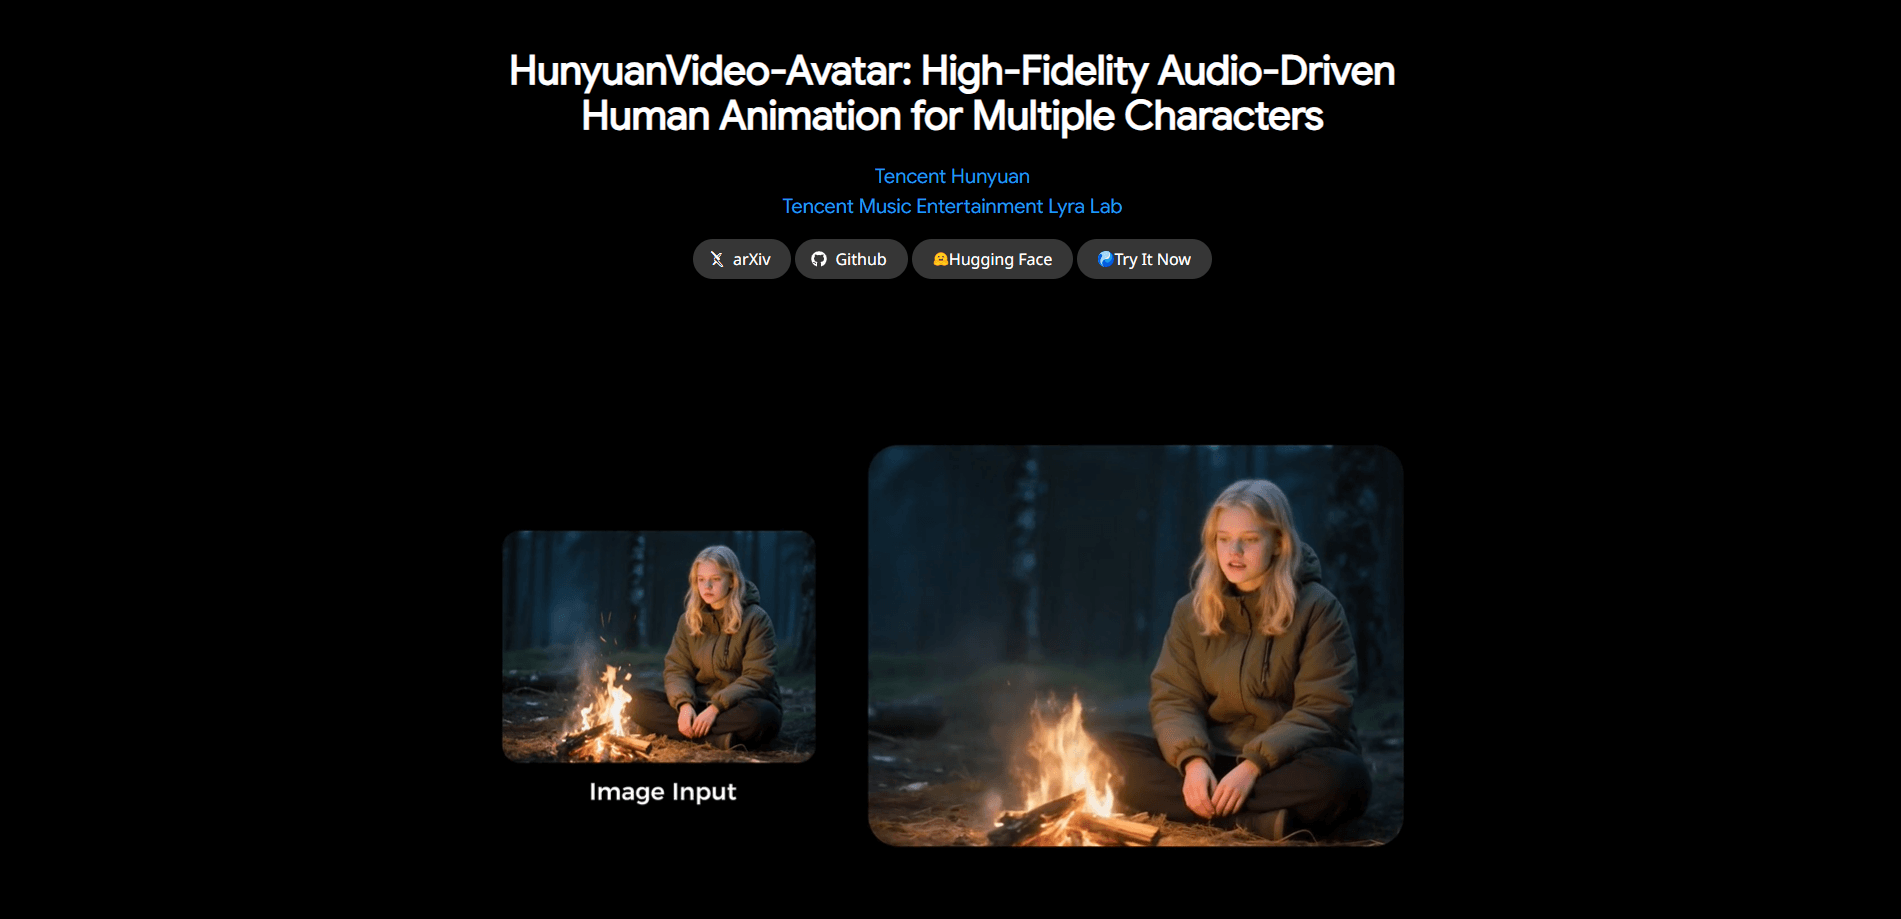
HunyuanVideo-Avatar ist ein offenes Modell für audiogesteuerte menschliche Animation, entwickelt von Tencent Hunyuan gemeinsam mit dem MuseV-Team des Lyra Lab von Tencent Music und veröffentlicht im Mai 2025. Sie geben ihm ein einzelnes Porträt und eine Tonspur, und es liefert ein Video zurück, in dem sich das Gesicht bewegt, die Lippen zur Sprache passen und die Figur vom ersten bis zum letzten Bild dieselbe Identität behält.
Fast jedes Lippen synchronisierende Werkzeug hört am Mund auf. Dieses bewegt das ganze Bild, von Kopf und Schultern bis zum ganzen Körper, und es liest die Emotion aus einem Referenzbild, sodass derselbe Clip fröhlich oder ernst herauskommen kann. Es bewältigt auch mehrere Personen in einer Szene, jede an ihre eigene Tonspur gebunden, wo frühere Modelle die Gesichter verschwimmen ließen. Die Ausgabe reicht bis 720p, und der offizielle Spielplatz begrenzt Uploads auf etwa 14 Sekunden Audio.
Es ist keine Ein-Klick-Webseite für jedermann. Das Modell kommt als Code und Gewichte, die Sie selbst herunterladen und ausführen, also brauchen Sie für die direkte Nutzung eine NVIDIA-GPU und eine ordnungsgemäße Python-Umgebung. Eine gehostete Vorschau gibt es auf der Hunyuan-Seite von Tencent, doch die tieferen Funktionen mit mehreren Figuren stecken in der offenen Version. Rechte und Einwilligung für jedes Gesicht oder jede Stimme, die Sie animieren, liegen bei Ihnen, nicht beim Modell.
Getting Started
- Gehen Sie zum offiziellen GitHub-Repository und klonen Sie es, dann richten Sie eine Python-3.10-Umgebung mit einer CUDA-fähigen NVIDIA-GPU ein.
- Installieren Sie die im README gelisteten Abhängigkeiten von PyTorch und FlashAttention und laden Sie die vortrainierten Gewichte herunter.
- Wählen Sie ein klares, nach vorn gerichtetes Porträt als Bild der Figur und bereiten Sie einen sauberen Audio-Clip mit Sprache oder Gesang vor.
- Führen Sie das Inferenzskript aus und wählen Sie den Einzel- oder Mehr-GPU-Modus je nach Hardware und Speicher.
- Prüfen Sie das gerenderte Video, passen Sie bei Bedarf Auflösung oder Bildausschnitt an und exportieren Sie das Ergebnis.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von HunyuanVideo-Avatar.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Kurzvideo-Macher
- Entwickler und Forscher
- E-Commerce- und Livestream-Teams
- Zeichen- und 3D-Künstler
Aufgaben
- Ein Porträt in ein sprechendes Video verwandeln
- Einen Gesangsclip produzieren
- Die Emotion steuern
- Eine Szene mit zwei Personen animieren
- Eine eigene Pipeline bauen
Szenarien
- Produktvideos schnell auffrischen
- Eine Fassung in einer anderen Sprache erstellen
- Einen Podcast in ein Video verwandeln
- Ein Avatar-Konzept erproben
Wichtigste Funktionen
One Image Plus Audio
Der eigentliche Kniff ist leicht zu beschreiben und schwer zu meistern: Sie übergeben ein einzelnes Porträt und eine Tonspur, und das Modell liefert ein Video zurück, in dem die Figur mit passenden Lippen und natürlicher Körperbewegung spricht oder singt. Es nimmt Bilder in unterschiedlichen Größen und Auflösungen, also funktionieren sowohl ein enger Ausschnitt als auch eine Ganzkörperaufnahme als Eingabe. Diese Funktion spart einen Drehtag, denn ein Standfoto ersetzt eine gefilmte Darbietung.
Emotion-Controllable Expression
Ein Audio-Emotionsmodul liest emotionale Hinweise und überträgt sie auf das Gesicht der Figur, sodass der Ausdruck der Stimmung des Audios folgt statt flach zu bleiben. Ein Referenzbild lenkt diese Emotion, was bedeutet, dass dieselbe Sprachzeile je nach Eingabe fröhlich oder ernst wirken kann. Wer schon einen steifen Avatar ein Skript vorlesen sah, erkennt hier den Teil, der das Ergebnis lebendig wirken lässt.
Multi-Character Dialogue
Der Modus mit mehreren Figuren lässt mehrere Personen eine Szene teilen, jede von ihrem eigenen Audio gesteuert, was früheren Modellen schwerfiel, auseinanderzuhalten. Ein gesichtserkennender Audio-Adapter maskiert jedes Gesicht, damit die Stimme der einen Figur nicht auf den Mund der anderen überspringt. So wird ein Podcast mit zwei Moderatoren oder ein Hin-und-her-Interview zu einem einzigen Video statt zu zwei Clips, die Sie von Hand ausrichten. Das ist der stärkste Grund, dieses Modell einem einfachen Gesichtstausch-Werkzeug vorzuziehen.
Multi-Style and Multi-Scale Characters
Das Modell arbeitet gleich bei fotorealistischen Gesichtern, Zeichnungen, 3D-Renderings und anthropomorphen Figuren, also bekommt ein stilisiertes Maskottchen dieselbe Behandlung für Lippen und Bewegung wie ein realer Moderator. Es erzeugt außerdem in Porträt-, Oberkörper- und Ganzkörperausschnitten, was zählt, wenn ein sprechender Kopf allein nicht reicht. Weniger Kompromisse bei der Eingabe bedeuten, dass Sie den Stil Ihres Projekts behalten, statt sich dem Werkzeug anzupassen.
High-Dynamic Video Output
Die erzeugten Clips tragen Bewegung sowohl im Vordergrund als auch im Hintergrund, nicht nur ein auf ein Standbild geklebtes Gesicht. Die Figur bewegt sich, die Szene verschiebt sich, und das Ergebnis hält bis 720p zusammen. Der Preis ist das Gewicht: Die sehr dynamische Erzeugung macht das Modell hungrig nach GPU-Speicher, also verlangen die lebhaftesten Szenen die beste Karte, die Sie haben.
Open Code and Weights
Der Inferenzcode und die Modellgewichte werden offen veröffentlicht, lizenziert für private und kommerzielle Nutzung nach den Bedingungen von Tencent. Sie können alles auf eigener Hardware ausführen, nachsehen, wie es funktioniert, und es mit eigenen Daten feinjustieren. Diese Offenheit ist der Hauptanreiz für Teams, die Gesichter und Stimmen nicht an einen Drittanbieter schicken wollen, und deshalb verbreitete sich das Modell schnell in der Forschungsgemeinschaft.
Vor- und Nachteile
Vorteile
- Ein Foto und ein Audio genügen, also ersetzt ein Standbild eine gefilmte Darbietung.
- Das Audio-Emotionsmodul gibt der Figur eine Stimmung, die dem Klang folgt, statt eines festen Ausdrucks.
- Die Unterstützung mehrerer Figuren hält jeden Sprecher an seinem eigenen Audio, was das Zusammenfügen von Clips von Hand spart.
- Das Modell läuft mit fotorealistischen Gesichtern, Zeichnungen, 3D und Tieren, also bleibt Ihr Kunststil erhalten.
- Offener Code und Gewichte lassen Teams es lokal ausführen und feinjustieren, statt einen geschlossenen Dienst zu mieten.
Nachteile
- Der eigene Betrieb verlangt eine NVIDIA-GPU, und die beste Qualität empfiehlt eine Karte mit 96GB, was fast jeden Consumer-Rechner ausschließt.
- Der gehostete Spielplatz begrenzt das Audio auf etwa 14 Sekunden und ist für Live-Arbeit langsam, also brauchen lange Clips das lokale Setup.
- Renderings sind auf bescheidener Hardware langsam, also sind kurze Fristen bei großen Aufträgen ohne starke Karten nicht realistisch.
- Für die offene Version wird keine öffentliche API beworben, also müssen Entwickler die Serving-Schicht selbst bauen.
Häufige Fragen
HunyuanVideo-Avatar ist ein offenes Modell von Tencent für audiogesteuerte menschliche Animation. Es nimmt ein Porträtbild und ein Audio und erzeugt ein Video, in dem die Figur mit passender Lippenbewegung und passendem Ausdruck spricht oder singt, und es kann mehr als eine Figur in einer Szene verarbeiten. Es stammt von Tencent Hunyuan und dem MuseV-Team des Lyra Lab von Tencent Music und erschien im Mai 2025.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu HunyuanVideo-Avatar.
Alternativen zu HunyuanVideo-Avatar

X Ray Interpreter
X-ray Interpreter · BilderX Ray Interpreter ist ein webbasiertes KI-Radiologie-Tool, das Röntgenbilder, CTs, MRTs, Ultraschallbilder und PET-Aufnahmen in Berichte in einfacher Sprache verwandelt. Sie laden eine Aufnahme hoch, erhalten in wenigen Augenblicken eine vorläufige Röntgenbild-Interpretation und stellen dann Rückfragen, wenn etwas erklärt werden muss. Es dient als zweite Meinung und als Lernhilfe, nicht als medizinische Diagnose.

Aieasypic
AIEasyPic · BilderAIEasyPic ist ein KI-Bildgenerator, der einfache Text-Prompts in Sekunden in fertige Kunstwerke verwandelt. Du kannst außerdem eigene Modelle mit persönlichen Fotos trainieren, Gesichter in vorhandenen Bildern tauschen und kurze Videoclips aus Text erstellen, alles im Browser. Er passt zu Gelegenheitskreativen, die schnelle Bilder wollen, und zu Hobbyisten, die ein persönliches Modell bauen möchten, ohne eine Zeile Code anzufassen.

Chargen
Chargen · BilderChargen ist ein KI-Charaktergenerator und ein Toolkit zum Worldbuilding für Dungeons & Dragons und andere Tisch-Rollenspiele. Es verwandelt eine einzeilige Idee in ein gemaltes Charakterporträt, erzeugt NSCs, Monster, Karten und Begegnungen in derselben Sitzung und hält die Details jeder Kreatur griffbereit. Der Bereich für Tisch-Rollenspiel-Kunst läuft über ein Creditsystem namens Gold, während die Textgeneratoren für alle kostenlos bleiben.