
Inferless
Inferless · Coding
Inferless ist eine serverlose GPU-Plattform, die Machine-Learning-Modelle als API-Endpunkte bereitstellt, mit Kaltstart unter einer Sekunde und Abrechnung pro Sekunde.
Über Inferless
About
Was ist Inferless
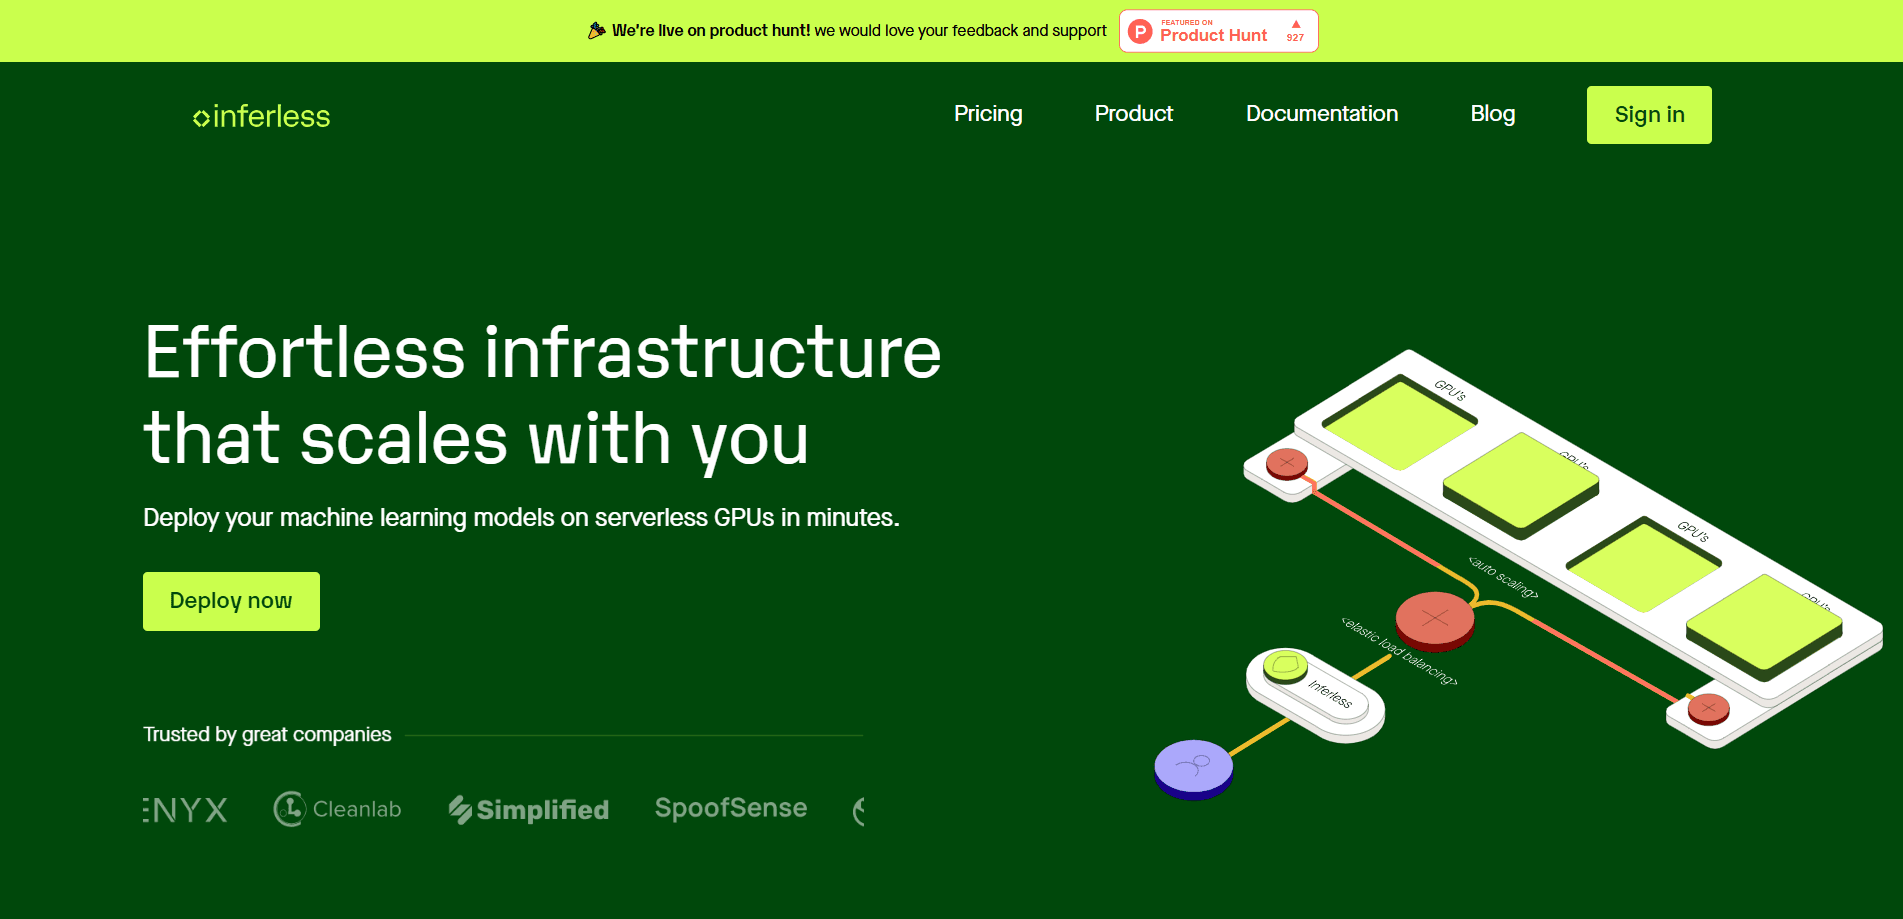
Inferless ist eine modell- und framework-unabhängige GPU-Inferenzplattform und macht aus einem fertig trainierten Machine-Learning-Modell einen laufenden Modell-Endpunkt, ohne dass Sie sich um GPU-Hardware kümmern müssen. Sie bringen das Modell mit, die Plattform übernimmt Bereitstellung, Skalierung und die gesamte Infrastruktur darunter. Sie ist auf ML-Inferenz ausgelegt, nicht aufs Training. Das Versprechen ist einfach: Sie sparen sich die Cluster-Einrichtung und bekommen einen Endpunkt, den Ihre Anwendung aufrufen kann.
Das Problem, das die Plattform angeht, sind Kosten und Aufwand. Ein Modell zu betreiben heißt meist, rund um die Uhr eine GPU zu mieten, auch wenn niemand Anfragen schickt. Inferless rechnet sekundengenau ab und fährt auf null herunter, wenn der Traffic stoppt. So zahlen Sie nur für die tatsächlich genutzte Rechenleistung. Dahinter stehen eine eigene Orchestrierungs-Engine und eine Speicherschicht, die den Kaltstart niedrig halten. Das zählt, wenn ein Modell erst aufwachen muss, bevor es antwortet.
Die Grenzen sind praktischer Natur. Das ist ein Entwicklerwerkzeug, keine No-Code-App, also müssen Sie Modell und Abhängigkeiten sauber paketieren. Der Preis richtet sich nach Nutzung, günstig bei wenig Last, aber schwerer vorherzusagen als eine feste Gebühr. Und manche Abläufe, etwa lange Trainingsläufe, passen besser auf eine dedizierte GPU-Maschine als auf einen serverlosen Endpunkt für Inferenz.
Erste Schritte
- Legen Sie ein Inferless-Konto an und verbinden Sie eine Modellquelle wie Hugging Face, GitHub oder ein Docker-Image
- Konfigurieren Sie Laufzeit, Pakete und GPU-Typ über eine einfache YAML-Datei, ohne Servercode zu schreiben
- Stellen Sie das Modell bereit und lassen Sie Inferless die Umgebung bauen und den Endpunkt starten
- Rufen Sie den erzeugten Endpunkt aus Ihrer Anwendung auf und überlassen Sie Autoscaling den Traffic-Spitzen. Das erspart Ihnen das manuelle Bereitstellen eigener Machine-Learning-Modelle auf eigener Hardware.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Inferless.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Machine-Learning-Ingenieure
- Startups
- Datenwissenschaftler
- Anwendungsentwickler
- Unternehmensteams
Aufgaben
- Ein eigenes Modell bereitstellen
- Sprachmodelle ausliefern
- Batch-Inferenzjobs
- Eine Idee erproben
- Inferenz in eine App einbauen
- Daten zwischen Modellen teilen
Szenarien
- Ein Startup startet ein KI-Feature
- Ein Datenwissenschaftler prüft ein Modell
- Ein Team mit schwankendem Traffic
- Ein Entwickler baut eine Demo
- Ein Unternehmen mit eigenen Modellen
Wichtigste Funktionen
Kaltstart unter einer Sekunde
Das Schwierigste an serverloser Inferenz ist die Wartezeit, wenn ein schlafendes Modell zum Antworten aufwacht, der sogenannte Cold Start. Inferless geht das mit einer eigenen Orchestrierungs-Engine, einem ausgefeilten Router und einer eigenen Speicherschicht an, die zusammenspielen. Laut Unternehmen liegt das Ergebnis selbst bei großen Modellen unter einer Sekunde, was das Herunterfahren auf null für nutzernahe Apps praktikabel hält. Muss ein Chat- oder Suchfeature zehn Sekunden auf ein Modell warten, lohnt sich Serverless nicht mehr.
Automatische Skalierung von null
Inferless skaliert Ihren Endpunkt mit dem Traffic, von keiner laufenden GPU bis zu Hunderten gleichzeitig. Der eigene Load Balancer verteilt Anfragen und fährt Kapazität mit wenig Zusatzaufwand hoch oder herunter. Das passt zu Lasten, die unvorhersehbar ausschlagen. Sie planen keine Spitzenlast im Voraus und zahlen sie auch nicht, wenn es ruhig bleibt.
Modellimport aus mehreren Quellen
Sie können Modelle aus Hugging Face, GitHub, AWS S3, Google Cloud Storage, Docker oder der Inferless-CLI holen, den Rest erledigt die Plattform. Der Import per Klick aus den Repositories, die ML-Teams ohnehin nutzen, senkt den Aufwand. Ein Modell in Produktion zu bringen, beginnt so nicht mit einem Dateitransfer. Azure-Unterstützung ist als kommend angekündigt.
Modell- und Framework-unabhängig
Die Plattform führt Modelle aus PyTorch, TensorFlow und ONNX aus und nimmt auch eigene Python-Funktionen an. Diese Flexibilität heißt, Sie sind nicht auf ein Framework oder ein Modellformat festgelegt. Laufzeiten und Pakete konfigurieren Sie über YAML, zusätzliche Bibliotheken einzubinden erfordert also keinen selbst geschriebenen Server.
Unterstützung für geteilte GPUs
Statt für ein kleines Modell eine ganze GPU zu mieten, lässt Inferless mehrere Modelle und Workloads dieselbe GPU teilen, mit automatischem Ausgleich und Node-Draining. Sie können auch mit geteilten GPUs arbeiten, ein Modell, das nur einen Teil einer A100 braucht, zwingt Sie also nicht, die ganze Karte zu zahlen. Für Teams mit vielen kleinen Modellen entscheidet dieses Teilen oft zwischen machbar und zu teuer.
Monitoring und CI/CD
Inferless bringt Prometheus-Metriken und Grafana-Dashboards mit, um GPU-Nutzung und andere Gesundheitswerte zu verfolgen. Neue Modellversionen gehen über CI/CD-Pipelines live, Sie veröffentlichen ein Update also ohne manuellen Neuaufbau der Infrastruktur. Aus demselben Ablauf kommen einsatzbereite API-Endpunkte, die Sie in ein Backend oder Frontend einbauen können.
Vor- und Nachteile
Vorteile
- Abrechnung pro Sekunde vermeidet Leerlaufkosten, wenn der Traffic auf null fällt
- Kaltstart unter einer Sekunde hält das Herunterfahren auf null für Live-Apps praktikabel
- Import per Klick aus Hugging Face, GitHub, S3 und Google Cloud Storage spart Einrichtungszeit
- Framework-unabhängig, also laufen PyTorch, TensorFlow, ONNX und eigenes Python
- Geteilte GPUs senken die Kosten für viele kleine Modelle
Nachteile
- Es ist ein Entwicklerwerkzeug, Modell und Abhängigkeiten müssen Sie weiterhin selbst paketieren
- Der Nutzungspreis ist bei wenig Last günstig, aber schwerer zu kalkulieren als eine feste Gebühr
- Lange Trainingsläufe sind nicht das Ziel, die Plattform ist auf Inferenz ausgelegt
- Keine native Mobil-App, alles läuft über die Web-Konsole und die CLI
Häufige Fragen
Inferless ist eine serverlose GPU-Plattform für die Modell-Bereitstellung und macht aus eigenen Machine-Learning-Modellen API-Endpunkte. Sie importieren ein Modell, konfigurieren die Laufzeit, und Inferless übernimmt Hardware, Skalierung und Kaltstart-Abstimmung.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Inferless.
Alternativen zu Inferless
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.