
IonRouter
Cumulus Labs · Coding
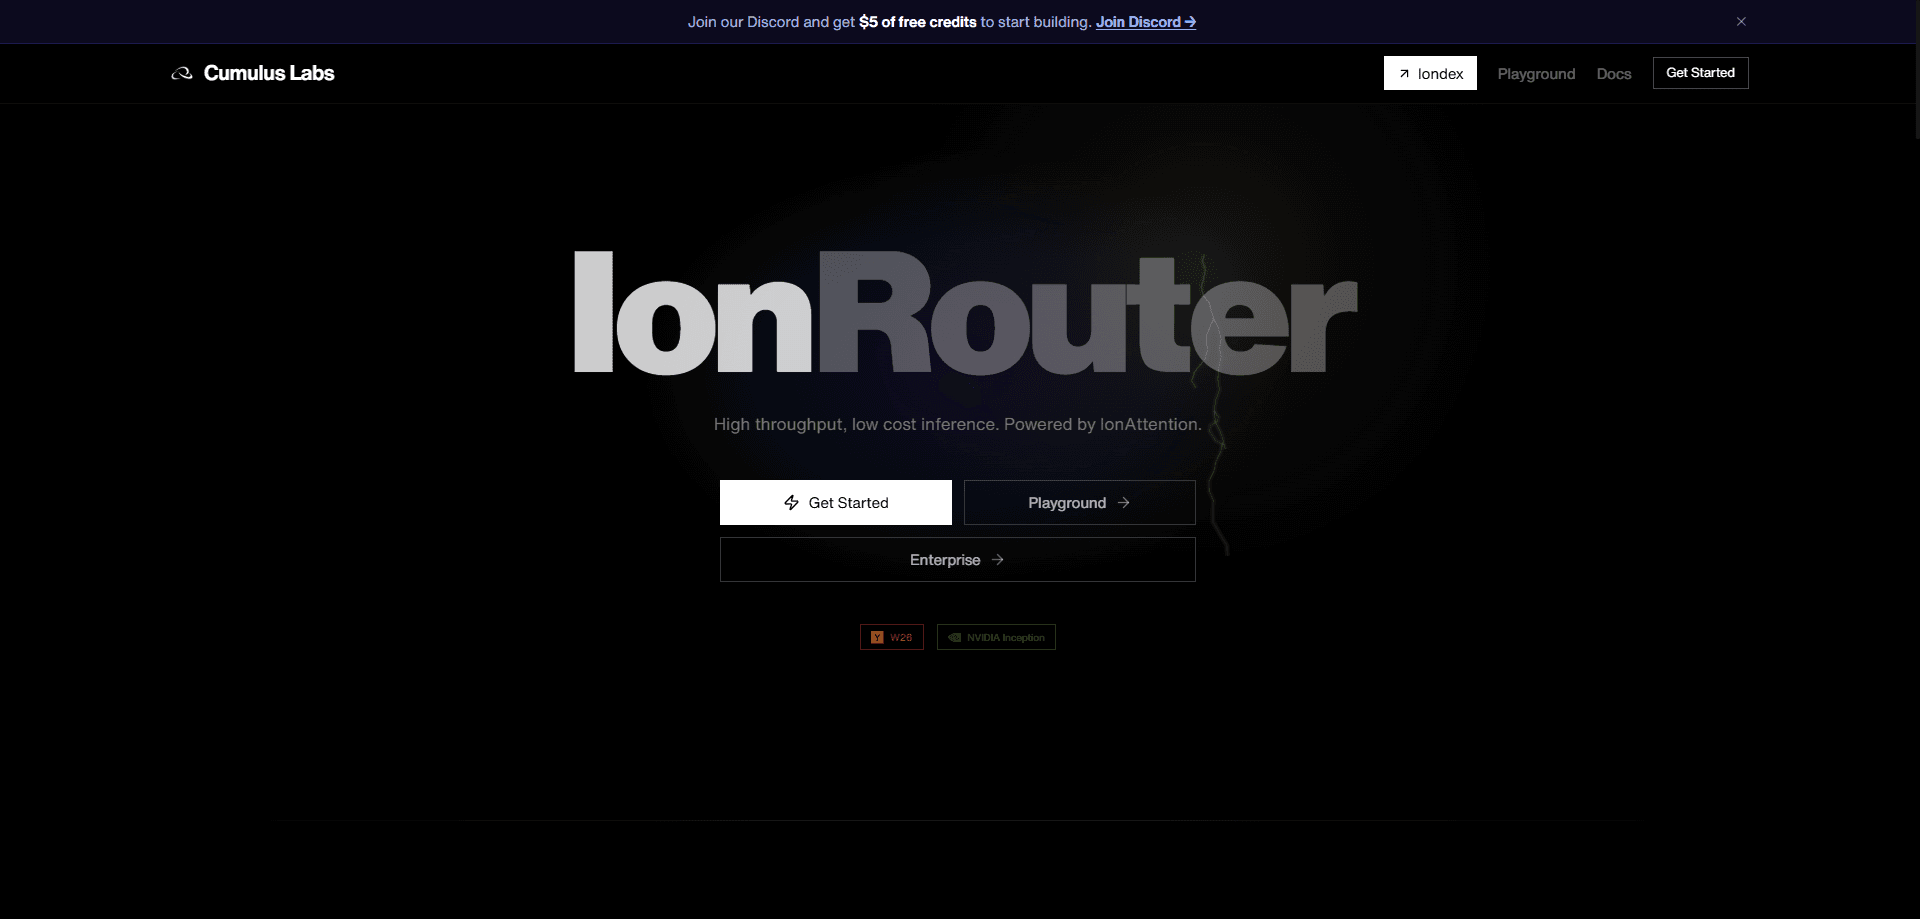
IonRouter ist eine Inferenz-API von Cumulus Labs, die Open-Source- und Open-Weight-KI-Modelle über OpenAI-kompatible Endpunkte bereitstellt. Sie richten Ihren bestehenden Client auf die Basis-URL aus, tauschen den Schlüssel aus, und Ihr Code läuft weiter. Der Reiz sind Geschwindigkeit und Preis: Der hauseigene IonAttention-Stack des Teams multiplexiert mehrere Modelle auf einer einzigen GPU und nennt Durchsatzwerte deutlich über denen typischer Hosting-Anbieter, mit Abrechnung pro Token und ohne Leerlaufkosten.
Über IonRouter
Was ist IonRouter
IonRouter ist ein gehosteter Inferenzdienst für Entwickler, die KI-Modelle aufrufen müssen, ohne eigene GPUs zu betreiben. Er spricht das Format der OpenAI-API, sodass die Migration von einem anderen Anbieter meist eine Zeile Code kostet. Unter der Haube betreibt Cumulus Labs eine eigene Engine namens IonAttention auf NVIDIA-Grace-Hopper-Hardware. Diese Engine ist das Kernargument, und sie ist für Sie wichtig, weil Durchsatz und Startzeit Ihre Rechnung und die Wartezeit Ihrer Nutzer bestimmen.
Der Dienst deckt Sprach-, Vision-, Bild-, Video- und Audiomodelle ab. Sie können Flaggschiff-Optionen wie GLM-5 oder Qwen3.5-122B-A10B aufrufen. Sie können auch eigene Finetunes und LoRAs auf dedizierte Streams bringen, wo sie mit eigener GPU-Zuteilung ohne gemeinsame Warteschlange laufen. Die Abrechnung erfolgt pro Million Token, und Sie zahlen nur, was Sie nutzen. Es gibt keine kostenlose Stufe zum Ausweichen, und das ist der wichtigste Punkt, den Sie vor einer Bindung einplanen sollten.
Die ehrliche Grenze: Das ist ein Entwicklerwerkzeug. Es gibt keinen Drag-and-drop-Baukasten und kein ausgefeiltes Endnutzer-Chatprodukt jenseits eines Playgrounds. Was bleibt Ihnen also? Eine saubere API und ein Playground, mehr nicht. Wenn Sie keinen Code schreiben, ist IonRouter nichts für Sie. Es ist zudem eine junge Plattform. Brauchen Sie ein Jahrzehnt Verfügbarkeitshistorie, bevor Sie einem Anbieter vertrauen, finden Sie das hier noch nicht.
Erste Schritte
- Erstellen Sie ein Konto auf ionrouter.io und melden Sie sich an.
- Laden Sie Guthaben auf der Seite Billing auf. Das Guthaben wird bei Aufrufen abgezogen.
- Erzeugen Sie einen API-Schlüssel auf der Seite Keys und kopieren Sie ihn, denn er wird nur einmal angezeigt.
- Richten Sie Ihren OpenAI-Client auf die Basis-URL aus und übergeben Sie Ihren Schlüssel als Bearer-Token.
- Senden Sie eine Chat-Completion-Anfrage und beginnen Sie zu bauen.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von IonRouter.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Backend- und ML-Entwickler
- Startups mit Blick auf Inferenzkosten
- Robotik- und Videoteams
Aufgaben
- Einen teureren Inferenzanbieter ersetzen
- Open-Source-LLMs auf eigenen Finetunes betreiben
- Lange Dokumente verarbeiten
Szenarien
- Eine KI-Funktion mit knappem Budget prototypen
- Einen Produktions-Chatbot über eine Spitze hinaus skalieren
- Echtzeit-Video- oder Überwachungspipelines bauen
Wichtigste Funktionen
OpenAI-kompatible Endpunkte
Jede Sprache und jedes Framework, das bereits mit der OpenAI-API spricht, kann mit IonRouter sprechen. Sie richten Ihren bestehenden Client auf eine neue Basis-URL aus, setzen einen frischen Schlüssel ein und sehen dieselben Aufrufe weiterlaufen, ohne etwas neu zu schreiben. Kein neues SDK zu lernen, kein Neuaufbau Ihrer Anfrageverarbeitung. Für Teams, die bereits auf einem gehosteten Modell sind, ist das die gesamte Migration.
IonAttention-Engine
IonAttention ist der eigene Inferenz-Stack von Cumulus Labs. Er multiplexiert Modelle auf einer einzigen GPU, tauscht sie in Millisekunden aus und passt sich dem Verkehr an, wenn er sich ändert. Laut Unternehmen erreicht ein einzelner GH200 mit Qwen2.5-7B rund 7.167 Token pro Sekunde, gegenüber etwa 3.000 bei einem führenden Inferenzanbieter, was das Team als Beleg dafür darstellt, dass seine Engine mehr Arbeit aus demselben Silizium holt als das übliche Hosting-Setup. Nehmen Sie das als Anbieterangabe. Das Designziel ist real: weniger Leerlaufhardware, niedrigere Kosten pro Token.
Abrechnung pro Sekunde ohne Leerlaufkosten
Sie zahlen pro Million Token statt pro reservierter Stunde. Es gibt keine Gebühr dafür, eine GPU warm zu halten, während nichts läuft, und genau dieser Unterschied verändert, wie Sie eine Funktion budgetieren, deren Verkehr Sie nicht vorhersagen können. Für Workloads, die aufbrausen und dann verstummen, schlägt diese Preisform meist eine feste Reservierung. Ihre Kosten skalieren mit dem, was Sie tatsächlich ausliefern. Mehr nicht.
Eigene Modelle und LoRA-Streams
Sie können eigene Finetunes, eigene LoRAs oder jedes Open-Source-Modell im Park bereitstellen, und jedes erhält seinen eigenen dedizierten GPU-Stream mit sekundengenauer Abrechnung statt einer gemeinsamen Warteschlange, die Ihre Latenz unvorhersehbar macht. Das zählt, wenn Ihr Produkt von einem auf Ihre Daten abgestimmten Modell abhängt und Sie Ihren eigenen Cluster nicht betreuen wollen.
Breiter Modellkatalog
Der Katalog umfasst Sprach-, Vision-, Bild-, Video- und Audiomodelle, sodass Sie das günstigste Modell wählen können, das die Hürde einer Aufgabe nimmt, und die teuren Schwergewichte für Arbeiten reservieren, die sie wirklich brauchen. Zu den Flaggschiff-Optionen gehören GLM-5 für Reasoning und Code, Kimi-K2.5 für lange Dokumente und MiniMax-M2.5 mit einem Kontext von einer Million Token. Günstigere kleine Modelle wie Qwen3-8B und GPT-OSS-120B erledigen leichtere Aufgaben. Die Preise reichen je nach Modell von ein paar Cent bis ein paar Dollar pro Million Token.
Dedizierte GPU-Infrastruktur auf Grace Hopper
IonRouter läuft auf NVIDIA-Grace-Hopper-GPUs, und das Unternehmen ist Teil des NVIDIA-Inception-Programms. Dedizierte Streams sorgen dafür, dass Ihr Verkehr nicht mit Fremden eine Warteschlange teilt, was Ihre Latenz in die Höhe treiben würde. Kaltstarts unter einer Sekunde verhindern, dass die erste Anfrage einer Sitzung Nutzer warten lässt.
Vor- und Nachteile
Vorteile
- OpenAI-kompatible Endpunkte verkürzen die Migration auf einen URL- und Schlüsselwechsel, es bleibt also wenig Code neu zu schreiben.
- Abrechnung pro Token ohne Leerlaufkosten passt besser zu schwankendem oder unvorhersehbarem Verkehr als reservierte GPUs.
- Eigene Finetunes und LoRAs bekommen dedizierte Streams. Das hilft, wenn Ihr Produkt von einem abgestimmten Modell abhängt.
- Eine breite Modellauswahl, von günstigen kleinen Modellen bis zu Flaggschiff-Reasoning-Modellen, lässt Sie pro Aufgabe Kosten gegen Fähigkeit tauschen.
- Der vom Anbieter gemeldete Durchsatz ist hoch, und Kaltstarts unter einer Sekunde helfen interaktiven und Echtzeit-Workloads.
Nachteile
- Keine kostenlose Stufe, Sie müssen also Guthaben aufladen, bevor Sie irgendetwas testen, was die Bewertung verteuert.
- Neuer und weniger erprobt als die großen Hosting-Anbieter, es gibt also keine lange Verfügbarkeitshistorie zum Nachsehen.
- Es ist für Entwickler gebaut. Es gibt keinen No-Code-Weg und keine fertige Endnutzer-App, wenn Sie keinen Code schreiben.
Häufige Fragen
Es ist eine gehostete Inferenz-API, um KI-Modelle aus Ihrer eigenen Software aufzurufen. Sie senden Anfragen und bekommen Modellausgaben zurück, so wie Sie die OpenAI-API nutzen würden, nur ausgerichtet auf Open-Source- und Open-Weight-Modelle, die auf den GPUs von Cumulus Labs laufen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu IonRouter.
Alternativen zu IonRouter
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.