
KugelAudio
KugelAudio · Stimme & Sprache
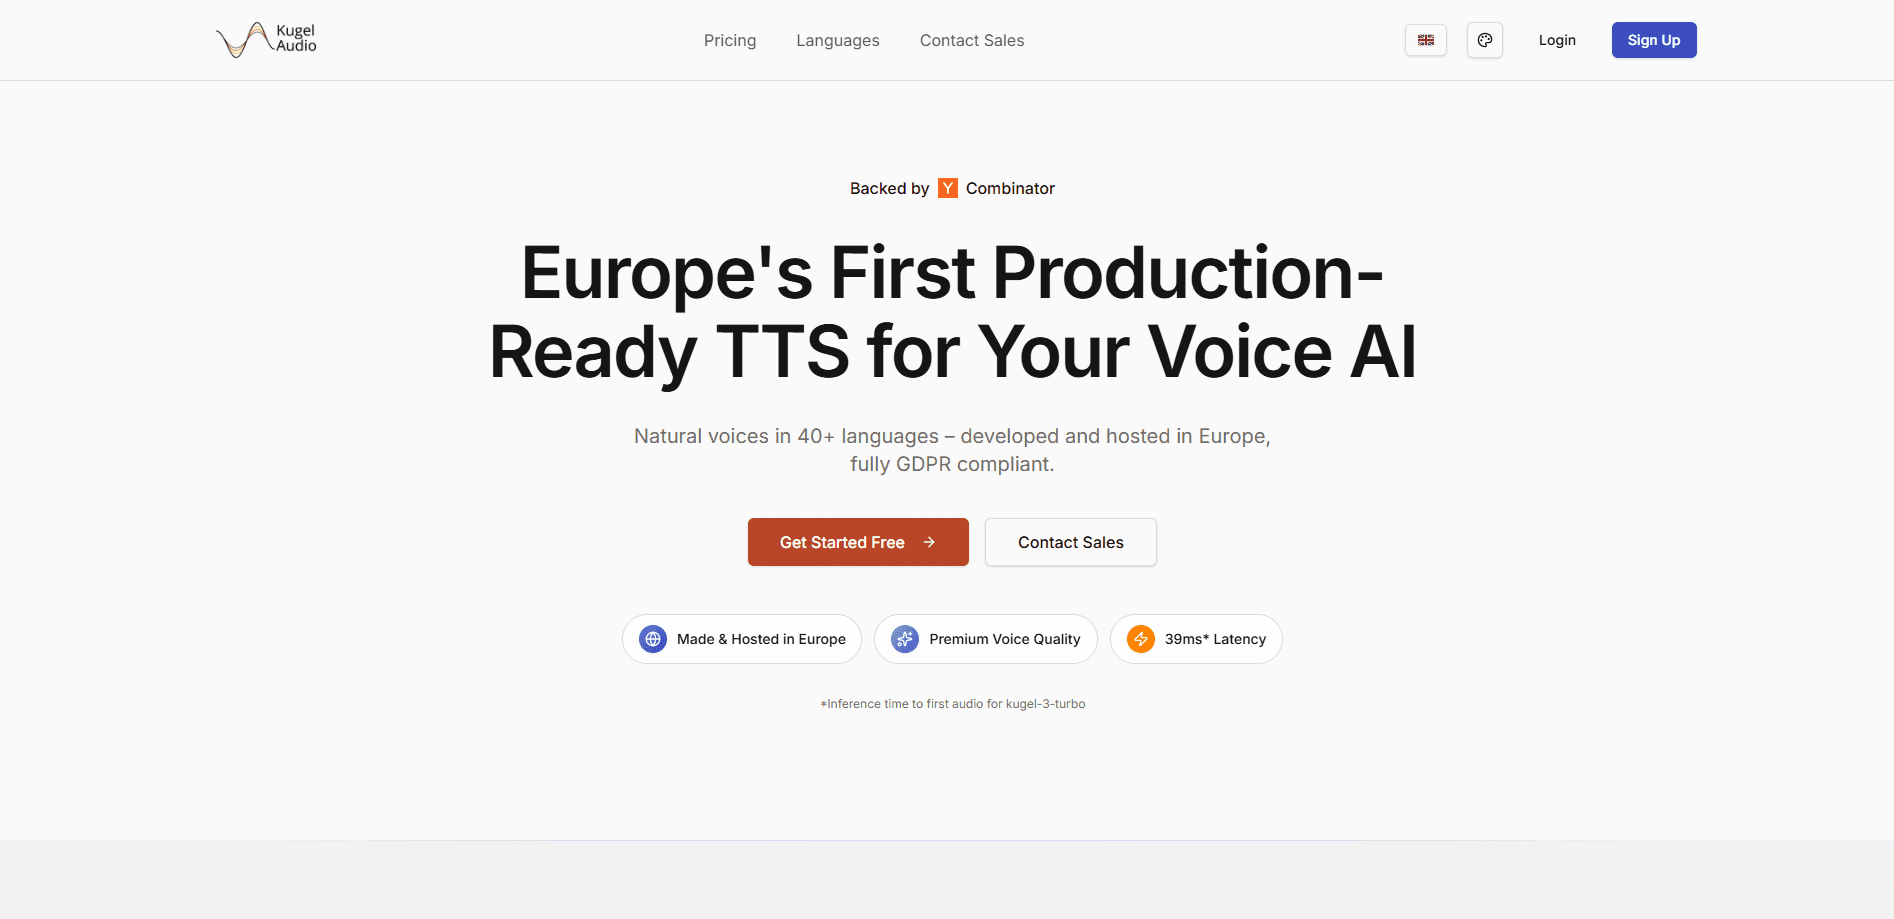
KugelAudio ist eine Text-to-Speech-API für Echtzeit-Voice-KI, und sie kommt aus Europa. Die Plattform betreibt ein mehrsprachiges TTS-Modell namens Kugel 3, das 39 Sprachen spricht, eine Stimme aus einer kurzen Audioaufnahme klont und Audio in 60 bis 80 Millisekunden an deine App streamt. Wenn du Sprache in einen Voice-Agenten, ein Callcenter-Tool oder eine Narration-Pipeline einbaust, zielt KugelAudio genau auf die Latenz- und Datenresidenzprobleme, die solche Projekte meist ausbremsen.
Über KugelAudio
Was ist KugelAudio
KugelAudio ist eine Text-to-Speech-Plattform für Entwickler, die schnelle Sprachausgabe brauchen und ihr Audio in der EU verarbeiten lassen wollen. Sie stellt ein Hauptproduktionsmodell bereit, Kugel 3, über eine gehostete API mit einem direkten europäischen Endpunkt. Du schickst Text, wählst eine Stimme und bekommst Audio zurück, das du streamen oder speichern kannst. So einfach ist das.
Der Kern des Angebots ist Kontrolle. Europäische Teams sitzen oft zwischen günstigem, in den USA gehostetem TTS und teurer selbst betriebener Infrastruktur fest. KugelAudio liegt dazwischen: garantiertes EU-Hosting, eine Option für die EU Sovereign Cloud und eine On-Premise-Stufe für Firmen, die Audiodaten nicht von ihren eigenen Servern lassen dürfen. Der Support deckt 39 Sprachen ab, also deckt ein einziges Modell ein mehrsprachiges Produkt ab, statt dich zu zwingen, mehrere Anbieter zusammenzuflicken.
Es gibt Grenzen, die man vorab kennen sollte. Es ist ein API-Produkt, keine Consumer-App, du brauchst also etwas Code, um es zu nutzen. Die Abrechnung erfolgt pro generierter Audiominute. Das belohnt planbare Nutzung, kann Teams mit stark schwankendem Traffic aber überraschen. Und du kannst es nicht einfach herunterladen und auf einem Laptop laufen lassen, es sei denn, du bist im Enterprise-On-Premise-Tarif.
Erste Schritte
- Registriere dich auf kugelaudio.com und hol dir deinen API-Schlüssel aus dem Dashboard.
- Installiere das SDK für deinen Stack, entweder
pip install kugelaudiofür Python odernpm install kugelaudiofür JavaScript. - Schicke eine Anfrage mit deinem Text, einer
model_idvonkugel-3und einer Voice-ID. Fügebreak-Tags hinzu, wenn du Pausen in der Aussprache willst. - Wähle Streaming oder eine komplette Datei. Das WebSocket-Streaming schiebt Audiohäppchen, sobald sie erzeugt werden, was du für ein Live-Gespräch willst.
- Klone eine eigene Stimme, falls nötig, mit 10 bis 30 Sekunden sauberem Referenzaudio.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von KugelAudio.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Backend- und Voice-App-Entwickler
- Europäische Produktteams
- Unternehmen mit strengen Datenrichtlinien
Aufgaben
- Voice-Agenten bauen
- Markenstimmen klonen
- Inhalte in großem Umfang vertonen
- Sprache lokalisieren
Szenarien
- Support-Hotlines, die schnelle, natürlich klingende Antworten in mehreren Sprachen brauchen.
- Interaktive Apps, in denen eine langsame Antwort das Erlebnis kaputt macht, etwa Sprachtutoren oder Barrierefreiheits-Tools.
- Regulierte Branchen wie Gesundheitswesen und Finanzen, in denen Audio in der Region bleiben muss.
- Teams, die einen selbst betriebenen TTS-Stack ersetzen, um den Engineering-Aufwand für eigene Inferenz zu senken.
Wichtigste Funktionen
Echtzeit-Streaming über WebSocket
KugelAudio streamt Audiohäppchen, sobald das Modell sie erzeugt, statt auf eine ganze Datei zu warten. Das zählt am meisten, wenn dein Text Token für Token aus einem Sprachmodell kommt, denn die Stimme kann zu sprechen beginnen, bevor der Satz fertig ist. Für einen Voice-Agenten ist das der Unterschied zwischen einem natürlichen Hin und Her und einer peinlichen Pause.
Die niedrige Latenz von Kugel 3
Das Flaggschiffmodell erreicht rund 60 bis 80 ms bis zum ersten Audio, und das leichtere Modell kugel-2-turbo kommt auf etwa 40 bis 50 ms. Laut KugelAudio werden diese Werte serverseitig gemessen. Das ist schnell. Wenn du etwas für Gespräche baust, ist der Abstand klein genug, um im normalen Betrieb zu verschwinden.
Stimmklonen aus kurzen Aufnahmen
Du kannst eine eigene Stimme aus nur 10 bis 30 Sekunden sauberem Referenzaudio erstellen, ohne eine Runde Feintuning. Marken nutzen das, um einen Sprecher über Hunderte Clips hinweg konsistent zu halten, und Support-Teams geben einem Bot damit eine wiedererkennbare Identität, der Kunden mit der Zeit vertrauen. Die Aufnahme muss sauber sein. Verrauschtes Quellaudio verdirbt das Ergebnis.
Mehrsprachiges Modell mit 39 Sprachen
Kugel 3 deckt 39 Sprachen ab, von Englisch und Deutsch bis Japanisch, Koreanisch, Arabisch und Chinesisch, alles über ein einziges Modell. Du wählst nicht pro Sprache eine andere Engine, was eine Codebasis vereinfacht, die Nutzer in mehreren Ländern bedient. Das ist das TTS mit niedriger Latenz, das mehrsprachige Produkte sonst aus mehreren Anbietern zusammenbauen müssen. Du kannst auch IPA-Notation verwenden, um genau zu steuern, wie ein Wort ausgesprochen wird.
EU-Hosting und Sovereign Cloud
Jeder Tarif enthält garantiertes EU-Hosting, und die EU Sovereign Cloud ist für Kunden aus der EU und dem EWR inbegriffen. Brauchst du gehärtetes, in der EU gehostetes TTS? Dies ist eine der wenigen Optionen mit niedriger Latenz, die den europäischen Aspekt zur Schlagzeile macht. Für Teams, die Datenresidenz als harte Anforderung und nicht als Nice-to-have behandeln, beseitigt es einen häufigen Blocker, bevor ein Projekt überhaupt startet.
Fein abgestufte Steuerung der Aussprache
Die API unterstützt Pausen-Tokens, Geschwindigkeitssteuerung, Zeitstempel auf Wortebene und eigene Wörterbücher. Zeitstempel sind praktisch für Untertitel und Lippensynchronisation, während Wörterbücher dich korrigieren lassen, wie das Modell Produktnamen und Fachjargon ausspricht. Genau diese Details entscheiden, ob generierte Sprache poliert oder robotisch klingt.
Python- und JavaScript-SDKs
KugelAudio liefert SDKs für die zwei gängigsten Stacks, dazu einen einfachen cURL-Weg für alles andere. Du installierst ein Paket und rufst eine Generate-Methode mit deinem Text und deiner Voice-ID auf. Der Weg von der Anmeldung zum ersten Clip ist kurz, was hilft, wenn du etwas Kleines prototypst.
On-Premise- und Enterprise-Deployment
Größere Organisationen können auf On-Premise- oder dediziertes Deployment mit höheren Parallelitätslimits, 24/7-Support und einem eigenen Account-Manager wechseln. Gebuchte Nutzung bringt niedrigere Sätze. Diese Stufe gibt es für Firmen, die die ganze Pipeline besitzen müssen, vom Modell bis zum Server, auf dem es läuft, und jedes Byte Kunden-Audio im eigenen Netz halten wollen.
Vor- und Nachteile
Vorteile
- EU-Hosting ist Standard, was Datenresidenzregeln ohne Mehraufwand erfüllt.
- Kugel 3 erreicht 60 bis 80 ms bis zum ersten Audio, schnell genug für Live-Gespräche.
- Ein Modell deckt 39 Sprachen ab, also vermeiden mehrsprachige Produkte einen Flickenteppich aus Anbietern.
- Stimmklonen braucht nur 10 bis 30 Sekunden Referenzaudio.
- Streaming, Klonen, Zeitstempel und Wörterbücher sind in jeder Preisstufe enthalten.
Nachteile
- Es gibt keinen kostenlosen Tarif, ein Test bedeutet also, von Anfang an pro generierter Minute zu zahlen.
- Es ist ein reines API-Produkt, was nicht-technische Nutzer ausschließt, die eine App zum Generieren per Klick wollen.
- On-Premise-Deployment steckt hinter Enterprise-Preisen, kleinere Teams können den selbst gehosteten Weg also nicht leicht testen.
- Die Kosten skalieren mit den Audiominuten. Voice-Agenten mit hohem Volumen oder Dauerbetrieb sammeln schnell welche an.
Häufige Fragen
KugelAudio wandelt Text in Sprache für Echtzeitanwendungen um, meist Voice-Agenten, interaktive Apps und Narration in großem Umfang. Entwickler rufen seine API auf, um Audio als Stream oder Datei zu erhalten. Es ist für Produkte gebaut, bei denen Geschwindigkeit und Sprachabdeckung mehr zählen als eine freundliche Consumer-Oberfläche.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu KugelAudio.
Alternativen zu KugelAudio

Prosp
Prosp · Schreiben · Stimme & Sprache · MarketingProsp ist ein KI-Tool für LinkedIn-Ansprache, gebaut für Agenturen und Vertriebsteams, und es schreibt die Nachricht und die Sprachnachricht mit Ihrer eigenen Stimme für jeden Interessenten, damit sie wirklich antworten. Sie verbinden Ihre Konten, finden Leads und lassen die KI personalisierte Nachrichten in großem Umfang entwerfen und versenden, alles aus einem Posteingang. Es ist für Menschen gemacht, die Outbound in großem Stil betreiben. Das ist das ganze Versprechen. Jeder Kontaktpunkt muss trotzdem menschlich wirken.

Wordly AI Translation
Wordly · Stimme & Sprache · ProduktivitätWordly AI Translation ist eine KI-Echtzeitübersetzungs- und Untertitelungsplattform für Besprechungen, Konferenzen und Veranstaltungen. Sie liefert Live-Übersetzung, Untertitel, Transkripte und Zusammenfassungen in mehr als 60 Sprachen, und Teilnehmer treten per QR-Code-Scan oder über einen Link bei, statt eigene Kopfhörer zu nutzen. Die Plattform arbeitet mit Zoom, Microsoft Teams, Google Meet und Webex zusammen und richtet sich an Organisationen, die mehrsprachigen Zugang wollen, ohne für jede Sitzung menschliche Dolmetscher zu engagieren. So einfach ist das.
Musicful
Musicful AI · Stimme & Sprache · VideoMusicful ist ein KI-Musikgenerator und KI-Musikvideo-Ersteller, der Text in Minuten in Musik verwandelt. Du gibst einen Text, einen Songtext oder eine gesummte Melodie ein und erhältst einen fertigen Track mit Gesang und Instrumenten. Er dient außerdem als KI-Songgenerator, erstellt Musikvideos aus den Songs, die du machst, und bietet ein KI-Cover-Werkzeug plus eine Entwickler-API. Die Plattform läuft im Webbrowser und über eine Android-App, sodass du einen Song am Desktop beginnen und am Handy fortsetzen kannst.