
Kyutai TTS
Kyutai · Stimme & Sprache
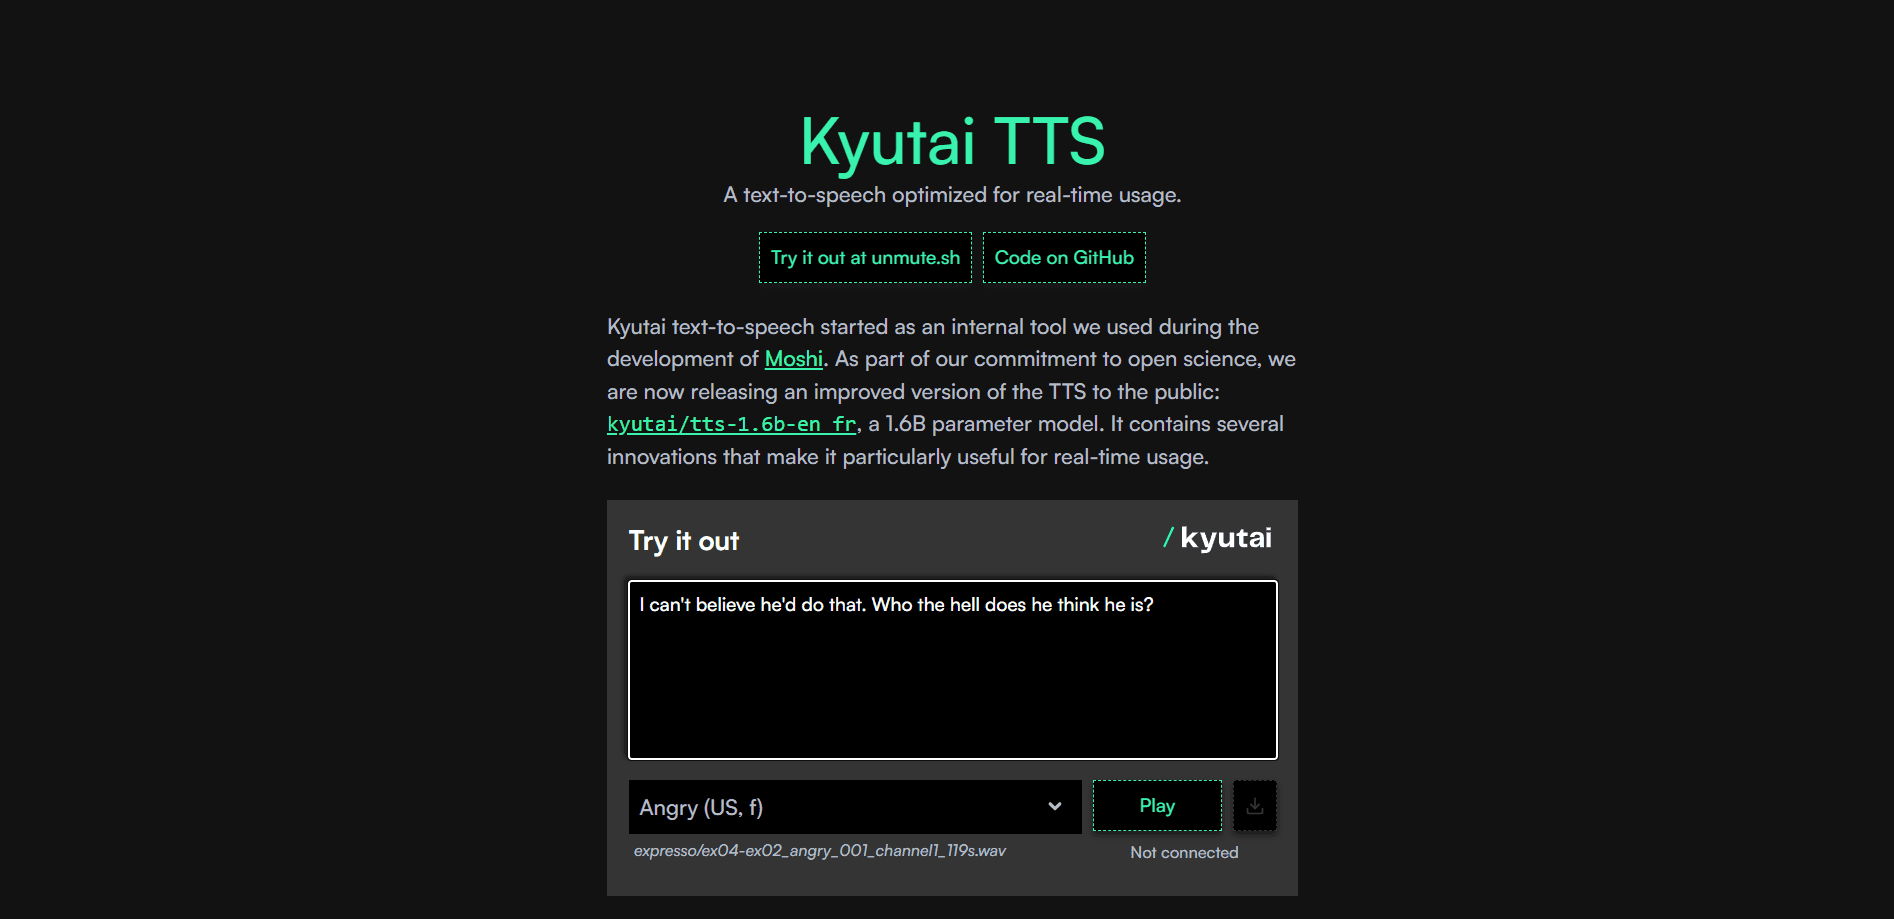
Kyutai TTS ist ein quelloffenes TTS-Modell für Text zu Sprache im Streaming, das Audio erzeugt, bevor der ganze Text vorliegt. So bleibt die Latenz für Sprachassistenten und Echtzeit-Apps niedrig.
Über Kyutai TTS
About
Was ist Kyutai TTS
Kyutai TTS ist ein Modell für Text zu Sprache, das auf Streaming ausgelegt ist. Es liest Text laut vor, wartet aber nicht, bis Sie fertig getippt haben. Es spricht, sobald es die ersten Wörter hat, und genau das trennt es von Offline-Engines, die den ganzen Satz brauchen, bevor ein Ton kommt.
Kyutai ist ein französisches Labor für offene Wissenschaft, finanziert von der Iliad-Gruppe, der CMA CM-Gruppe und Schmidt Sciences. Das Labor baute Kyutai TTS 1.6B, eines von mehreren Kyutai Audiomodellen, für die eigene Arbeit an Moshi, einem Sprachdialogsystem, und veröffentlichte die Gewichte danach öffentlich. Diese Version zielt auf Sprachsynthese mit niedriger Latenz, eine Aufgabe, die die meisten Engines erst nach dem ganzen Text erledigen. Wer Sprachtools sucht, kann einen sprechenden Assistenten bauen, Erzählungen erzeugen oder einer App Sprache geben, ohne pro Zeichen zu zahlen.
Der Haken liegt darin, wie das Modell seine Geschwindigkeit erreicht. Es wurde mit 2,5 Millionen Stunden öffentlichem Audio trainiert und läuft am besten auf einer GPU, also ist es kein fertiger Cloud-Dienst mit klarem Monatspreis. Sie laden die Gewichte herunter, richten eine Umgebung ein und starten es selbst. Es gibt zwei Versionen: das Streaming-Modell mit 1.6B, um das es hier geht, und das neuere Pocket TTS, ein kleineres Modell für CPU-Rechner.
Erste Schritte
- Legen Sie ein kostenloses Konto bei Hugging Face an und akzeptieren Sie die Modelllizenz auf der Kyutai TTS-Seite.
- Installieren Sie das Python-Paket moshi per pip, oder das Crate moshi-server, wenn Sie es in der Produktion bereitstellen wollen.
- Laden Sie den Checkpoint und den Mimi-Audiocodec in Python, dann richten Sie das Modell auf einen Texteingabe.
- Erzeugen Sie Audio in Blöcken für die Streaming-Wiedergabe, oder lassen Sie es auf einer Datei für die Offline-Ausgabe laufen.
- Wählen Sie eine fertige Stimme aus dem Repository tts-voices, oder bringen Sie Ihren eigenen Stimm-Embedding mit.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Kyutai TTS.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler, die Sprachassistenten bauen
- Forschende und Studierende
- Bastler mit kleinem Budget
Aufgaben
- Gesprochene Antworten in Echtzeit
- Stimmklonen für eine feste Figur
- Erzählungen in Stapeln erzeugen
Szenarien
- Einen Sprech-Assistenten betreiben
- Barrieren in einer App senken
- Ein mehrsprachiges Produkt testen
Wichtigste Funktionen
Streaming-Ausgabe, die Offline-TTS schlägt
Kyutai TTS spricht, sobald es die ersten Wörter eines Textes hat. Offline-Engines warten auf den ganzen Text und verlieren damit Sekunden. Bei einem Sprachassistenten entscheidet dieser Abstand zwischen flüssigem Hin und Her und peinlicher Pause.
Auf delayed streams modeling gebaut
Das Modell stammt aus Kyutais Forschung zum delayed streams modeling, einer Methode für Streaming-Aufgaben zwischen Text und Sprache. Es nutzt dieselbe Multistream-Architektur wie Moshi, so passen Text- und Audiostrom zusammen und die Erzeugung bleibt stabil und schnell.
Stimmklonen über Embeddings
Sie geben dem Modell eine bestimmte Stimme, indem Sie ein berechnetes Embedding aus dem Repository tts-voices einspeisen. Kyutai wählte diesen Weg statt freiem Klonen aus einem Grund. Wasserzeichen lassen sich bei offenen Modellen leicht entfernen, deshalb ist Klonen über gespeicherte Embeddings der sicherere Weg.
Stapelverarbeitung für hohen Durchsatz
Das Modell bündelt Anfragen, statt eine Stimme nach der anderen zu bedienen. Kyutai nennt etwa 75x erzeugtes Audio pro Recheneinheit, und das Training nutzte CFG-Destillation, damit Sie den Stapel beim Steuern nicht verdoppeln müssen.
Sprache auf Englisch und Französisch
Das Modell mit 1.6B deckt Englisch und Französisch von Haus aus ab. Das ist ein schmaler Bereich gegenüber manchen kommerziellen Engines, reicht aber für zweisprachige Produkte und hält das Modell klein genug für den eigenen Server.
Mehrere Wege beim Betrieb
Sie können das Modell auf drei Arten laufen lassen. Die PyTorch-Version dient Forschung und Tests, der Rust-Server trägt Produktionslast über Websockets und eine quantisierte Version läuft auf gewöhnlichen Rechnern.
Vor- und Nachteile
Vorteile
- Freie offene Gewichte unter einer großzügigen Lizenz, also keine Abrechnung pro Zeichen.
- Das Streaming-Design hält die Latenz niedrig genug für ein Live-Gespräch.
- Gute Stapelverarbeitung auf einer GPU, was die Kosten senkt, wenn viele Nutzer gleichzeitig bedient werden.
- Gestützt auf ein veröffentlichtes Paper, ein Colab-Notebook und ein Stimmen-Repository, sodass Sie nicht bei null anfangen.
Nachteile
- Keine gehostete API, also müssen Sie den Server selbst aufsetzen und pflegen.
- Eine GPU wird empfohlen, was günstiges Hosting für eine Echtzeitlast ausschließt.
- Nur Englisch und Französisch werden unterstützt, andere Sprachen brauchen ein anderes Modell.
- Stimmklonen ist auf berechnete Embeddings begrenzt, was freie Nachahmungen blockiert.
Häufige Fragen
Ja. Die Modellgewichte erscheinen unter CC-BY 4.0, also können Sie sie kostenlos herunterladen und starten. Sie zahlen nur für die Hardware, auf der es läuft.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Kyutai TTS.
Alternativen zu Kyutai TTS

Foley
Hanamori Labs, LLC · Stimme & Sprache · Produktivität · KI-AssistentFoley ist eine Sprach-To-do-Liste: Ein gesprochener Satz wird zur einsortierten Aufgabe mit Projekt, Datum und Uhrzeit, und danach plant die App den Tag um das, was schon auf der Liste steht.

HireKey
HireKey · Stimme & Sprache · Produktivität · LernenHireKey ist ein KI-Copilot für die Jobsuche, entwickelt von einer erfahrenen Tech-Recruiterin. Er prüft die Passung, passt den Lebenslauf an, trainiert Interviews und sammelt jede Bewerbung.

Fluence
Yay Software (Yannick Huchard) · Schreiben · Stimme & Sprache · ProduktivitätFluence ist eine Android-App, die PDF, EPUB, Word-Dateien und Web-Artikel vorliest, den gesprochenen Satz mitführt und Fragen zum Text direkt auf dem Telefon beantwortet.