
LiteLLM
BerriAI · Coding · Sonstiges
LiteLLM ist ein Open-Source-KI-Gateway und eine Python-Bibliothek, die über 100 LLMs über eine einzige Schnittstelle im OpenAI-Format aufruft, mit Routing, Kostenkontrolle und Guardrails.
Über LiteLLM
What Is LiteLLM
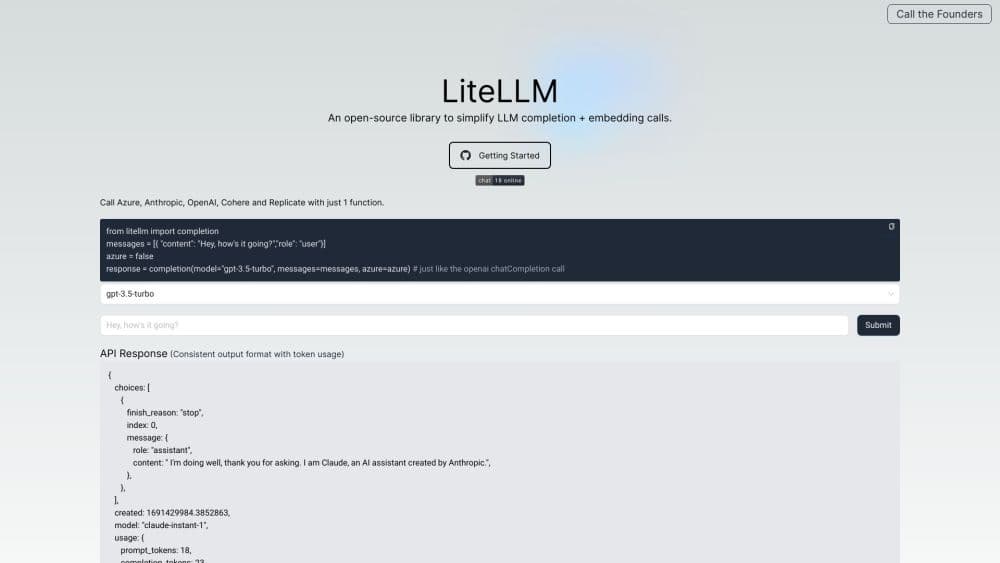
LiteLLM ist ein Werkzeug von BerriAI, das Entwicklern eine einzige Schnittstelle zum Aufrufen von Modellen von OpenAI, Anthropic, Gemini, Bedrock, Azure, Ollama und Dutzenden weiterer Anbieter bietet. Statt für jeden Anbieter ein eigenes SDK, ein eigenes Authentifizierungsverfahren und ein eigenes Antwortformat zu lernen, schreiben Sie einen Aufruf und ändern den Modellnamen, wenn Sie das Backend wechseln wollen.
Das Problem, das es löst, ist die Bindung an einen einzigen Anbieter. Teams, die auf einer Plattform aufbauen, stellen oft fest, dass ein Modellwechsel bedeutet, Request-Aufbau, Fehlerbehandlung und Streaming-Logik im ganzen Code neu zu schreiben. LiteLLM legt eine Übersetzungsschicht unter Ihren Code, sodass die Geschäftslogik gleich bleibt, während sich das zugrunde liegende Modell in einer Konfigurationsdatei ändert.
Zwei Betriebsarten decken die meisten Bedürfnisse ab. Das Python-SDK fügt sich als Paket in eine bestehende Anwendung ein, während das Gateway (Proxy-Server) als selbst gehosteter Dienst läuft, der virtuelle Schlüssel, Budgets und Protokolle für ein ganzes Team bündelt. Der Preis für diesen Komfort ist, dass das Gateway zusätzliche Infrastruktur zum Betreiben mitbringt und die Open-Source-Version davon ausgeht, dass Sie sie selbst hosten und aktualisieren.
Getting Started
- Installieren Sie das Paket mit
uv add litellmoderpip install litellmund legen Sie die API-Schlüssel Ihrer Anbieter als Umgebungsvariablen an. - Importieren Sie für den SDK-Weg
completionund rufen Sie es mit einem Modellnamen wieopenai/gpt-4ooderanthropic/claude-sonnet-4auf, wobei Sie Ihre Nachrichtenliste übergeben. - Starten Sie für den Gateway-Weg
litellm --model gpt-4ooder setzen Sie das Docker-Image ein und richten Sie dann jeden OpenAI-Client auf die lokale Basis-URL. - Ergänzen Sie eine Router-Konfiguration, wenn Sie Wiederholungen und Fallbacks über mehrere Deployments wollen, und verbinden Sie Postgres und Redis, wenn Sie mehr als eine Gateway-Instanz betreiben.
- Verfolgen Sie die Nutzung im Admin-Dashboard oder über einen Callback und setzen Sie Budgets je Schlüssel, Nutzer oder Team, während der Verkehr wächst.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von LiteLLM.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Backend-Entwickler
- Plattform- und ML-Teams
- Produktmanager, die Tests fahren
Aufgaben
- Einheitlicher Modellzugang
- Kostensteuerung
- Ausfallsicherheit und Lastverteilung
- Beobachtbarkeit
Szenarien
- Ein Startup, das mit einem Anbieter begonnen hat und günstigere Modelle ergänzen will, ohne die Geschäftslogik anzufassen.
- Ein Unternehmen, das ein selbst gehostetes Gateway betreibt, damit Modellverkehr und Schlüssel in der eigenen Infrastruktur bleiben.
- Eine Prototyping-Sitzung, in der ein einziges Skript denselben Prompt gegen fünf verschiedene Modelle testet.
Wichtigste Funktionen
Einheitliche API für über 100 Anbieter
Eine einzige Schnittstelle deckt OpenAI, Anthropic, Gemini, Bedrock, Azure, Vertex AI, Ollama, vLLM und viele mehr ab. Jede Antwort kommt im chat completions-Format von OpenAI zurück, sodass Code, der choices[0].message.content liest, nach einem Anbieterwechsel weiter funktioniert.
Direkte OpenAI-Kompatibilität
Projekte, die bereits das OpenAI-SDK nutzen, können ihren Client auf ein LiteLLM-Gateway richten, indem sie Basis-URL und Schlüssel ändern. Am Request-Code ist nichts anzupassen, was dies zu einem risikoarmen Weg macht, einer laufenden Anwendung Unterstützung für mehrere Modelle hinzuzufügen.
Proxy-Server und LLM-Gateway
Das selbst gehostete Gateway dient als zentraler Kontrollpunkt für ein Team. Es verwaltet virtuelle Schlüssel, erfasst Ausgaben je Schlüssel, Nutzer, Team und Organisation, erzwingt RPM- und TPM-Limits und bringt ein Admin-Dashboard für den Alltag mit.
Router mit Wiederholungen und Fallbacks
Das Router-Modul koordiniert mehrere Deployments desselben Modells. Es wiederholt fehlgeschlagene Aufrufe, weicht auf ein gesundes Deployment aus, wenn ein Anbieter ausfällt, und verteilt die Last über Backends, damit ein langsamer Endpunkt nicht die ganze Anwendung bremst.
Kostenerfassung und Budgets
LiteLLM berechnet die Kosten jedes Aufrufs und schreibt sie dem Schlüssel oder Projekt gut, das ihn ausgelöst hat. Teams können Monatsbudgets und Ratenlimits festlegen und die Ausgaben prüfen, ohne eine eigene Messung zu bauen.
Beobachtbarkeit und Guardrails
Eine einzige Callback-Zeile sendet Protokolle, Token-Zahlen und Traces an Langfuse, MLflow, Helicone und weitere Werkzeuge. Guardrails erlauben es, unsichere Ein- und Ausgaben zu filtern oder zu blockieren, und die Fehlerumwandlung hält anbieterspezifische Ausnahmen in vertrauten OpenAI-Typen.
Vor- und Nachteile
Vorteile
- Eine Schnittstelle im OpenAI-Format erspart es, für jeden Modellanbieter ein eigenes SDK zu lernen.
- Modellwechsel geschehen in der Konfiguration, was das Risiko senkt, dass ein Anbieterwechsel den Produktivcode bricht.
- Der Open-Source-Kern ist unter MIT-Lizenz kostenlos und lässt sich vollständig selbst hosten.
- Wiederholungen und Fallbacks des Routers verbessern die Verfügbarkeit, wenn ein Anbieter ausfällt.
- Kostenerfassung und Budgets geben Teams Einblick in Ausgaben, die sonst oft unsichtbar bleiben.
Nachteile
- Das Gateway ist ein weiterer Dienst, der eingesetzt, überwacht und aktualisiert werden muss, was kleinen Teams zusätzliche Betriebsarbeit aufbürdet.
- Der Betrieb über mehrere Instanzen erfordert Postgres und Redis, sodass ein ernsthaftes Deployment echte Infrastrukturanforderungen mit sich bringt.
- Funktionen wie SSO, SCIM, Audit-Logs und der Betrieb in abgeschotteten Netzen stecken hinter dem kostenpflichtigen Enterprise-Tarif.
- Eigenheiten neuer Anbieter können später als in den offiziellen SDKs ankommen, weshalb selten genutzte Endpunkte manchmal zusätzliche Konfiguration verlangen.
Häufige Fragen
LiteLLM lässt eine Anwendung viele verschiedene LLM-Anbieter über eine einzige Schnittstelle im OpenAI-Format aufrufen. Entwickler nutzen es, um bei einem Modellwechsel keinen Code neu zu schreiben und um Schlüssel, Budgets und Protokolle hinter einem selbst gehosteten Gateway zu bündeln.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu LiteLLM.
Alternativen zu LiteLLM
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.