
LlamaIndex
LlamaIndex, Inc. · Marketing · Sonstiges
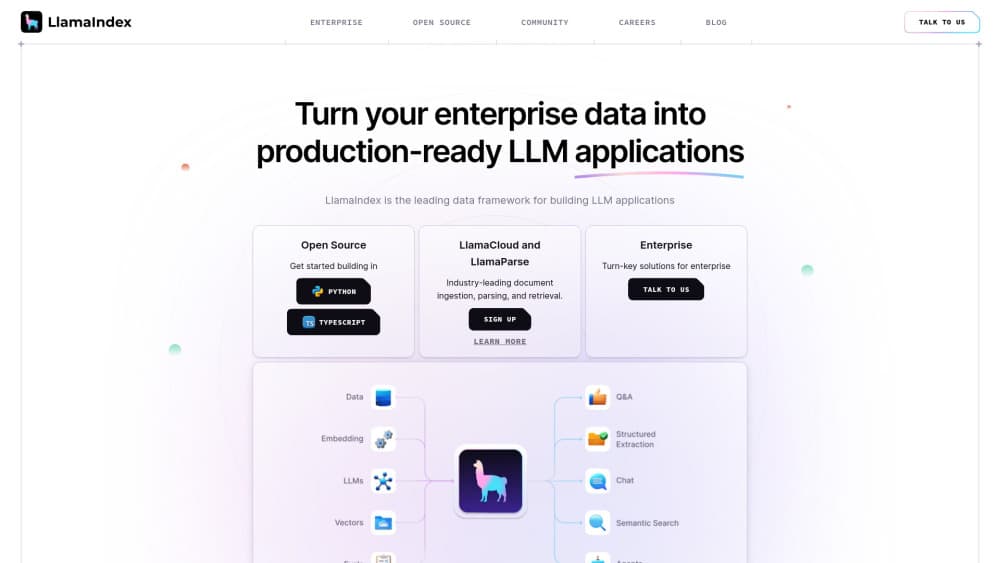
LlamaIndex ist ein Open-Source-Datenframework für RAG-Anwendungen und KI-Agenten. Sie laden eigene Dateien, bauen Indizes und liefern sauberen Kontext an das Modell, das Sie ohnehin nutzen.
Über LlamaIndex
About
Was ist LlamaIndex
LlamaIndex ist eine Codebibliothek zwischen Ihren Dokumenten und einem Sprachmodell. Das Projekt startete Ende 2022 als GPT Index, trägt seit 2023 den heutigen Namen und wird von LlamaIndex, Inc. in San Francisco betreut. Die MIT-Lizenz erlaubt es Ihnen, den Code zu lesen, zu forken und in ein kommerzielles Produkt einzubauen, ohne jemanden zu fragen.
Das Problem, das die Bibliothek löst, ist unspektakulär und dauerhaft. Ein Modell kennt das offene Web, nicht Ihre Verträge, Supporttickets oder Laboraufzeichnungen. LlamaIndex liefert die Leitungen, um solche Dateien zu laden, in Knoten zu zerlegen, in einem Vektorindex oder einem Stichwortindex abzulegen und bei einer Frage die passenden Ausschnitte zurückzuholen. Dieses Muster heißt RAG, und diese Bibliothek ist einer der beiden Namen, die fast jedes Team zu Beginn vergleicht.
Der Anbieter verkauft zusätzlich LlamaParse und LlamaCloud, einen gehosteten Dienst für Dokumentenverarbeitung, Extraktion und Indexierung. Die Trennung ist wichtig: Das Framework kostet nichts, die Teile, die aus einem gescannten PDF brauchbaren Text machen, sind kommerziell, werden in Credits abgerechnet und bleiben geschlossen.
Die wichtigste Einschränkung: Es ist ein Werkzeug für Entwickler. Für den Open-Source-Teil gibt es keine Oberfläche zum Zusammenklicken. Sie schreiben Python oder TypeScript, hinterlegen Ihre Schlüssel und suchen selbst nach der Ursache, wenn Antworten falsch ausfallen.
Erste Schritte
- Installieren Sie das Basispaket mit
pip install llama-index-coreund danach das Paket für Ihren Anbieter, etwallama-index-llms-openai. - Legen Sie den API-Schlüssel als Umgebungsvariable ab, oder richten Sie Settings.llm auf ein lokales Modell, wenn Sie eines betreiben.
- Laden Sie Dateien mit SimpleDirectoryReader oder einem LlamaHub-Konnektor für Notion, Slack, S3 oder eine Datenbank.
- Bauen Sie einen dauerhaften Index, meist einen Vektorindex, und speichern Sie ihn, damit die Einbettung nicht bei jedem Lauf neu berechnet wird.
- Verpacken Sie die Abfrage in einen Workflow, sobald Verzweigungen, Wiederholungen oder ein zweiter Agent dazukommen, und stellen Sie ihn als Dienst bereit.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von LlamaIndex.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Python-Entwickler mit der ersten RAG-Anwendung
- KI-Ingenieure, die eine Dokumentensuche betreuen
- Datenteams mit Bergen von eingescanntem Papier
Aufgaben
- Fragen zur internen Dokumentation beantworten
- Rechnungen, Verträge und Berichte auswerten
- Mehrstufige KI-Agenten bauen
- Suchstrategien vergleichen
Szenarien
- Ein Wissensdatenbank-Pilot im Unternehmen
- Literatur- und Patentrecherche
- Ein frühes Produkt ohne Infrastrukturbudget
Wichtigste Funktionen
Konnektoren für echte Datenquellen
LlamaHub sammelt hunderte Lader und Pakete für Netzlaufwerke, Notion, Slack, Google Drive, SQL-Datenbanken und Webcrawls. Alle geben dasselbe Document-Objekt mit Metadaten zurück, sodass ein Filter nach Datum oder Autor überall gleich funktioniert, egal woher der Text stammt. Diese Einheitlichkeit erspart Ihnen einen eigenen Adapter pro Quelle.
Mehrere Indextypen und hybride Suche
Sie sind nicht auf eine Form der Suche festgelegt. Der Vektorindex übernimmt semantische Treffer, der Stichwortindex fängt exakte Namen und Kennungen, und Zusammenfassungsindizes beantworten Fragen, die ein ganzes Dokument statt eines Absatzes brauchen. Sie kombinieren sie über einen Router oder einen Abrufer, der beide Ergebnislisten zusammenführt, und setzen einen Reranker darüber. Fast alle Teams landen nach der ersten Runde schlechter Antworten bei der hybriden Suche.
Ereignisgesteuerte Workflows
Workflows ersetzen die starren Ketten von früher. Jeder Schritt abonniert Ereignisse, reicht typisierte Ergebnisse weiter und kann schleifen, verzweigen oder auf die Freigabe einer Person warten. Weil es gewöhnliches asynchrones Python ist, schicken Sie Teilergebnisse an den Nutzer und lassen den Rest weiterlaufen. Verlässt der Ablauf das Notebook, wird er zum Microservice.
Dokumentenverarbeitung mit LlamaParse
LlamaParse ist für Dateien gebaut, an denen normale Lader scheitern: gescannte Seiten, dichte Tabellen, Diagramme und Handschrift. Ausgabe ist Markdown, reiner Text, JSON pro Seite oder XLSX, und der Anbieter nennt über 130 Dateitypen und 80 Sprachen. Der Analysemodus wird pro Auftrag gewählt, ein sauberes digitales PDF läuft also über die günstige Stufe und ein schlechter Scan über die langsamere agentische.
Die Plattform LlamaCloud
LlamaCloud bündelt Analyse, Extraktion, Klassifizierung, Aufteilung und Indexierung hinter einem Konto und einem API-Schlüssel. In der Weboberfläche testen Sie eine Datei, speichern eine Konfiguration und rufen dieselbe Konfiguration anschließend aus dem Code auf. Credits decken jede Aktion ab, und ein erneuter Lauf aus dem Cache kostet nichts, was beim Feilen an einem Prompt oder Schema hilft.
Bewertung und Tracing
Die Bibliothek enthält Module, die Treue und Relevanz der Antworten an Ihren eigenen Testfragen messen, und sie hängt sich an Tracing-Werkzeuge wie Arize Phoenix und LangSmith. Damit haben Sie eine Zahl zur Hand, wenn jemand fragt, ob eine Prompt-Änderung das Produkt besser gemacht hat. Ohne diese Schleife bleibt das Einstellen der Suche ein Ratespiel.
Vor- und Nachteile
Vorteile
- Die Suche steht im Zentrum des Entwurfs, eine lauffähige RAG-Pipeline braucht deshalb deutlich weniger Klebecode als ein allgemeines Agentenframework.
- Der Kern ist Open Source und steht unter MIT-Lizenz ohne Gebühr pro Sitz, und nichts hindert Sie daran, den ganzen Stapel selbst zu betreiben.
- Anbieter von Modellen und Vektordatenbanken lassen sich tauschen, Sie sind also nicht an die Preise eines einzigen Anbieters gebunden.
- LlamaParse liest Tabellen, Diagramme und Scans, die eine einfache Textextraktion zu Müll macht.
- Workflows liefern Verzweigungen, Wiederholungen und Freigaben durch Menschen, ohne die Bibliothek zu verlassen.
Nachteile
- Alles läuft über Code. Ein Team, das einen visuellen Builder erwartet hat, braucht vom ersten Tag an jemanden, der programmiert.
- Die Versionen erscheinen schnell und APIs werden umbenannt, Anleitungen von vor einem Jahr scheitern deshalb oft schon beim Import.
- LlamaCloud rechnet in Credits ab, 1.000 Credits entsprechen 1,25 USD, die Monatskosten lassen sich vor Tests mit echten Dateien kaum schätzen.
- Die beste Dokumentenverarbeitung ist der bezahlte, geschlossene Teil, eine vollständig offene Installation kommt mit PDF also schlechter zurecht.
Häufige Fragen
Das Framework ist kostenlos und steht unter MIT-Lizenz, Workflows und LlamaHub-Integrationen eingeschlossen. Tokens zahlen Sie weiterhin an Ihren Modellanbieter, und die Nutzung von LlamaCloud oder LlamaParse wird separat abgerechnet.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu LlamaIndex.
Alternativen zu LlamaIndex

ngram 2.0
ngram · Video · Marketingngram 2.0 ist ein KI-Videogenerator für Teams. Aus einem Prompt, einer Bildschirmaufnahme oder einer Produkt-URL entsteht ein Erklärvideo, eine Demo oder ein KI-Avatar-Video, und jede Szene bleibt bearbeitbar.

shippedit.me
Krawlup · Marketing · Businessshippedit.me leitet inzwischen auf Krawlup um, eine Web-Plattform, die SEO, AEO und Ladezeit wöchentlich prüft und die Korrekturen per MCP an Coding-Agenten übergibt.

MePersona
MePersona, Inc. · Schreiben · Produktivität · MarketingMePersona ist ein einheitlicher KI-Posteingang für Creator. Das Tool lernt Ihre Stimme, entwirft Antworten auf Fan-Nachrichten von 12 Plattformen und sendet nur, was Sie freigeben.