
LLMTest
LLMTest · Coding
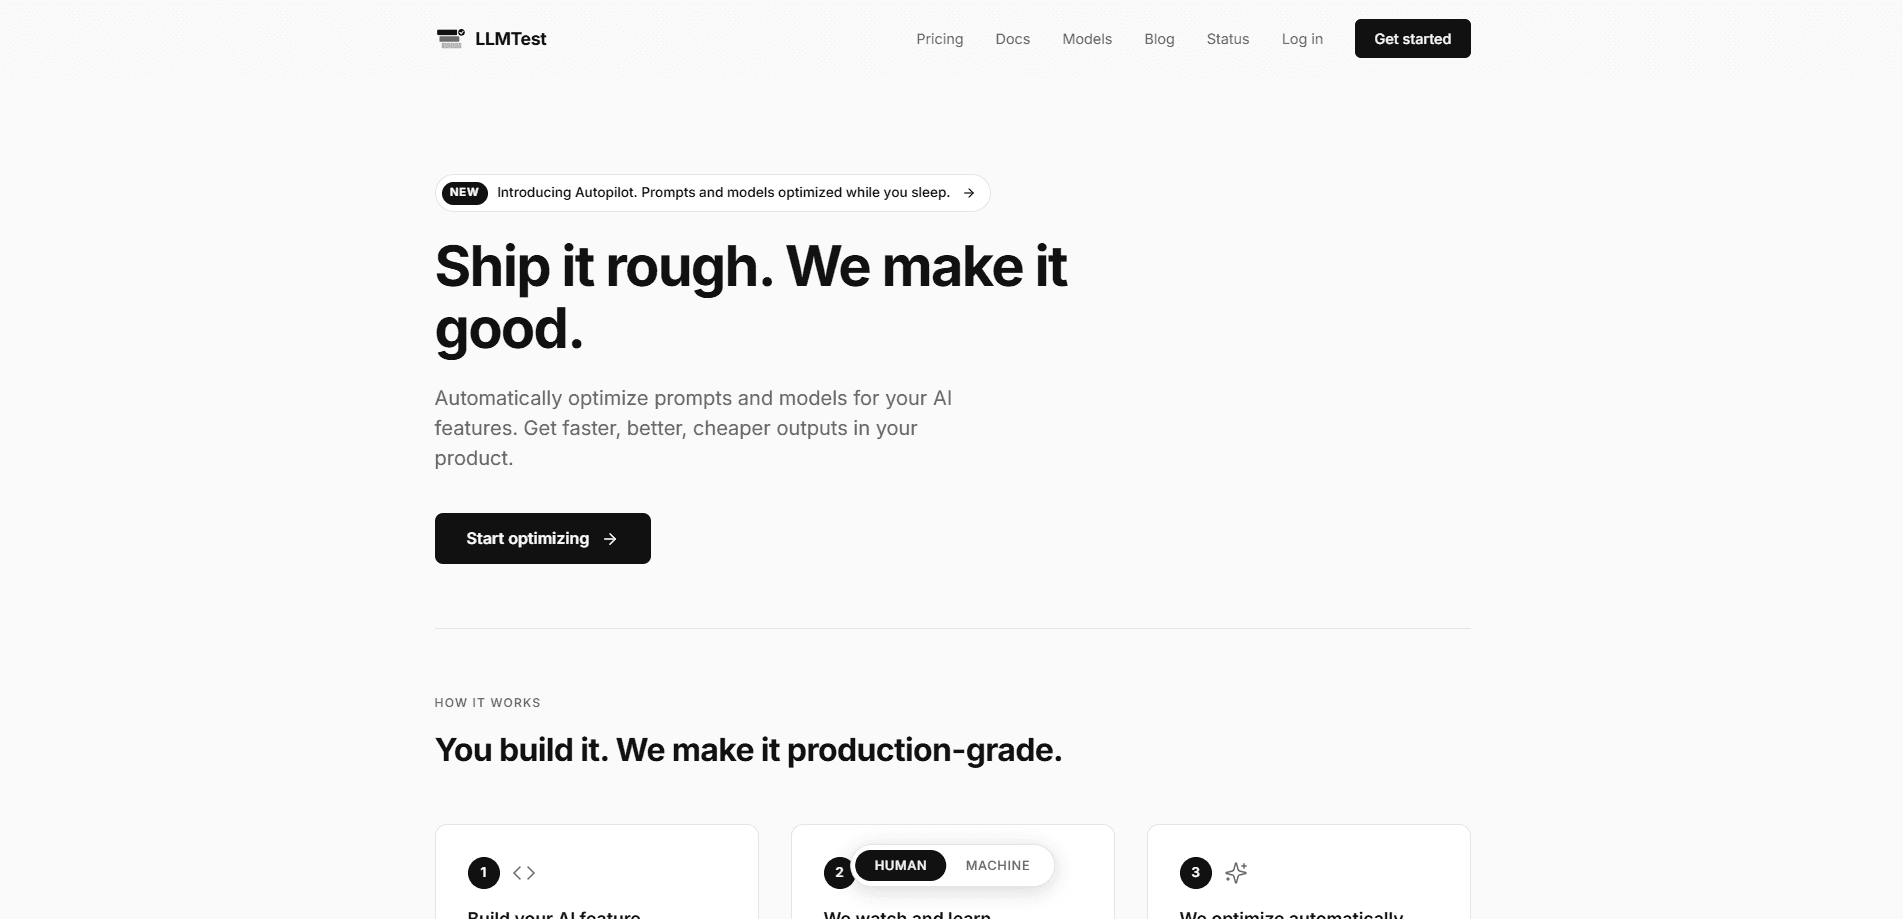
LLMTest ist eine Proxy-basierte Plattform zum Ausliefern und Testen von KI-Funktionen, die auf großen Sprachmodellen aufbauen. Sie richten Ihre App auf den OpenAI-kompatiblen Endpunkt aus, wählen eines von über 340 Modellen, und die Plattform übernimmt automatische Fallbacks, JSON-Reparatur und Kostenverfolgung ohne weiteren Aufwand. Sie vergleicht Modelle zudem, bevor Sie ausliefern, und hält mit Autopilot Ihre Prompts und Modellwahl jede Woche auf Basis echten Traffics in Form.
Über LLMTest
Was ist LLMTest
LLMTest ist ein Dienst, der zwischen Ihrem Produkt und den Modellanbietern sitzt, die Sie aufrufen. Statt Ihre App direkt an OpenAI, Anthropic oder Google anzubinden, leiten Sie Aufrufe über den Proxy von LLMTest unter https://llmtest.io/v1. Dieser eine Endpunkt spricht das OpenAI-Format, also ändern die meisten Teams eine Zeile (die Basis-URL) und sonst nichts.
Das Problem, das er angeht, kennen alle, die schon einmal eine KI-Funktion ausgeliefert haben: Sie wissen nicht, ob Sie das richtige Modell gewählt haben, Sie wissen nicht, was jede Funktion wirklich kostet, und Sie wollen nicht, dass Ihre App ausfällt, wenn ein Anbieter einen schlechten Tag hat. Denken Sie an einen LLM-Proxy mit Meinung. LLMTest beantwortet alle drei Punkte. Er vergleicht über 340 Modelle mit Ihren eigenen Prompts, taggt jeden Aufruf nach Flow, sodass Sie Kosten und Latenz pro Funktion sehen, und leitet Anfragen automatisch um, wenn ein Modell ausfällt oder gedrosselt wird. Die wichtigste Einschränkung ist, dass er für Entwickler gebaut ist, nicht für Endnutzer.
Die wichtigste Einschränkung ist, dass er für Entwickler gebaut ist, nicht für Endnutzer. Es gibt keine Drag-and-drop-Oberfläche für nicht technische Personen, und Autopilot greift nur bei Konten, die 14 Tage oder älter sind und mindestens 20 echte Aufrufe in einem Flow haben. Sie müssen sich beim Bearbeiten von Code und beim Lesen eines Dashboards wohlfühlen. Das ist der Kompromiss. Sie bekommen viel Kontrolle, bringen aber das technische Know-how mit.
Ein Modell-Fallback bedeutet hier eines: Wenn ein Anbieter ausfällt, übernimmt ein anderes Modell die Anfrage. LLMTest erledigt diesen Wechsel für Sie.
Erste Schritte
- Registrieren Sie sich unter llmtest.io/signup und laden Sie 5 Dollar Guthaben auf Ihr Konto.
- Kopieren Sie Ihren API-Schlüssel aus dem Dashboard. Schlüssel beginnen mit
llmt_. - Ändern Sie Ihre Basis-URL auf
https://llmtest.io/v1und nutzen Sie Ihren LLMTest-Schlüssel, oder wählen Sie ein Modell, wenn Sie neu anfangen. - Fügen Sie optional einen
X-Flow-Header hinzu, um Aufrufe zu taggen, damit Kosten und Latenz nach Funktion gruppiert werden. - Schalten Sie Autopilot ein, sobald Ihr Konto alt genug ist und ein Flow echten Traffic hat, und lassen Sie ihn wöchentlich laufen.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von LLMTest.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler, die KI-Funktionen ausliefern
- Engineering-Leads, die KI-Ausgaben im Blick behalten
- Teams, die ein Modell von Grund auf wählen
Aufgaben
- Modell-Fallbacks ohne neuen Code hinzufügen
- Kaputte JSON-Antworten reparieren
- Günstigere Modelle finden, die Qualität halten
- Token-Kosten pro Funktion verfolgen
Szenarien
- Ein Chatbot, der ausfällt, wenn ein Anbieter nicht erreichbar ist
- Ein Startup, das seine erste KI-Funktion vorbereitet
- Ein Live-Produkt mit wöchentlichen Modellveröffentlichungen
Wichtigste Funktionen
Ein OpenAI-kompatibler Endpunkt für über 340 Modelle
LLMTest stellt eine einzige API unter https://llmtest.io/v1 bereit, die das OpenAI-Format spricht. Das heißt, das offizielle openai-Paket für JavaScript und Python funktioniert, nachdem Sie Basis-URL und Schlüssel geändert haben. Sie können gpt-4o, anthropic/claude-sonnet-4, google/gemini-2.5-flash, meta-llama/llama-4-scout oder jedes andere unterstützte Modell über denselben Codepfad aufrufen. Denken Sie an ein LLM-Gateway, das die Anbietervielfalt verbirgt. Für ein Team, das bereits ein OpenAI-SDK nutzt, ist das die kleinste mögliche Migration.
Automatische Fallbacks und JSON-Wiederherstellung
Fallbacks und JSON-Reparatur funktionieren, sobald Sie über den Proxy leiten, ohne Feature-Flags oder zusätzlichen Code. Wenn ein Modell einen 429 oder einen 5xx zurückgibt, wiederholt LLMTest Ihre Anfrage auf einem anderen Modell, und Ihre App sieht den Fehler nie. Wenn Sie eine JSON-Ausgabe anfordern und das Modell etwas Fehlerhaftes liefert, korrigiert der Proxy es oder wiederholt es. Sie sehen nur die Standard-Antwortform, also bleibt Ihre Parsing-Logik unverändert. Wenn Sie festhalten wollen, wann ein Wechsel passiert ist, sagt Ihnen der Antwort-Header x-llmtest-fallback-model, welches Modell den Aufruf tatsächlich bedient hat. Kein Raten. Er sagt es Ihnen einfach.
Kostenverfolgung nach Flow
Jeder Aufruf wird mit Token-Zahlen, Latenz und Kosten protokolliert. Sie taggen Aufrufe mit einem optionalen X-Flow-Header, und LLMTest gruppiert alles nach diesem Namen. So erscheinen "Support-Chatbot" und "Produktbeschreibungen" als getrennte Posten statt als ein verschwommener Gesamtwert. Das ist der nützliche Teil. Damit lässt sich über KI-Kosten mit Zahlen statt mit Gefühl diskutieren.
Benchmarking, bevor Sie ausliefern
Wenn Sie noch kein Modell gewählt haben, füllt der Benchmark-Modus von LLMTest diese Lücke. Sie beschreiben die KI-Funktion, das System erzeugt Test-Prompts und führt clevere Benchmarks über 340+ Modelle aus. Ein KI-Richter bewertet jede Ausgabe, und die Auswahllogik wählt die relevantesten Herausforderer, statt alle 340 blind zu testen. Kein echter Traffic nötig. Sie können Modelle vor dem Start vergleichen.
Wöchentliche Optimierung mit Autopilot
Autopilot schreibt Ihre Prompts um und sucht günstigere oder bessere Modelle mit Ihrem echten Traffic, jede Woche im Hintergrund. Er testet kürzere und günstigere Varianten, und nur sichere Gewinne gehen live. Sie bekommen montagmorgens eine E-Mail mit dem, was sich geändert hat, was Sie gespart haben und einem 24-Stunden-Rückgängig-Link. Ein Klick macht jede Änderung rückgängig.
Sicherheitsschranken bei jeder Änderung
Autopilot-Änderungen passieren fünf Prüfungen, bevor sie ausgeliefert werden, und das ist der Teil, der zählt, wenn Sie die Produktion nicht kaputt machen wollen. Ein Gewinn braucht eine Gewinnrate mit 95 % Konfidenz, zwei unabhängige Richter (Claude Sonnet und GPT-4o, mit getauschten Positionen), die bei 80 % oder mehr übereinstimmen, mindestens 20 % Ersparnis, ein goldenes Set aus fünf bekannten guten Eingaben, das besteht, und keine Längenverzerrung (Varianten, die 50 % länger als die Basis sind, brauchen menschliche Freigabe). Er überspringt zudem Konten, die jünger als 14 Tage sind, und erzwingt eine Abkühlzeit von 14 Tagen pro Flow, sodass dieselbe Funktion in diesem Fenster nie zweimal neu abgestimmt wird. Das sind viele Schranken.
MCP-Server für IDE-Workflows
LLMTest läuft auch als MCP-Server in Ihrer IDE, neben dem Produktions-Proxy. Die meisten Teams nutzen den Proxy in der Produktion für Zuverlässigkeit und Kostenverfolgung und den MCP-Server während der Entwicklung für Benchmarking und Modellauswahl. Beide teilen denselben API-Schlüssel und dieselben Daten, sodass das, was Sie während der Entwicklung testen, mit dem übereinstimmt, was live läuft.
Vor- und Nachteile
Vorteile
- Ein Endpunkt deckt über 340 Modelle von OpenAI, Anthropic, Google, Meta und Mistral ab, was den Aufwand für getrennte Anbieterintegrationen senkt.
- Fallbacks und JSON-Wiederherstellung sind standardmäßig an, also funktioniert Zuverlässigkeit ohne zusätzlichen Code.
- Die Kostenverfolgung pro Flow liefert eine Aufschlüsselung der KI-Ausgaben, die die meisten Teams sonst nicht erstellen können.
- Die fünf Sicherheitsschranken von Autopilot (Konfidenz, doppelte Richter, Sparschwelle, goldenes Set, Längenprüfung) machen automatische Prompt-Änderungen weniger riskant, als sie klingen.
- Der Einstiegspreis von 5 Dollar ist niedrig genug, um das Ganze an einer echten Funktion zu testen.
Nachteile
- Autopilot läuft erst, wenn ein Konto 14 Tage oder älter ist und ein Flow 20 oder mehr echte Aufrufe hat, also warten neue Projekte, bevor die Kernfunktion anspringt.
- Es gibt keine öffentliche Preisseite mit festen Stufen; Sie laden Guthaben auf und zahlen nach Nutzung, was die Budgetplanung im Voraus weniger vorhersehbar macht.
- Es setzt voraus, dass Sie Entwickler sind. Nicht technische Nutzer werden von einem Proxy, der Basis-URL und Header braucht, nicht viel haben.
Häufige Fragen
Es ist eine Proxy- und Testschicht für KI-Funktionen. Sie leiten Ihre Modellaufrufe über den OpenAI-kompatiblen Endpunkt, und er ergänzt Fallbacks, JSON-Reparatur, Kostenverfolgung, Modell-Benchmarking und automatische Prompt-Optimierung. Noch unsicher, ob Sie es brauchen? Lesen Sie weiter.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu LLMTest.
Alternativen zu LLMTest
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.