
Ollama
Ollama · Bilder · Sonstiges
Ollama ist eine lokale KI-Laufzeit, um große Sprachmodelle auf dem eigenen Rechner auszuführen. Sie lädt offene Modelle wie Gemma 4, Qwen und gpt-oss, mit Cloud-Option für zu große Modelle.
Über Ollama
What Is Ollama
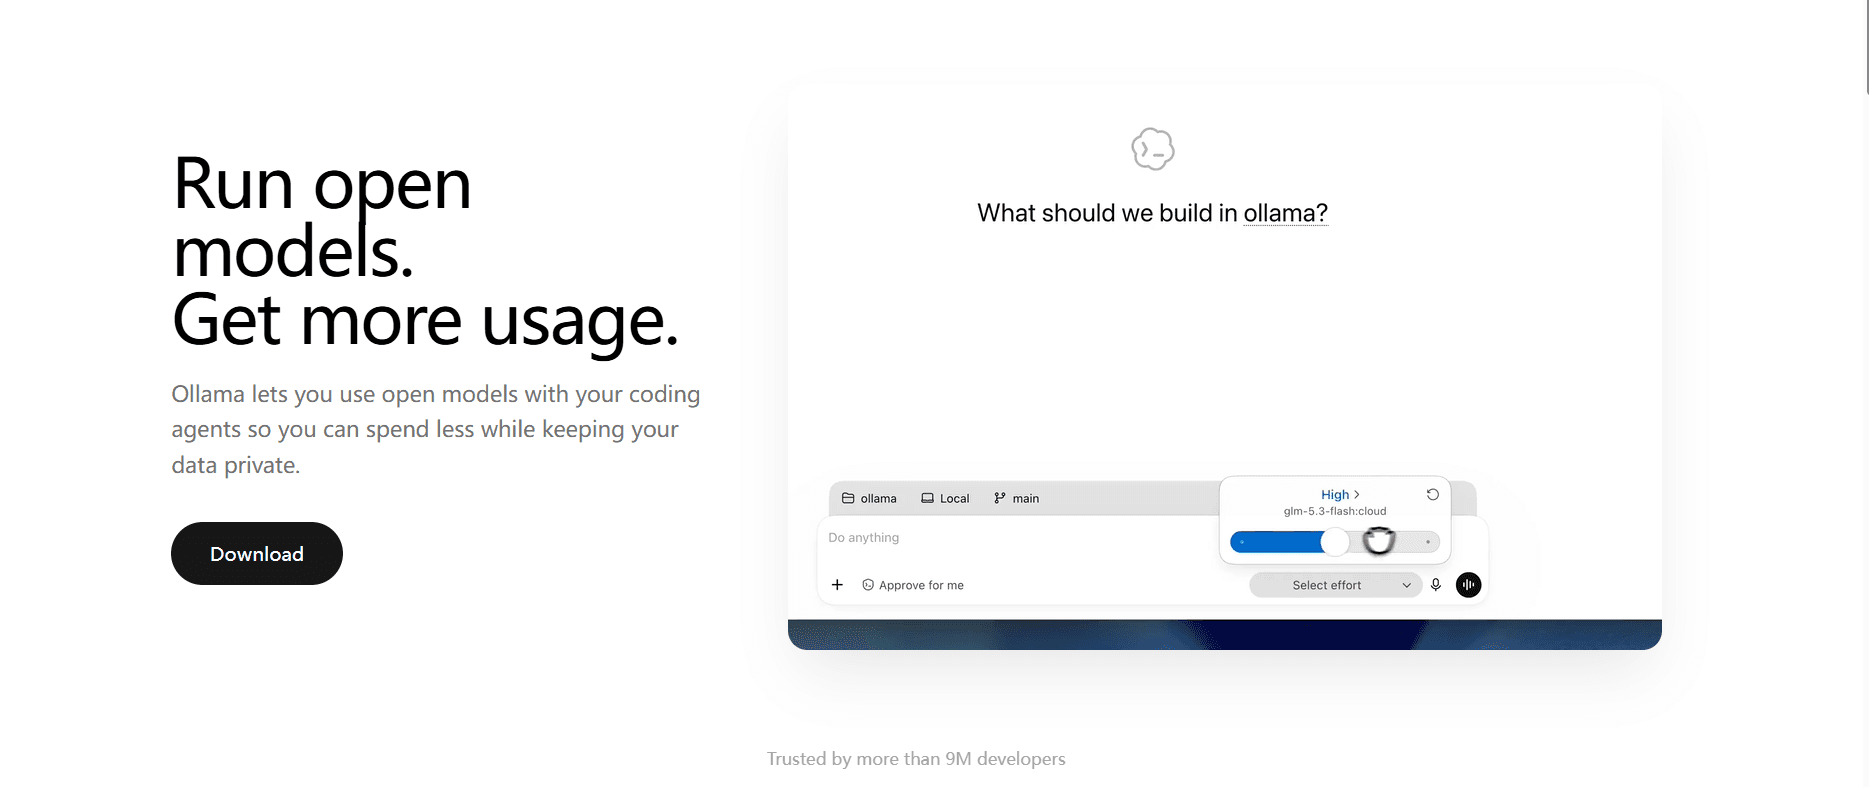
Ollama ist eine Open-Source-Laufzeit, die große Sprachmodelle auf dem eigenen Computer ausführt. Statt ein Modell über eine API zu mieten, laden Sie die Gewichte einmal herunter und unterhalten sich offline. Ein einzelner Befehl lädt und startet das Modell, und die Anwendung erledigt das Unangenehme: Quantisierungsformate, Auslagerung auf GPU oder Apple-Silicon-Chips, Speichergrenzen und den Serverprozess, der Anfragen beantwortet.
Das Projekt startete im Juli 2023 und wuchs schnell. Heute kommen über 9 Millionen Installationen pro Monat und mehr als eine Milliarde Modell-Downloads zusammen. Im Jahr 2026 sammelte das Unternehmen 88 Millionen Dollar von Benchmark, Y Combinator und weiteren Investoren ein und ergänzte eine Cloud-Ebene für Modelle, die zu groß für einen Laptop sind.
Diese Cloud-Ebene ist der wichtigste Kompromiss. Modelle lokal auszuführen ist immer kostenlos und unbegrenzt, doch die Grenze ist Ihre Hardware: Ein 7B-Modell läuft auf einem einfachen Laptop, ein 200B-Modell verlangt eine echte Maschine mit GPU. Cloud-Modelle nehmen diese Obergrenze weg und werden pro Token abgerechnet. Ollama ist damit zugleich ein kostenloses lokales Werkzeug und ein nutzungsbasierter Dienst, je nach gewähltem Modell.
Getting Started
- Laden Sie Ollama für macOS, Windows oder Linux herunter oder nutzen Sie das offizielle Docker-Image und öffnen Sie die Anwendung.
- Holen Sie ein Modell mit
ollama pull gemma4:e2b(der Download liegt bei etwa 7,2 GB), oder wählen Sie bei der Einrichtung Local, wenn Sie kein Konto möchten. - Führen Sie
ollama run gemma4:e2baus, um im Terminal zu chatten, oder starten Sie einen Coding-Agenten mitollama launch claude. - Für eigene Anwendungen senden Sie Anfragen an die lokale REST-API auf Port 11434 oder richten einen OpenAI- oder Anthropic-Client auf die kompatiblen Endpunkte von Ollama aus.
- Melden Sie sich an und erzeugen Sie einen Schlüssel, wenn Sie Cloud-Modelle wollen, und halten Sie schwere Anfragen von Ihrer eigenen Hardware fern.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Ollama.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler, die offene Modelle ohne Cloud-Rechnung testen
- Nutzer mit hohen Datenschutzanforderungen
- Teams, die Coding-Agenten ausrollen
- Forscher, die Modellfamilien vergleichen
Aufgaben
- Ein Chatmodell offline betreiben
- KI in eine Anwendung einbauen
- Das Verhalten über ein Modelfile steuern
- Agenten und Editoren anbinden
- Strukturierte Daten aus einem Modell holen
Szenarien
- Ein Laptop im Flugzeug
- Ein Unternehmen mit strengen Datenschutzregeln
- Ein schneller Prototyp vor einer Cloud-Rechnung
- Eine Coding-Session mit lokalem Agenten
Wichtigste Funktionen
Lokale Modelle mit einem Befehl
Das zentrale Versprechen passt in eine Zeile: ollama pull holt die Gewichte, ollama run öffnet den Chat. Ollama kümmert sich hinter den Kulissen um Quantisierung, Speicherverteilung und den Modellserver, sodass Sie das übliche Hin und Her mit CUDA-Versionen und Python-Umgebungen überspringen. Die Modelle stammen aus einer eingebauten Bibliothek mit Gemma, Qwen, gpt-oss, DeepSeek, Kimi, MiniMax, GLM, Mistral und Nemotron.
Cloud-Modelle mit Token-Preisen
Nicht jedes Modell passt auf einen Laptop, deshalb hat Ollama eine Cloud-Ebene ergänzt, die größere offene Modelle auf der Hardware von NVIDIA-Cloud-Anbietern ausführt. Sie zahlen pro Million Token, mit Nebenzeittarifen, die den Preis außerhalb der Geschäftszeiten an Werktagen fast halbieren. Kostenlose Konten erhalten Startguthaben, bezahlte Pläne bringen ein monatliches Kontingent mit.
REST-API und OpenAI-Kompatibilität
Jedes lokale Modell stellt einen HTTP-Server auf Port 11434 bereit, sodass jede Sprache damit sprechen kann. Ollama versteht außerdem die Formate OpenAI Chat Completions und Responses sowie Anthropic Messages. Werkzeuge, die für diese APIs gebaut sind, laufen daher nach einer Änderung der Basis-URL, meist ohne Codeanpassung.
MLX-Engine auf Apple Silicon
Auf Macs führt Ollama unterstützte Modelle über Apples MLX-Framework statt über eine übersetzte Laufzeit aus. Der Wechsel brachte 2026 große Geschwindigkeitsgewinne, darunter die Vorhersage mehrerer Token, die das Unternehmen bei Coding-Agenten mit bis zu 90 % schneller misst. Auch der Speicherverbrauch sank, was bei Macs mit Unified Memory zählt, wo der Arbeitsspeicher die harte Grenze ist.
Integration von Agenten und Desktop
ollama launch claude, ollama launch codex und ähnliche Befehle verbinden Coding-Agenten mit Ihren Modellen. Auf dem Desktop lassen sich Claude und ChatGPT (Desktop) auf Ollama richten, was Modelle wie Muse Glimmer und Nemotron in bereits genutzte Werkzeuge bringt.
Modelfiles und Modellerstellung
Ein Modelfile ist ein kurzes Rezept für ein eigenes Modell: Basisgewichte, System-Prompt, Parameter und Vorlage. Sie bauen es mit ollama create, und die Definition wandert mit dem Modell. Geteilte Anweisungen bleiben so im ganzen Team gleich, statt in verstreuten Notizen zu leben.
Embeddings und strukturierte Ausgaben
Ollama führt Embedding-Modelle wie EmbeddingGemma aus und liefert Vektoren für Suche oder Gruppierung. Der Parameter format nimmt ein JSON-Schema an, damit das Modell mit einem getypten Objekt antwortet. So wird Freitext zu Daten, die ein Programm ohne Rätselraten liest.
Entscheidungsmodelle
Neuere Versionen ergänzen Entscheidungsmodelle, die Auswahlmöglichkeiten, Bewertungen und Wahrscheinlichkeiten statt Prosa liefern. Sie basieren auf der Jev-API von TypeSafe, eignen sich für Ticket-Triage oder Inhaltsklassifizierung, und Ollama führt sie über einen eigenen Endpunkt neben den üblichen Chatmodellen aus.
Vor- und Nachteile
Vorteile
- Lokale Modelle sind kostenlos und unbegrenzt, ohne Konto, Schlüssel oder Internetverbindung.
- Die Installation ist ein einziger Befehl, und die eingebaute Bibliothek erspart die Umgebungseinrichtung.
- Die REST-API und die OpenAI- und Anthropic-kompatiblen Endpunkte lassen bestehende Clients mit einer URL-Änderung umsteigen.
- Die Apple-Silicon-Unterstützung über MLX bringt Mac-Nutzern große Geschwindigkeitsgewinne.
- Cloud-Modelle erlauben große offene Modelle, ohne eine GPU zu besitzen.
Nachteile
- Die lokale Leistung hängt an Ihrer Hardware, große Modelle brauchen echten VRAM und ein Laptop tut sich damit schwer.
- Der Cloud-Preis hängt vom Modell und der Tageszeit ab, was die Monatsrechnung schwerer planbar macht.
- Einige fortgeschrittene Cloud-Funktionen wie mehrere Modelle gleichzeitig sind im Gratisplan durch Nebenläufigkeitsgrenzen beschränkt.
- Die Modellbibliothek ist breit, aber kleiner als das volle Angebot von Hugging Face oder der großen Cloud-Anbieter.
Häufige Fragen
Ollama ist eine Laufzeit, um offene große Sprachmodelle auf dem eigenen Computer oder in der Cloud auszuführen. Es lädt die Modelle, startet einen lokalen Server und bietet eine Kommandozeile, eine Desktop-App und eine API.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Ollama.
Alternativen zu Ollama

Google EmbeddingGemma 2
Google DeepMind · Schreiben · Bilder · CodingGoogle EmbeddingGemma 2 ist ein offenes Modell mit 740 Millionen Parametern, das Text, Code, Bilder, Audio und Videobilder in Vektoren eines gemeinsamen 768-dimensionalen Raums umwandelt und auf Handys und Notebooks läuft.

Tractionwave
TractionWave · Bilder · MarketingTractionWave erstellt per KI eine Aufmerksamkeits-Heatmap für statische Anzeigen. Sie laden ein PNG oder JPG hoch und bekommen prognostizierte Aufmerksamkeit, sortierte Hotspots und Korrekturen, bevor Budget fließt.

Imejis.io
Imejis.io · Bilder · MarketingImejis.io ist ein KI-Designstudio für Agenten und Marketingteams. Sie beschreiben ein Bild in eigenen Worten, und das Werkzeug schreibt den Text, baut das Layout, passt es an jedes Format an und exportiert die fertige Datei.