
OpenObserve
OpenObserve · Coding · Produktivität
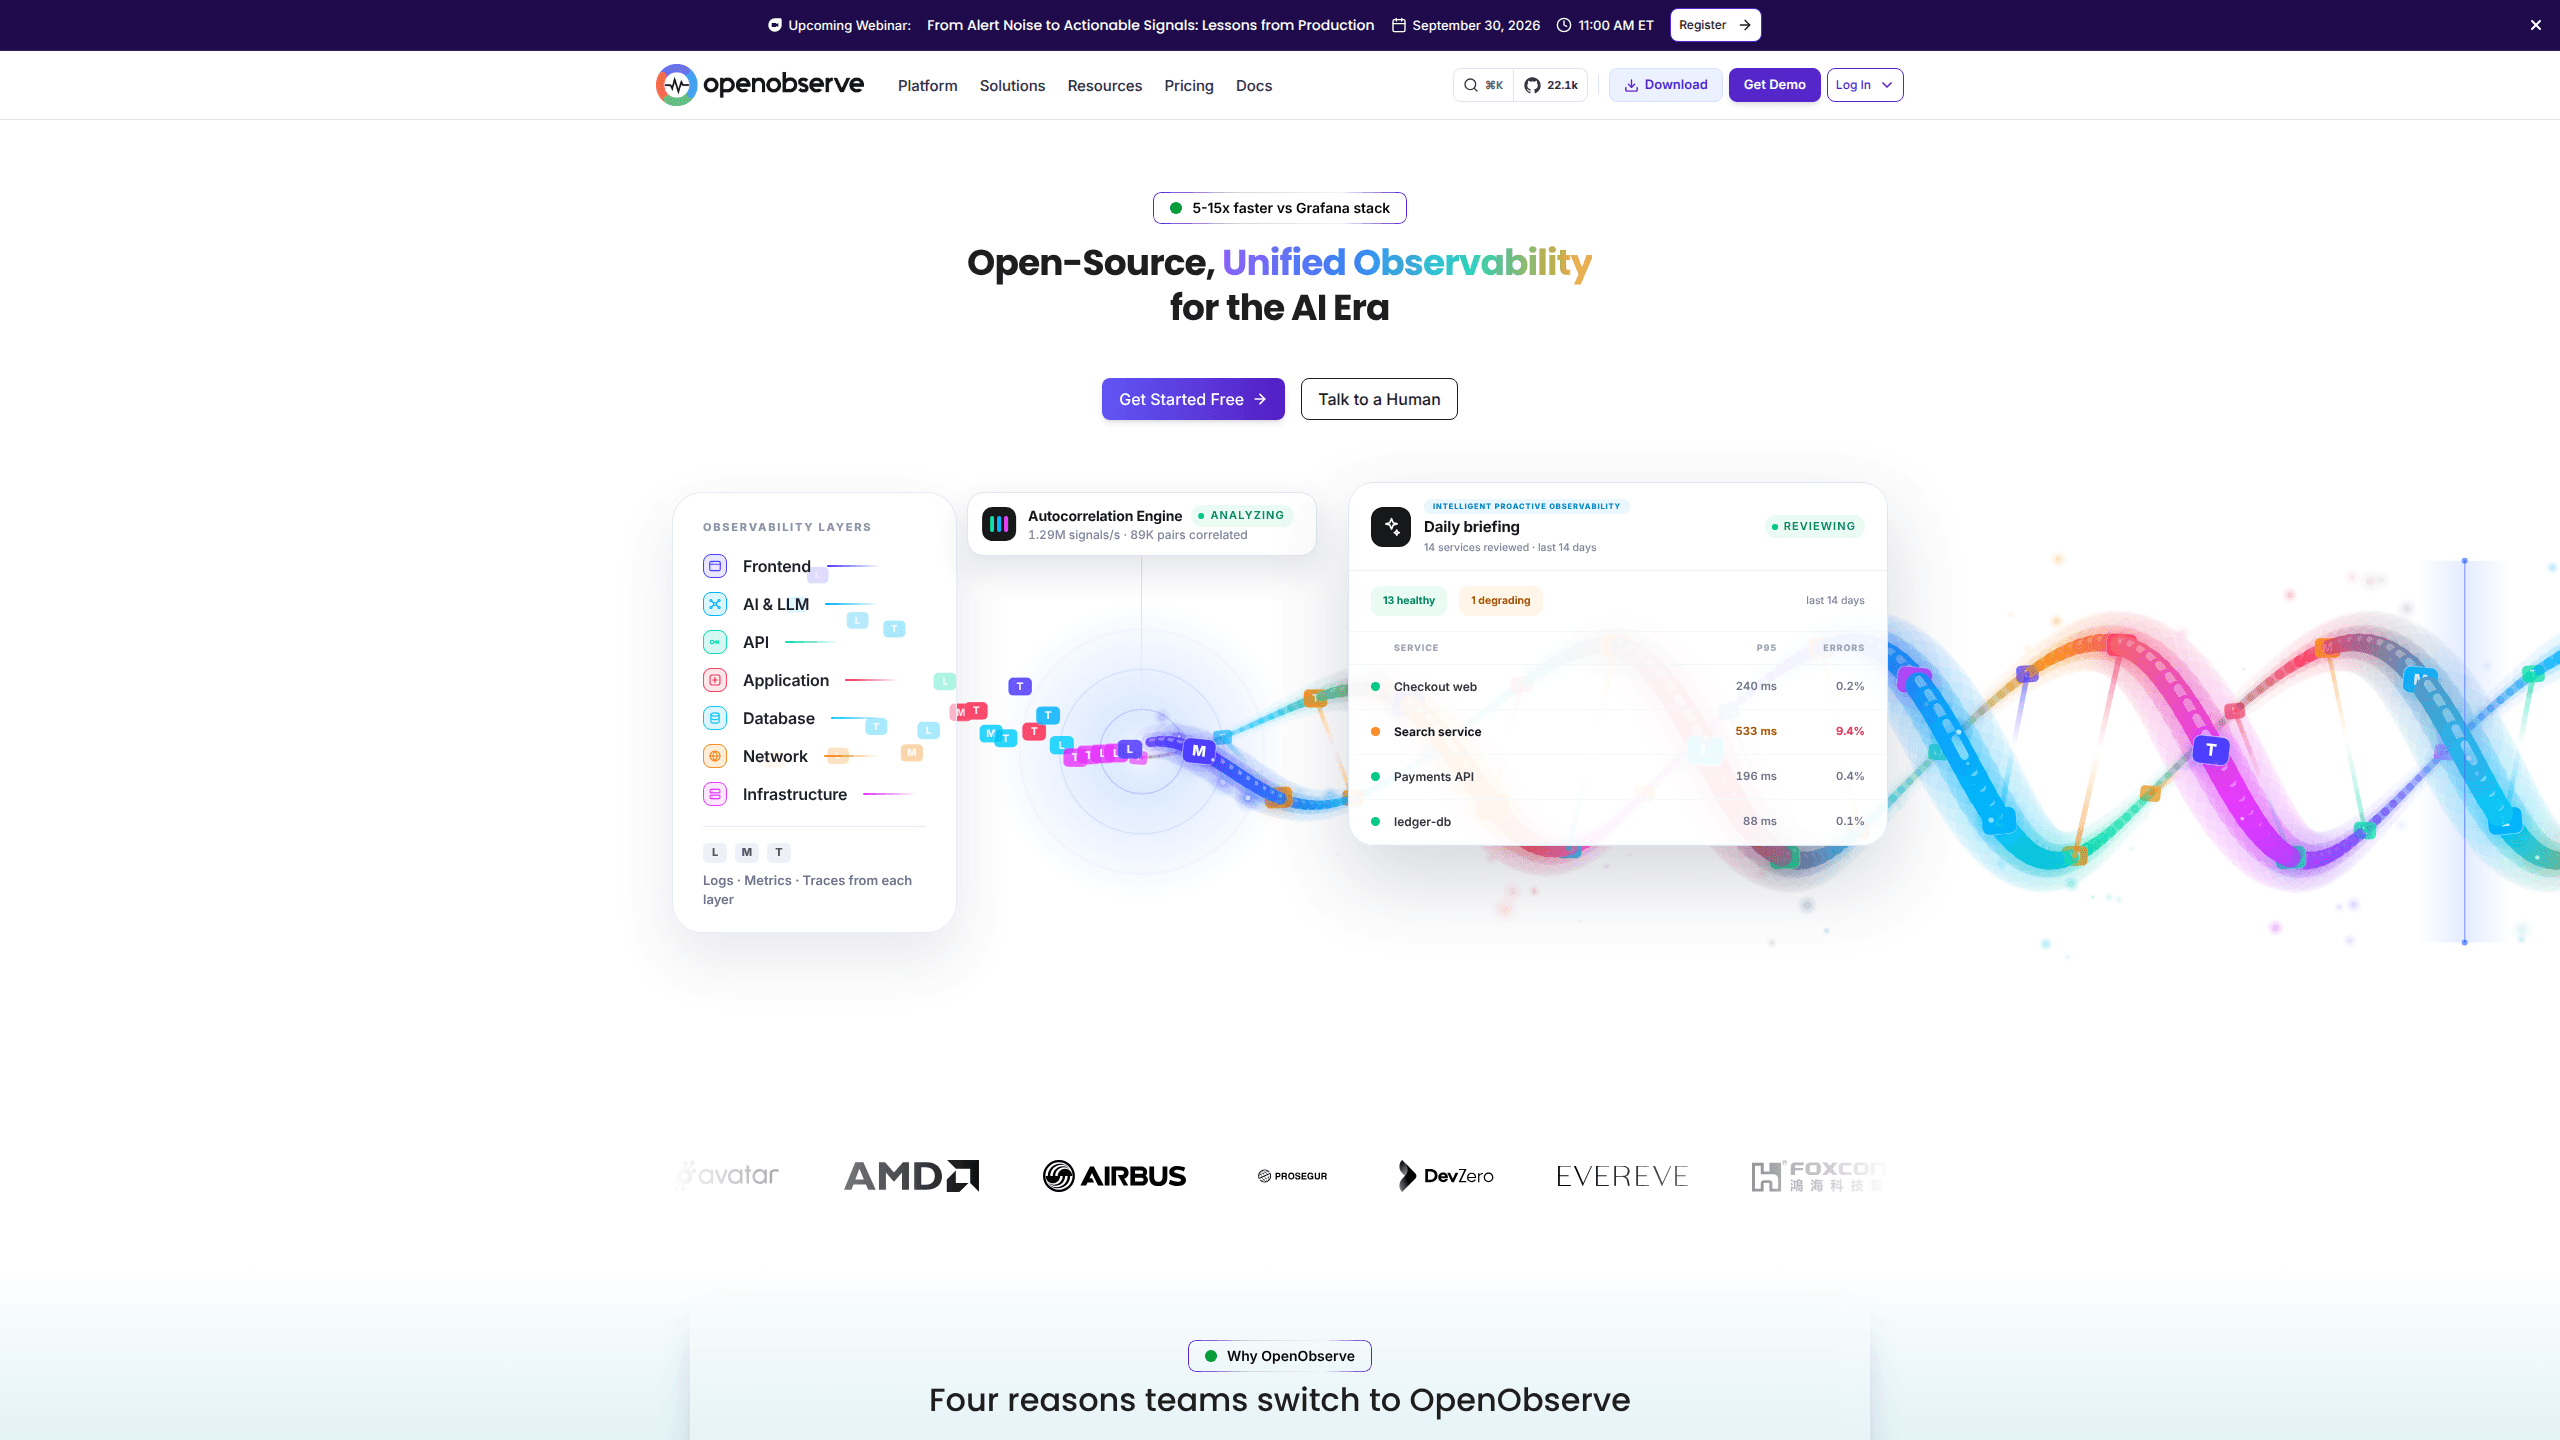
OpenObserve ist eine Open-Source-Observability-Plattform, die Logs, Metriken, Traces, Real User Monitoring und LLM-Observability in einem einzigen Tool vereint. Sie ist als günstigere und einfachere Alternative zu Datadog, Splunk und Elasticsearch gebaut, mit Preisen pro GB und einem Single-Binary-Deployment, das eine lauffähige Instanz in Minuten startet. Teams greifen dazu, wenn die Speicherrechnungen schneller wachsen als der Wert, den sie aus den Daten ziehen.
Über OpenObserve
Was ist OpenObserve
OpenObserve ist eine cloud-native Observability-Plattform für die Daten, die ihre Systeme ständig erzeugen: Logzeilen, Metriken und Traces. Alles an einem Ort. Das Projekt erschien 2022, um einen konkreten Frust zu lösen. Teams zahlten immer mehr, um Telemetrie zu speichern, die sie kaum durchsuchen konnten, verteilt über Tools, die nie ganz zusammenpassten. OpenObserve legt jedes Signal an einen Ort und speichert es im spaltenorientierten Parquet-Format auf Objektspeicher, und damit wirbt es mit bis zu 140-mal niedrigeren Speicherkosten als Elasticsearch.
Sie können es als gemanagten Cloud-Dienst betreiben oder den Open-Source-Kern unter AGPL-3.0 selbst hosten. Beide Wege nehmen Daten über OpenTelemetry an, also sperrt die einmalige Instrumentierung Ihrer App Sie nicht bei einem einzigen Anbieter ein. Die Abfragesprachen SQL und PromQL sorgen dafür, dass jeder, der schon einmal eine Datenbankabfrage geschrieben hat, sofort in seinen Daten stöbern kann.
Die größte Einschränkung ist die Skalierung auf dem kostenlosen Self-Hosting-Weg. Einzelknoten-Setups eignen sich für Evaluierung und kleine Produktionslasten, doch Hochverfügbarkeits-Clustering und lange Aufbewahrung drängen Teams meist zu den Cloud-Stufen oder der Enterprise-Edition. Auch der Support läuft hier anders. Die Community hilft über Slack und GitHub, während bezahlte Tarife die SLAs und das Account-Management hinzufügen, die größere Unternehmen erwarten.
Erste Schritte
- Melden Sie sich bei der gemanagten Cloud unter cloud.openobserve.ai an, oder führen Sie den Docker-Befehl von der OpenObserve-Startseite aus, um eine selbst gehostete Instanz lokal zu starten.
- Öffnen Sie die Weboberfläche (localhost:5080 für das lokale Docker-Setup) und melden Sie sich mit Ihren Root-Zugangsdaten an.
- Richten Sie den OpenTelemetry-Exporter Ihrer Anwendung auf OpenObserve aus, oder verbinden Sie eine vorhandene Datenquelle, damit Ströme einlaufen.
- Erkunden Sie eingehende Daten in den Ansichten für Logs, Metriken und Traces, und bauen Sie dann ein Dashboard oder einen Alarm rund um das, was am wichtigsten ist.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von OpenObserve.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Backend- und Plattform-Engineers
- DevOps- und SRE-Teams
- Startups mit Blick auf Cloud-Ausgaben
Aufgaben
- Log-Management zentralisieren
- Verteiltes Tracing
- LLM-Observability
Szenarien
- Von Datadog oder Splunk weg migrieren, um eine aus dem Ruder gelaufene Observability-Rechnung zu kürzen
- Einen Produktionsausfall über Dienste hinweg debuggen
- Eine KI-gestützte Funktion in Produktion überwachen
Wichtigste Funktionen
Vereinheitlichte Analyse von Logs, Metriken und Traces
OpenObserve speichert alle drei großen Signaltypen in einer einzigen Plattform statt in drei getrennten Tools. Sie haben eine Suchleiste, einen Dashboard-Baukasten und einen Ort, um einen Anstieg von Fehler-Logs mit dem Trace zu korrelieren, der ihn verursacht hat. Genau diese Korrelation ist der Punkt. Wenn Sie einen laufenden Incident verfolgen, kostet der Tab-Wechsel Zeit, die Sie nicht haben.
OpenTelemetry-native Erfassung
Die Plattform baut auf dem OpenTelemetry-Standard auf, also sendet Ihre vorhandene Instrumentierung Daten ohne eigene Adapter. Das ist ein echter Schutz gegen Anbieterbindung, was unter kommerziellen Monitoring-Tools selten ist. Weil das Format offen ist, können Sie später zu anderen Backends wechseln oder von ihnen weg, ohne Ihre Kollektoren neu zu schreiben.
Parquet-Speicher auf Objektspeicher
Logs und Traces landen in spaltenorientierten Parquet-Dateien auf S3-kompatiblem Objektspeicher. Kompression und spaltenorientiertes Layout sind es, die die beworbenen 140-fachen Speichereinsparungen gegenüber Elasticsearch tragen. Für Teams, die Jahre an Daten für die Compliance behalten, zeigt sich dieser Unterschied direkt auf der Rechnung.
Abfragen mit SQL und PromQL
Sie fragen Logs und Traces mit SQL und Metriken mit SQL oder PromQL ab. Keine proprietäre Abfragesprache zu lernen. Wenn Ihr Team täglich SQL schreibt, ist die Lernkurve nahe null, und PromQL lässt bestehende Grafana-Nutzer ihre Dashboards mitbringen.
Real User Monitoring und Session Replay
Über Backend-Signale hinaus erfasst OpenObserve Real-User-Monitoring-Daten aus Web-, Android- und iOS-Apps. Session Replay zeigt, was ein Nutzer tatsächlich tat, bevor er auf einen Fehler stieß, was oft Fragen beantwortet, die Logzeilen nicht klären. Frontend- und Backend-Kontext leben im selben Tool.
KI- und LLM-Observability
Die Plattform verfolgt das Verhalten von KI-Agenten und LLMs als Signal erster Klasse, einschließlich Prompt-Flows und Token-Nutzung. Da mehr Produkte Modelle einbetten, bekommen Teams so einen Weg, Kosten und Qualität von KI-Funktionen neben allem anderen zu beobachten. Ein KI-Assistent hilft zudem beim Zusammenfassen und Troubleshooting in der Oberfläche.
Alarme, Dashboards und SLOs
Dashboards, Alarmierung und Service-Level-Objectives sind im Kernprodukt enthalten. Sie definieren, wie gut aussehen soll, und die Plattform sagt Ihnen, wenn die Realität abweicht. Alarme laufen über dieselben Daten, die Sie abfragen, also bleiben Schwellenwerte konsistent mit Ihren Untersuchungen.
Vor- und Nachteile
Vorteile
- Preise pro GB ohne Kosten pro Host oder pro Nutzer halten die Kosten berechenbar, während Teams wachsen
- Das Single-Binary-Deployment startet eine lauffähige Instanz in unter zwei Minuten
- Der OpenTelemetry-native, quelloffene Kern (AGPL-3.0) verringert Anbieterbindung
- Vereinheitlichte Logs, Metriken, Traces, RUM und LLM-Observability sparen Kontextwechsel zwischen Tools
- SQL- und PromQL-Unterstützung heißt, dass die meisten Engineers die Abfragesyntax schon kennen
Nachteile
- Selbsthosting im großen Maßstab erfordert echte Infrastrukturarbeit, also landen kleine Teams am Ende doch auf bezahlten Cloud-Stufen
- Die KI- und LLM-Observability-Funktionen sind neuer als die Kernsignale, rechnen Sie dort also mit weniger Feinschliff
- Community-Support ersetzt dedizierte Konto-Betreuung, außer Sie sind auf einem Enterprise-Tarif
- Feine Kostenkontrolle hängt vom Management des Erfassungsvolumens ab, was fortlaufende Aufmerksamkeit erfordert
Häufige Fragen
Es sammelt und analysiert die Betriebsdaten, die Ihre Software erzeugt: Logs, Metriken und Traces, dazu Frontend- und LLM-Signale. Teams nutzen es, um Incidents zu debuggen, Performance zu überwachen und die Kosten für die Speicherung von Telemetrie zu senken. Es läuft als selbst gehostete Open-Source-Installation oder als gemanagter Cloud-Dienst.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu OpenObserve.
Alternativen zu OpenObserve
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.