
Parallax by Gradient
Gradient · Sonstiges
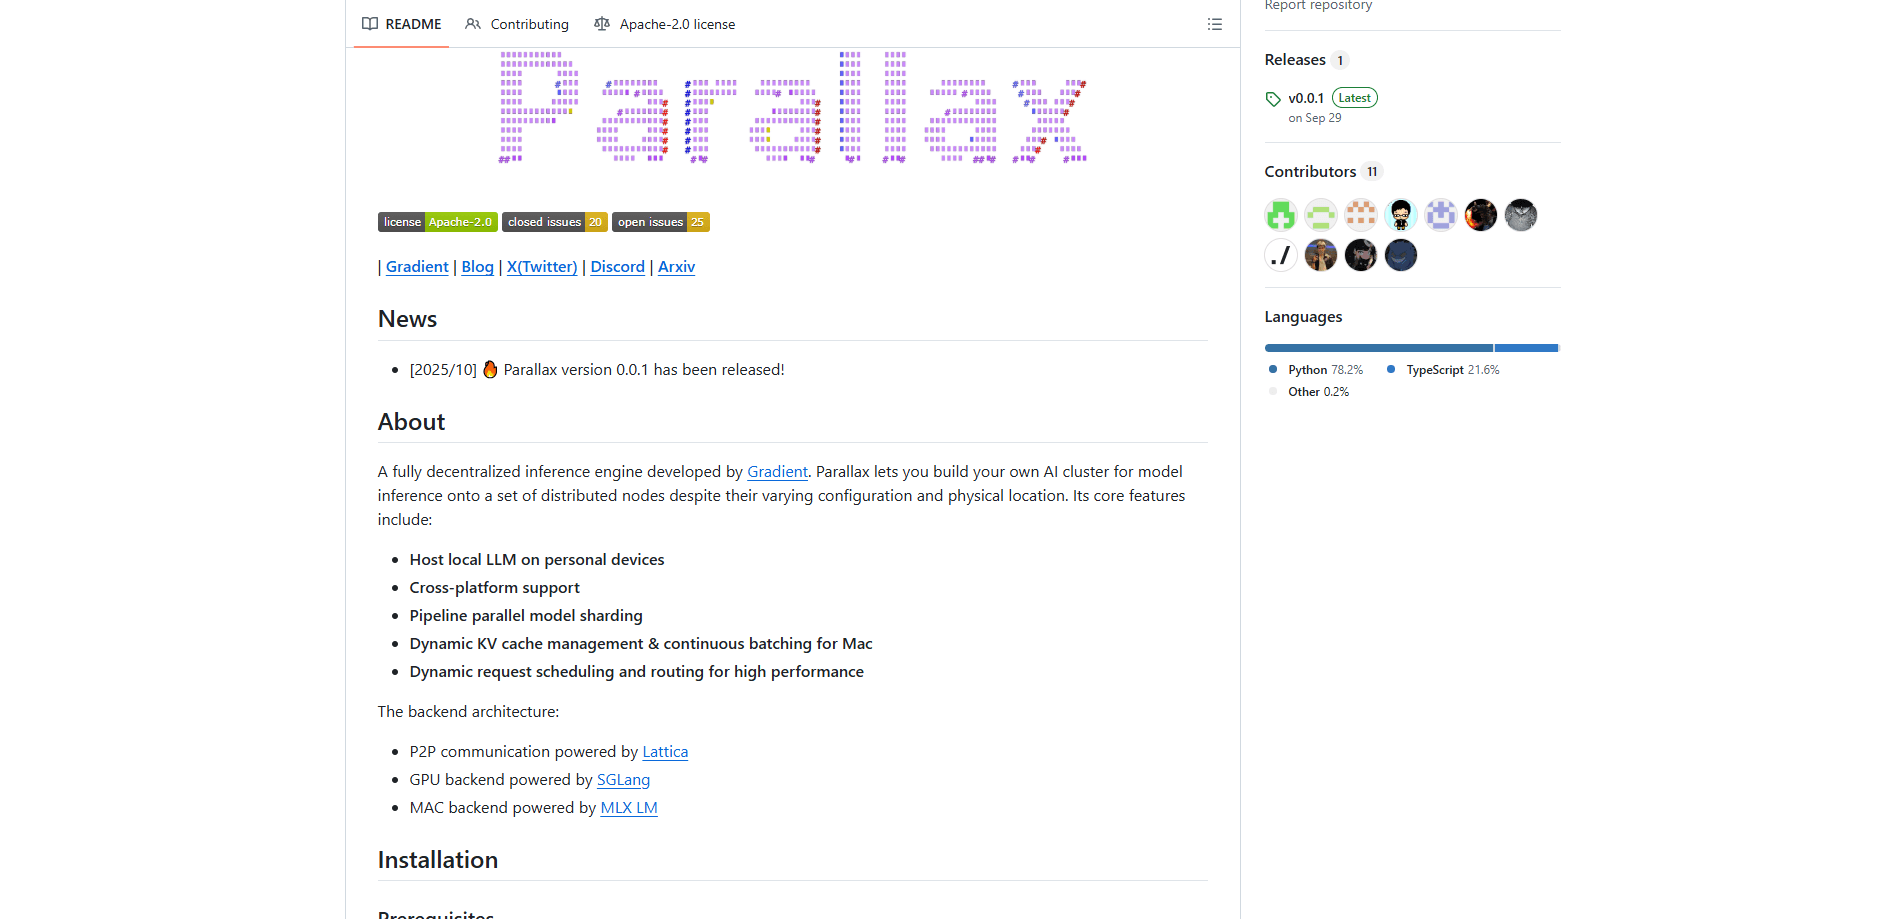
Parallax by Gradient ist eine vollständig dezentrale Inferenz-Engine, mit der Sie Ihren eigenen KI-Cluster aufbauen und große Sprachmodelle über mehrere Geräte hinweg ausführen, egal wie unterschiedlich deren Hardware ist oder wo sie physisch stehen. Statt Cloud-GPUs zu mieten, bündeln Sie die Maschinen, die Sie ohnehin besitzen, und bedienen Modelle wie Qwen, DeepSeek und GLM über einen einzigen lokalen Endpunkt.
Über Parallax by Gradient
Was ist Parallax by Gradient
Parallax ist ein quelloffenes Framework für verteilte KI-Cluster, entwickelt von Gradient. Es teilt ein großes Sprachmodell auf mehrere Maschinen auf und führt die Inferenz gemeinsam darauf aus, sodass ein Laptop, ein Desktop mit GPU und ein kleiner Server am anderen Ende Ihres Heimnetzwerks wie eine einzige größere Maschine wirken. Das Ganze spricht ein Peer-to-Peer-Protokoll, was bedeutet, dass kein zentraler Server dauerhaft online bleiben muss. Das ist das Versprechen.
Das Problem, das es löst, ist leicht zu benennen und mühsam zu erleben. Ein leistungsfähiges LLM auszuführen heißt normalerweise entweder, pro Token an einen Cloud-Anbieter zu zahlen, oder eine sehr teure GPU zu kaufen, in die das gesamte Modell passt. Parallax nimmt einen dritten Weg. Es zerlegt das Modell Schicht für Schicht und leitet Anfragen über die Hardware, die Sie haben, sodass Sie mehr aus den Geräten herausholen, die ohnehin auf Ihrem Schreibtisch stehen. Ihre Prompts und Ausgaben bleiben auf Ihren eigenen Maschinen, was zählt, wenn Sie Dinge verarbeiten, die Sie lieber nicht an Dritte senden.
Die wichtigste Einschränkung: Das ist ein Entwicklerwerkzeug, keine App zum Installieren per Klick. Sie sollten sich im Terminal wohlfühlen, und unter Linux werden Sie mit Docker zu tun haben oder GPU-Treiber einrichten. Das Projekt ist außerdem jung. Version 0.0.1 erschien im Oktober 2025, daher sind raue Kanten zu erwarten und die Modellunterstützung ändert sich laufend. Wer etwas will, das ohne jede Einrichtung sofort funktioniert, ist mit einer gehosteten API besser bedient.
Erste Schritte
- Installieren Sie den Client, indem Sie das Repository klonen und
./install.shausführen, was eine virtuelle Python-Umgebung einrichtet und die nötigen Binärdateien baut. Windows-Nutzer können stattdessen einen eigenständigen Installer verwenden. - Aktivieren Sie die Umgebung mit
source .venv/bin/activateund prüfen Sie, ob die Extras für Ihre Hardware erkannt wurden, da GPU-Builds für macOS und Linux unterschiedliche Backend-Komponenten installieren. - Starten Sie den lokalen Knoten mit einem Befehl wie
parallax serve -m Qwen/Qwen3.5-0.8Bund wählen Sie ein Modell, das in Ihren kombinierten Speicher passt. - Fügen Sie demselben Cluster weitere Maschinen hinzu, damit die Modell-Fragmente alle von Ihnen ergänzten Geräte umfassen.
- Richten Sie Ihre App oder Ihr Skript auf den lokalen Endpunkt und senden Sie Anfragen wie an jede OpenAI-kompatible API.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Parallax by Gradient.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler, die schon ein paar Maschinen besitzen und selbst gehostete LLM-Workloads ohne Cloud-Rechnungen betreiben wollen, sofern sie gern im Terminal arbeiten.
- Datenschutzbewusste Teams, die mit sensiblen Texten umgehen und die Inferenz lieber auf lokaler Hardware halten, als Prompts an eine gehostete API zu senden.
- Hobbyisten, die sich für verteilte KI-Cluster interessieren und einen Nachmittag in die Konfiguration investieren möchten.
Aufgaben
- Einen geteilten LLM-Endpunkt für ein Heimlabor oder ein kleines Büro hosten, in dem mehrere Leute ihre Werkzeuge auf einen lokalen Server richten.
- Offene Modelle wie Qwen, DeepSeek oder GLM auf echter Hardware testen und vergleichen, statt für jeden Benchmark-Durchlauf zu zahlen.
- Agenten und interne Werkzeuge bauen, die ein lokales KI-Inferenz-Backend brauchen, ohne Anbieterbindung oder Nutzungslimit.
Szenarien
- Ein Wochenendprojekt, um aus einem Laptop plus einem übrigen Desktop mit GPU ein größeres Modell herauszuholen.
- Einen Coding-Assistenten auf den Büromaschinen laufen lassen, damit kein Quellcode das Gebäude verlässt.
- Mit Modell-Sharding per Pipeline-Parallelismus ausprobieren, wie weit gebündelte Verbraucherhardware kommt.
- Alle, die ein LLM lokal über ein paar gemischte Maschinen ausführen und die Cloud komplett überspringen möchten.
Wichtigste Funktionen
Verteiltes Modell-Sharding
Parallax teilt ein Modell mithilfe von Pipeline-Parallelismus auf Geräte auf, sodass jede Maschine nur einen Ausschnitt des Netzwerks hält statt das Ganze. Das ermöglicht es Hardware mit sehr unterschiedlichen Spezifikationen, an einem Modell zusammenzuarbeiten. Sie können den Cluster durch zusätzliche Knoten erweitern, und das Framework passt die Aufteilung der Arbeit an.
Hardwareunabhängiger Cluster
Die Engine verlangt keine identischen Maschinen. Sie löst den kniffligen Teil, Anfragen über Knoten mit unterschiedlicher Konfiguration und physischem Standort zu leiten, was genau der Sinn eines dezentralen Aufbaus ist. Ein Mac, eine Linux-Maschine mit GPU und ein Windows-Rechner können alle am selben Cluster teilnehmen.
Peer-to-Peer-Kommunikation
Knoten sprechen über Lattica miteinander, eine P2P-Schicht, also gibt es keinen einzelnen Ausfallpunkt im Netzwerk. Fällt ein Knoten aus, bricht der Cluster nicht mit ihm zusammen. Dieses Design macht aus dem Betrieb des Clusters „überall" mehr als eine Marketingzeile.
Plattformübergreifende Unterstützung
Sie können Parallax auf Windows, Linux und macOS installieren. Das GPU-Backend stützt sich auf SGLang und vLLM, während Macs über MLX LM laufen. Die Installationswege unterscheiden sich je nach System, und das Projekt liefert einen Windows-Installer plus Docker-Images für GPU-Maschinen. Der Gewinn ist echtes plattformübergreifendes LLM-Hosting: ein Cluster, mehrere Betriebssysteme, keine Codeänderungen.
Optimierte Anfragenverarbeitung
Auf dem Mac ergänzt Parallax eine paginierte KV-Cache-Verwaltung und kontinuierliches Batching, Techniken, die den Speicherverbrauch im Zaum halten, während viele Anfragen bedient werden. Die Anfragenplanung passt sich laufend an, um zu entscheiden, welcher Knoten was übernimmt, mit dem Ziel, den Durchsatz im gesamten Cluster hoch zu halten.
OpenAI-kompatibles Serving
Sobald ein Knoten läuft, stellt er einen Endpunkt bereit, den Ihre bestehenden Werkzeuge fast wie eine gehostete API aufrufen können. Apps, Skripte und Agenten, die Sie bereits gebaut haben, müssen also nicht neu geschrieben werden. Das Projekt dokumentiert außerdem einen Integrationsweg für OpenClaw.
Vor- und Nachteile
Vorteile
- Kostenlos und quelloffen, also keine Rechnung pro Token, und Sie können genau nachlesen, wie die Inferenz funktioniert.
- Verwandelt Hardware, die Sie bereits besitzen, in einen funktionierenden LLM-Cluster, auch bei ungleichen Maschinen.
- Hält Prompts und Ausgaben auf Ihren eigenen Geräten, was Datenschutz und Compliance unterstützt.
- Die plattformübergreifende Unterstützung erlaubt es, ein Deployment zwischen Macs und Linux-GPU-Maschinen zu teilen.
- Die P2P-Architektur vermeidet einen zentralen Server, also gibt es keinen einzelnen Ausfallpunkt.
Nachteile
- Die Einrichtung ist Entwicklersache. Es ist keine Ein-Klick-App, und GPU-Installationen unter Linux können Docker oder Treiberarbeit bedeuten.
- Das Projekt steckt in einer frühen Phase. Rechnen Sie mit wechselnder Modellunterstützung und gelegentlichen Fehlern.
- Die Leistung hängt ganz von Ihrer Hardware ab; gebündelte Verbrauchergeräte erreichen keinen Cloud-GPU-Cluster.
- Die Dokumentation wächst noch, daher bedeutet die eine oder andere Fehlersuche, das Repository zu lesen oder auf Discord zu fragen.
Häufige Fragen
Ja. Parallax by Gradient ist quelloffen und kostenlos, ohne Abo. Sie zahlen nur den Strom und die Hardware, auf der Sie es ohnehin betreiben. Es gibt keine bezahlte Stufe, der Preis von „$0" deckt also das ganze Produkt ab.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Parallax by Gradient.
Alternativen zu Parallax by Gradient

Odyssey 3
Odyssey · SonstigesOdyssey-3 ist Odysseys fundamentales Weltmodell. Es simuliert Physik in Echtzeit, macht aus einer Eingabe eine interaktive Umgebung und lässt sich an Roboter, Autos und Spiele anpassen.

JarvisCore
Prescott Data · Coding · Produktivität · SonstigesJarvisCore ist eine Open-Source-Laufzeit in Python, in der KI-Agenten als gleichrangige Peers in einem Mesh arbeiten, Aufgaben aus einem gemeinsamen Register übernehmen und externe Dienste über einen Zero-Trust-Broker erreichen.
Clef
Cloudflare · Business · SonstigesClef ist Cloudflares Open-Source-Entscheidungsmodell für Workers AI. Es liefert kalibrierte Wahrscheinlichkeiten für typisierte Fragen statt Text, damit Agenten schnell klassifizieren, routen und handeln.