
PDFMerse
PDFMerse · Coding · Produktivität
PDFMerse ist ein KI-Tool, das Daten aus jedem PDF extrahiert und in strukturierte Daten wie JSON oder CSV umwandelt, gedacht für Teams, die Dokumente in nutzbare Zeilen verwandeln müssen.
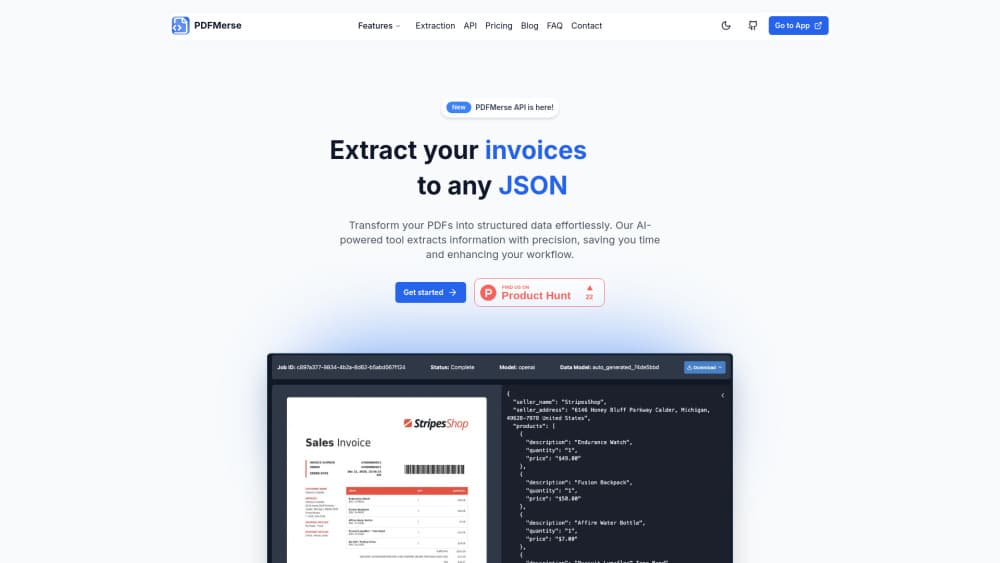
Über PDFMerse
Was ist PDFMerse
PDFMerse ist ein KI-gestütztes Tool zur Extraktion von PDF-Daten. Sie geben ihm ein Dokument, es liest das Layout wie ein Mensch und liefert strukturierte Daten zurück, die Sie sortieren, filtern oder in eine Datenbank laden können. Das Versprechen ist einfach: Schluss damit, Zahlen aus Rechnungen, Berichten und Auszügen per Hand abzuschreiben. Das ist die ganze Idee.
Viele Leute suchen zuerst nach einem Weg, Daten aus PDF-Dateien zu extrahieren, wenn der manuelle Weg sie endgültig zermürbt hat. PDFMerse bedient genau dieses Bedürfnis.
Das Tool zielt auf einen konkreten Schmerz. Die meisten PDFs sind fürs Drucken gebaut, nicht fürs Auslesen. Text steht in seltsamen Spalten, Tabellen brechen über Seiten hinweg und eingescannte Seiten sind wirklich nur Bilder. Mit einem normalen Konverter Daten aus diesen Dateien zu holen, lässt Ihnen einen Haufen verstümmelten Text, der vor der Nutzung noch Stunden Reinigung braucht. PDFMerse behandelt die Extraktion zuerst als Verständnisproblem, deshalb behält die Ausgabe ihre Struktur.
Der Haken: Kein Extraktionstool ist perfekt, und PDFMerse tut nicht so, als wäre es anders. Die Genauigkeit hängt davon ab, wie sauber Ihre Quelldateien sind. Eine klare digitale Rechnung liest sich weit besser aus als das schiefe Handyfoto eines Kassenbons. Wenn Sie auf jeder Seite 100 % Genauigkeit erwarten, werden Sie enttäuscht. Planen Sie Stichproben der Ausgabe ein, besonders beim ersten Durchlauf mit einem neuen Dokumenttyp.
Erste Schritte
- Erstellen Sie ein Konto auf der PDFMerse-Website und melden Sie sich in Ihrem Dashboard an.
- Laden Sie ein PDF hoch oder verbinden Sie die Quelle, aus der Ihre Dokumente kommen.
- Legen Sie die Felder fest, die Sie zurückbekommen wollen, etwa Rechnungsnummer, Datum, Gesamtbetrag oder Anbieter.
- Starten Sie die Extraktion und lassen Sie die KI jede Seite lesen.
- Prüfen Sie die strukturierte Ausgabe und exportieren Sie sie als JSON oder CSV für Ihre Tabellenkalkulation, Datenbank oder API.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von PDFMerse.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Finanz- und Buchhaltungsteams
- Personal in Betrieb und Verwaltung
- Daten- und Betriebsingenieure
Aufgaben
- Extraktion von Rechnungsdaten
- Digitalisierung von Berichten
- Formularverarbeitung
Szenarien
- Buchhaltung zum Monatsende
- Forschung und Umfragen
- Migration von Papierakten
Wichtigste Funktionen
PDF in strukturierte Daten
Die Kernaufgabe ist, ein PDF in strukturierte Daten zu verwandeln, die Sie anderswo nutzen können. PDFMerse liest das Dokument, erkennt die Felder, die Ihnen wichtig sind, und gibt sie in einem geordneten Format zurück statt als Textwand. Der Unterschied zählt, wenn Sie das Ergebnis in eine Tabelle oder Datenbank einspeisen, wo eine saubere Spalte jeden Tag ein Copy-Paste schlägt.
Benutzerdefinierte Felddefinition
Sie entscheiden, was extrahiert wird. Statt zu hoffen, dass das Tool richtig rät, legen Sie die gewünschten Feldnamen fest, etwa Rechnungsnummer, Fälligkeitsdatum oder Gesamtbetrag. So bleibt die Ausgabe auf das System abgestimmt, in das Sie laden, und Sie verbringen weniger Zeit damit, die Daten hinterher umzuformen.
JSON- und CSV-Export
Extrahierte Daten kommen in Formaten heraus, die Ihre anderen Tools schon sprechen. Wollen Sie PDF in JSON für einen Entwickler-Workflow? Erledigt. Brauchen Sie PDF in CSV für eine Tabelle? Geht auch. JSON passt zu Entwicklern und API-Workflows, während CSV direkt in Excel oder Google Sheets landet für alle, die in Tabellen leben. Beides zu haben erspart einen Konvertierungsschritt dazwischen.
Umgang mit komplexen Layouts
Echte PDFs sind nicht ordentlich. Tabellen laufen über Seiten, Spalten stehen nebeneinander und Kopfzeilen wiederholen sich. Was passiert also, wenn eine Tabelle über drei Seiten bricht, mit einer wiederholten Kopfzeile, die Sie nicht zweimal kopiert haben wollen? Die KI ist darauf ausgelegt, solche Layouts in sinnvoller Reihenfolge zu lesen, statt Text nach Position zu greifen und zu verhunzen. Genau da trennt sich ein nützliches Extraktionstool von einem reinen Textauswurf.
Genauigkeit bei unordentlichen Dokumenten
Dokumente sind sehr unterschiedlich, und die Extraktion soll über diese Bandbreite halten. Eine gut geformte digitale Datei wird sauber extrahiert; eine eingescannte Seite oder eine schlechte Aufnahme ist schwieriger und braucht vielleicht einen zweiten Blick. Ein sauberer Scan einer Standardrechnung von einem bekannten Anbieter kommt meist fast perfekt zurück, während ein zerknitterter Beleg, mit einem alten Handy bei schlechtem Licht fotografiert, sowohl das Modell als auch Ihre Geduld prüft. Zu wissen, in welche Gruppe Ihre Dateien fallen, sagt Ihnen, wie viel Prüfung Sie einplanen sollten.
Stapelverarbeitung von Dokumenten
Wenn Sie mehr als eine Datei durcharbeiten, spart die Stapelverarbeitung echte Zeit. Es geht nicht um eine einzelne perfekte Extraktion, sondern darum, eine Warteschlange von Rechnungen oder Formularen in einem Durchgang abzuarbeiten. Hier verdient ein PDF-Datenextraktor sein Geld gegenüber derselben Arbeit per Hand. Geben Sie ihm fünfzig Auszüge und gehen Sie weg. Sie kommen zu einer Tabelle zurück.
Vor- und Nachteile
Vorteile
- Verwandelt PDFs in strukturiertes JSON oder CSV, statt Ihnen Rohtext zu hinterlassen.
- Benutzerdefinierte Felddefinitionen halten die Ausgabe auf Ihren Workflow zugeschnitten.
- Liest komplexe Layouts, darunter mehrspaltige Seiten und Tabellen.
- Kommt mit eingescannten und unvollkommenen Dokumenten einigermaßen zurecht.
- Reduziert das manuelle Tippen bei wiederkehrenden Dokumenten wie Rechnungen und Formularen.
Nachteile
- Die Genauigkeit sinkt bei schlechten Scans, solche Ergebnisse müssen Sie also prüfen.
- Nur im Browser, ohne Desktop-App oder mobile Version für die Offline-Nutzung.
- Genaue Preise und Tarifstufen können sich ändern, prüfen Sie die aktuellen Details auf der offiziellen Website, bevor Sie sich festlegen.
- Öffentliche Angaben zum API-Zugang sind dünn, was ein Problem ist, wenn Sie im großen Stil automatisieren wollen.
Häufige Fragen
Es extrahiert Daten aus PDF-Dokumenten und gibt sie als strukturierte Ausgabe wie JSON oder CSV zurück. Sie laden eine Datei hoch, sagen ihm, welche Felder Sie wollen, und es liest das Dokument, um diese Werte herauszuziehen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu PDFMerse.
Alternativen zu PDFMerse
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.