
Plexe
Plexe · Coding
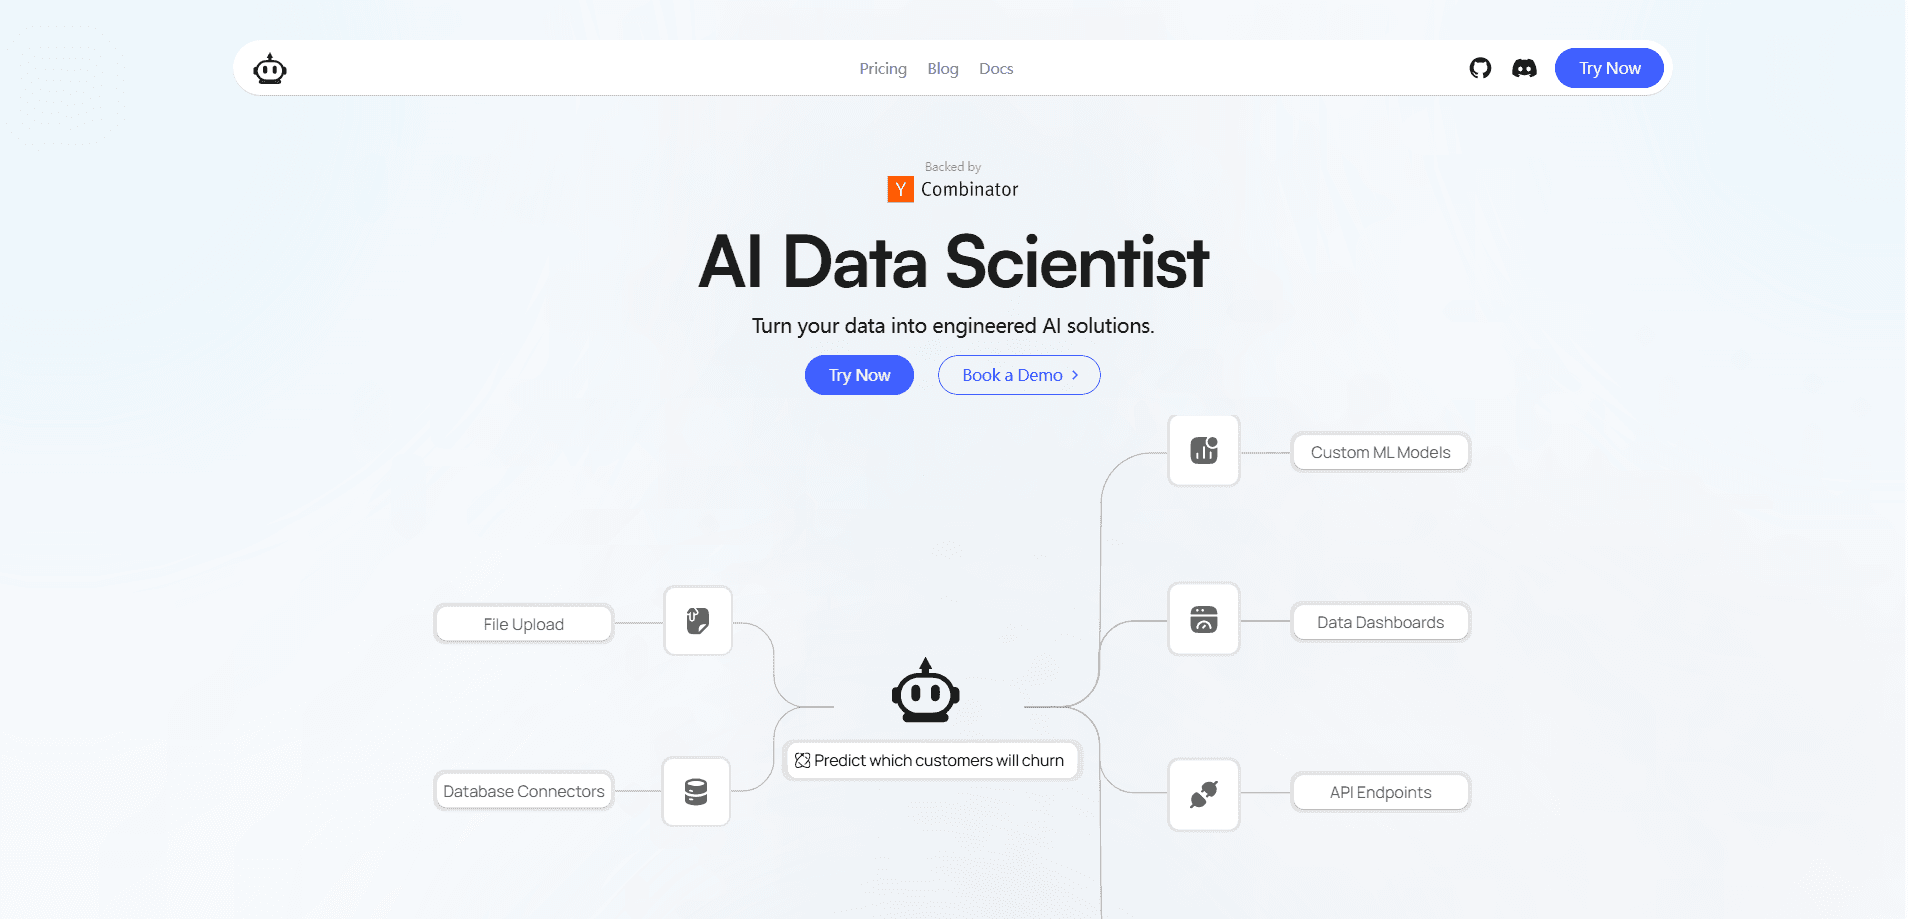
Plexe ist eine Open-Source-AutoML-Plattform, mit der man ML-Modelle aus natürlicher Sprache erstellen kann. Man sagt in einfachen Worten, was man will, und der Agent erledigt den Rest. Statt Trainingscode von Hand zu schreiben, gibt man dem Agenten einen Datensatz und ein Ziel, und er kümmert sich um Datenvorbereitung, Codegenerierung, Training und Deployment. Teams nutzen es als ihren KI-Modell-Generator, um prädiktive Ergebnisse in Wochen statt in Quartalen zu liefern, ohne einen eigenen ML-Ingenieur im Team.
Über Plexe
Was ist Plexe
Plexe ist ein agentengesteuertes Werkzeug für alle, die funktionierende Machine-Learning-Modelle brauchen, aber nicht Monate mit dem Erlernen der Toolchain verbringen wollen. Es ist zugleich ein freundlicher Einstieg für Anfänger. Man verbindet einen Datensatz, beschreibt die gewünschte Vorhersage, und ein Multi-Agenten-System plant den Ansatz, generiert den Trainingscode, führt ihn aus und verbessert das Ergebnis, bis es überzeugt. Es baut auf gängigen Bibliotheken wie scikit-learn, PyTorch und TensorFlow auf, weshalb die Ausgabe lesbar bleibt und sich leicht an einen Ingenieur weitergeben lässt, der mehr daraus machen will.
Das Hauptproblem, das es löst, ist die Lücke zwischen dem Besitz von Daten und einem einsatzbereiten Modell. Herkömmliche Abläufe bleiben bei Feature Engineering, Framework-Auswahl und Infrastruktur hängen, und jeder dieser Schritte kann Tage verschlingen, bevor jemand eine einzige Vorhersage sieht. Plexe fasst diese Schritte in einer einzigen Schleife zusammen und hält jede Zeile des generierten Codes sichtbar, sodass man ihn prüfen, ändern oder später den eigenen Ingenieuren übergeben kann.
Die größte Einschränkung ist, dass man trotzdem brauchbare Daten und ein klares Ziel braucht. Ein vager Befehl über einen unordentlichen Datensatz erzeugt kein nützliches prädiktives Modell, so gut der Agent auch sein mag. Außerdem ist es ein Produkt in einer frühen Phase. Rechnen Sie bei sehr großen oder ungewöhnlichen Problemtypen mit rauen Kanten.
Für Teams ohne eigenen ML-Spezialisten arbeitet Plexe als Werkzeug für prädiktive Modelle, das die schwere Arbeit übernimmt, aber es rettet kein Projekt, in dem die Daten selbst das eigentliche Problem sind.
Erste Schritte
- Installieren Sie die Open-Source-Bibliothek mit
pip install plexeoder melden Sie sich auf der gehosteten Plattform unter console.plexe.ai an, wenn Sie den Infrastruktur-Aufbau lieber überspringen. - Verbinden Sie einen Datensatz als Pandas DataFrame (Bibliothek) oder laden Sie ihn über die Oberfläche und die API der Plattform hoch.
- Beschreiben Sie Ihr Ziel in natürlicher Sprache und definieren Sie optional Eingabe- und Ausgabeschemata, damit das Modell genau weiß, was es erwarten soll.
- Richten Sie Plexe auf Ihren bevorzugten LLM-Anbieter, damit das Agentensystem planen und Code generieren kann.
- Lassen Sie den Agenten das Modell bauen und bewerten und exportieren Sie es dann für die Inferenz oder setzen Sie es in Ihr eigenes Produkt ein.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Plexe.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler und Datenwissenschaftler, die Boilerplate-Trainingscode überspringen und schneller zu einem funktionierenden Modell kommen wollen.
- Produktteams und Analysten, die Vorhersagen in einer App brauchen, aber keinen eigenen ML-Ingenieur haben.
- Gründer in frühen Experimenten, die eine Modellierungsidee testen wollen, bevor sie echte Ressourcen binden.
Aufgaben
- Tabellarische prädiktive Modelle wie Abwanderungswerte, Preisprognosen oder Lead-Scoring aus einem vorhandenen Datensatz erstellen.
- Eine Klassifikations- oder Regressionsidee schnell prototypisieren, um zu sehen, ob die Daten sie überhaupt tragen.
- Sauberen, dokumentierten Trainingscode erzeugen, den Sie prüfen und an Ihr eigenes Engineering-Team übergeben können. Schluss mit rätselhaften Skripten.
Szenarien
- Ein kleines Startup mit einer Tabelle voller Kundendaten, das ein Abwanderungsmodell will, ohne einen ML-Spezialisten einzustellen.
- Ein internes Tool-Team, das bis zum nächsten Sprint einen leichten Vorhersage-Endpunkt braucht, der in ein Produkt eingebunden ist.
- Frühe Forschung, in der Sie mehrere Ansätze an einem Nachmittag statt in einer Woche vergleichen wollen. Schnelle Ergebnisse. Geringes Risiko.
Wichtigste Funktionen
Modellerstellung mit natürlicher Sprache
Sie beschreiben das gewünschte Ergebnis in einfachen Worten, und das Agentensystem von Plexe erarbeitet die Modellierungsstrategie. Keine Algorithmen auszuwählen. Keine Trainingsschleifen zu schreiben. Der Agent liest Ihre Absicht und Ihre Daten und arbeitet darauf hin.
Multi-Agenten-Pipeline
Unter der Haube übernimmt eine Abfolge von Agenten Planung, Codegenerierung, Ausführung und Verfeinerung. Jede Stufe speist die nächste, und das System iteriert über die Ergebnisse, bis die Leistung nicht mehr besser wird. Sie erhalten ein funktionierendes Modell, ohne die meisten Interna anzufassen. In dieser Schleife liegt die Zeitersparnis.
Open-Source-Python-Bibliothek
Die Bibliothek plexe wird mit einem einzigen pip-Befehl installiert und fügt sich direkt in vorhandenen Python-Code ein. Sie kontrollieren Ihre eigene Rechenleistung und Ihre Daten und bringen die Zugangsdaten Ihres LLM-Anbieters mit. Das ist der Weg für Teams, die maximale Kontrolle wollen. So einfach ist das.
Verwaltete gehostete Plattform
Wenn Sie keine Infrastruktur verwalten möchten, bietet die gehostete Plattform unter console.plexe.ai eine Weboberfläche und eine REST API mit integrierter Skalierung und vereinfachter Abrechnung. Sie passt zu Produktteams, die ML auf Enterprise-Niveau ohne den Betriebsaufwand wollen, und sie bedeutet, dass Sie von einer Idee zu einem aktiven Endpunkt gelangen, ohne selbst einen einzigen Server bereitzustellen.
Kontrolle über Schemata und Datensätze
Sie können erwartete Ein- und Ausgaben mit Pydantic-Modellen oder einfachen Dictionaries definieren und Trainingsdaten über Pandas DataFrames oder einen Datensatz-Generator zuführen. Enge Schemata halten das generierte Modell auf das ausgerichtet, was Ihre Anwendung wirklich braucht. Diese Ausrichtung ist wichtiger, als viele annehmen.
Volle Code-Transparenz
Jedes Modell, das Plexe erzeugt, ist sauber, dokumentiert und lesbar. Sie können den generierten Code öffnen, verstehen und anpassen. Nichts versteckt sich hinter einer Blackbox, was zählt, wenn ein Modell eine interne Prüfung bestehen muss.
Deployment und Inferenz
Plexe paketiert das trainierte Modell für die Inferenz oder setzt es in Ihrer Produktionsinfrastruktur ein. Modelle lassen sich auf der Festplatte speichern und später wieder laden, sodass Sie nicht jedes Mal neu bauen müssen. Das macht aus einem Prototyp etwas, das Sie wirklich ausliefern können.
Vor- und Nachteile
Vorteile
- Die Eingabe in natürlicher Sprache nimmt den steilsten Teil der ML-Lernkurve heraus, sodass auch Nicht-Spezialisten echte Modelle erstellen können.
- Der Open-Source-Kern bedeutet, dass der Code Ihnen gehört und Sie alles prüfen oder ändern können, was der Agent generiert.
- Zwei Deployment-Wege (Python-Bibliothek und verwaltete Plattform) lassen Sie Kontrolle gegen Bequemlichkeit tauschen.
- Unterstützt gängige Frameworks, sodass die Ausgabe zu den Werkzeugen passt, die Ihr Team bereits nutzt.
Nachteile
- Die Preise der gehosteten Plattform sind nicht veröffentlicht, sodass Sie das Team für Enterprise-Angebote kontaktieren müssen. Ärgerlich, wenn Sie jetzt eine Zahl wollen.
- Die Ergebnisse hängen stark von der Datenqualität ab; unordentliche Eingaben erzeugen weiterhin schwache Modelle, und das behebt es nicht für Sie.
- Es ist ein Produkt in einer frühen Phase, daher können Nischen- oder besonders komplexe Probleme auf raue Kanten stoßen.
Häufige Fragen
Es erstellt Machine-Learning-Modelle aus Beschreibungen in natürlicher Sprache. Sie liefern Daten und ein Ziel, und sein Agentensystem plant, schreibt, trainiert und setzt das Modell für Sie ein. Das ist das ganze Produkt in einem Satz.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Plexe.
Alternativen zu Plexe
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.