
Plurai
Plurai · Coding
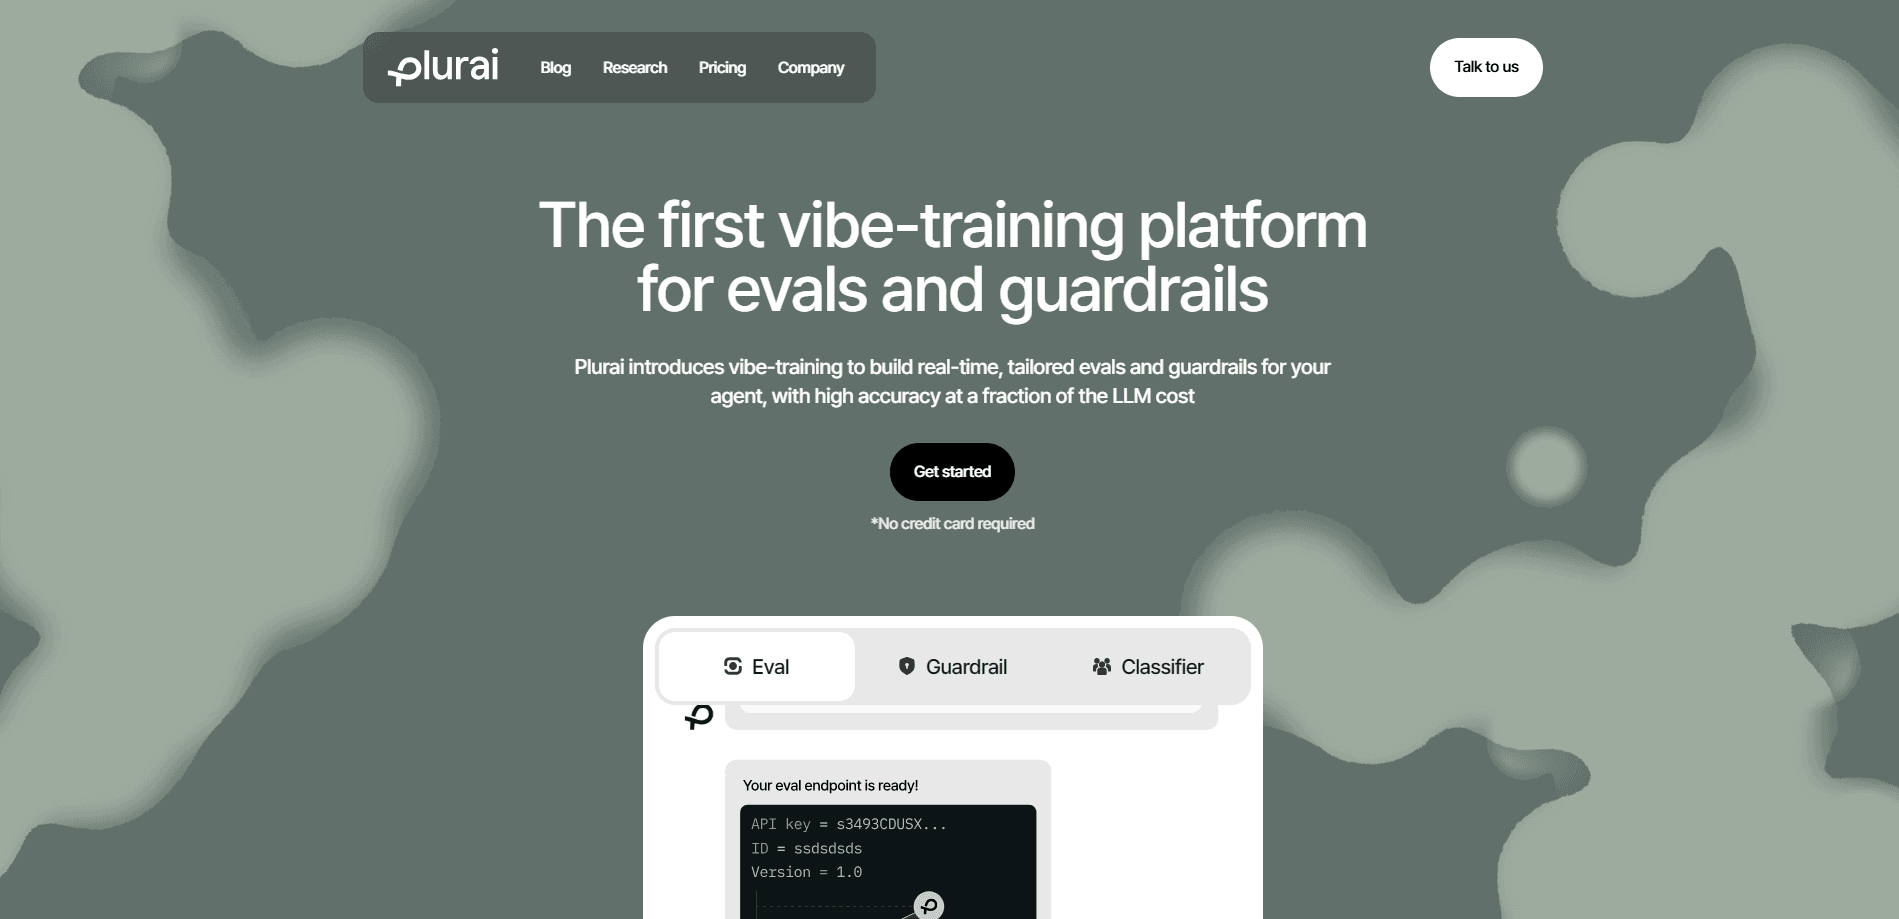
Plurai ist eine Vibe-Training-Plattform für Teams, die KI-Agenten bauen und Belege brauchen, dass diese Agenten in der echten Welt funktionieren. Sie kombiniert automatisierte Simulation, hochpräzise Evals und Echtzeit-Guardrails und lässt sie auf maßgeschneiderten kleinen Sprachmodellen laufen, die einen Bruchteil eines generalistischen LLM-Judges kosten. Das ist das Versprechen. Wenn Ihr Team einen Agenten ausliefert und nicht sagen kann, wie oft er scheitert, ist Plurai gebaut, um diese Frage zu beantworten, bevor es Ihre Nutzer tun.
Über Plurai
Was ist Plurai
Plurai ist eine Plattform für KI-Evaluierung und Guardrails. Sie erzeugt einen Testsatz für Ihren Agenten, vergleicht die Ausgaben mit dem, was Sie tatsächlich wollen, und beobachtet danach den Live-Verkehr weiter, damit schlechte Antworten abgefangen werden, bevor sie einen Kunden erreichen. Das Versprechen ist einfach. Hören Sie auf zu raten, ob Ihr Agent funktioniert.
Die meisten Teams starten mit einem generalistischen LLM als Judge. Das funktioniert für eine Demo. Dann bricht es bei Produktionsmaßstab, wo jede Konversation mit einem großen Modell zu bewerten schnell teuer und langsam wird. Plurais Antwort ist ein proprietärer Prozess zur Intent-Kalibrierung, der Ihre konkrete Aufgabe lernt und einen darauf abgestimmten Evaluator erzeugt. Vorab beschriftete Daten sind nicht nötig. Wenn Sie keine historischen Datensätze haben, erzeugt er synthetische Daten, zugeschnitten auf Ihren Anwendungsfall.
Der Kompromiss: Das ist Infrastruktur, keine Consumer-App. Es gibt einen kostenlosen Tarif zum Ausprobieren, aber der ernsthafte Einsatz richtet sich an Engineering-Teams, die eine API in ihre Pipeline einbinden können. Sie können das Ganze nicht beurteilen, ohne zuerst gegen Ihren eigenen Agenten zu testen. Der Wert zeigt sich also nach dem Setup, nicht in einem Fünf-Minuten-Test.
Erste Schritte
- Registrieren Sie sich und nehmen Sie den kostenlosen Tarif, der 1M kostenlose Tokens und einen dedizierten persönlichen Endpunkt enthält, damit Sie eine erste Eval ohne Kreditkarte laufen lassen können.
- Richten Sie Plurai auf die Aufgabe Ihres Agenten und lassen Sie die Intent-Kalibrierung einen synthetischen Testsatz erzeugen, den Sie herunterladen und prüfen können.
- Führen Sie die Eval aus, um die Genauigkeit zu sehen, und passen Sie dann Ihre Prompts oder die Agenten-Logik dort an, wo er scheitert.
- Bringen Sie den Evaluator als Echtzeit-Guardrail in die Produktion, entweder über die gehostete API oder in Ihrem eigenen VPC, für geringere Latenz und strengere Datenkontrolle.
- Skalieren Sie Endpunkte und Modelle, während die Abdeckung wächst, oder wechseln Sie zu Enterprise für On-Prem-Deployment und SSO.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Plurai.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Engineering-Teams
- QA- und Produktverantwortliche in KI-Startups
- Sicherheitsbewusste Unternehmen
Aufgaben
- Evals für KI-Agenten auf Produktionsniveau über Agenten-Konversationen laufen lassen
- Echtzeit-Guardrails einrichten
- Einen Agenten-Simulationstestsatz von Grund auf bauen
- Judge-Modelle nach Kosten vergleichen
Szenarien
- Validierung vor dem Launch eines Kundensupport-Agenten
- Laufende Überwachung nach dem Launch
- Offline-Experimente auf Stichprobendaten
Wichtigste Funktionen
Automatisierte Simulation und synthetische Daten
Plurai erzeugt hyperrealistische Szenarien, Personas und Artefakte rund um Ihr konkretes Produkt, sodass die Agenten-Simulation wie Ihr echter Verkehr aussieht, auch wenn Sie keine historischen Daten haben. Sie laden den synthetischen Eval-Satz herunter und können ihn prüfen, bevor Sie den Ergebnissen vertrauen. Das ist der Teil, der Tests für KI-Agenten für Teams möglich macht, die bei null anfangen.
Intent-Kalibrierung für konsistente Evaluatoren
Die Plattform nutzt einen proprietären Prozess zur Intent-Kalibrierung, um Ihre Aufgabe zu verstehen und einen hochwertigen Testsatz und einen konsistenten Evaluator zu erzeugen. Das ist der zentrale Unterschied zu einem generischen LLM-as-judge-Setup, bei dem der Judge abdriftet und dieselbe Antwort mit der Zeit unterschiedlich bewertet. Ein konsistenter Evaluator ist das, was eine Erfolgsquote berichtenswert macht. Ohne Konsistenz kein Vertrauen.
Maßgeschneiderte kleine Sprachmodelle
Plurai trainiert kleine Sprachmodelle für Ihre Aufgabe und setzt sie als Evaluator ein. Das Unternehmen nennt eine Antwortlatenz unter 100 ms und, im eigenen Vergleich, etwa $0,015 pro 1K Klassifizierungsanfragen gegenüber rund $0,3 für GPT-5 mini bei derselben Aufgabe. Diese Lücke ist der ganze Grund, warum ein Echtzeit-Guardrail bezahlbar wird. Die Zahlen stammen aus Plurais eigenem Benchmark, also behandeln Sie sie als Herstellerangaben.
Echtzeit-Guardrails
Guardrails lassen dieselben Evaluatoren auf den Live-Verkehr laufen. Statt Konversationen zu stichprobenartig zu prüfen und später zu bewerten, fangen Sie einen Richtlinienverstoß oder ein Verankerungsversagen im Moment des Auftretens ab und handeln. Genau darum geht es bei KI-Guardrails. Für alles, was direkt mit Kunden spricht, ist das der Unterschied zwischen einem überwachten und einem geschützten Agenten.
Optimierte LLM-Evaluatoren
Neben den kleinen Modellen bietet Plurai optimierte LLM-basierte Evaluatoren für höhere Genauigkeit zu wettbewerbsfähigen Kosten. Sie passen zu Offline-Evaluierung und Workflows mit Stichprobendaten, wo Präzision mehr zählt als Latenz. Die Wahl läuft auf eine Sache hinaus. Testen Sie im Nachhinein oder verteidigen Sie in Echtzeit?
Eval-Erstellung ohne Code und Experiment-Tracking
Evals werden ohne Code gebaut und auf jeden Anwendungsfall zugeschnitten, mit Experimentverwaltung und Analyse obendrauf. Teams können Läufe vergleichen, sehen, welche Änderung geholfen hat, und festhalten, was getestet wurde. Das verwandelt einmalige Prüfungen in einen wiederholbaren Prozess.
CI/CD-Integration und On-Prem-Deployment
Plurai hängt sich in die CI/CD ein, damit die Validierung kontinuierlich läuft, während sich Ihr Agent ändert, nicht nur einmal vor dem Launch. Für Teams, die mehr Kontrolle brauchen, wird es in Ihrem eigenen VPC bereitgestellt, was Latenz senkt und Daten in Ihrer Infrastruktur hält. Enterprise ergänzt On-Prem-Deployment, SSO und einen individuellen SLA.
Vor- und Nachteile
Vorteile
- Maßgeschneiderte kleine Modelle machen Evals mit voller Abdeckung und Echtzeit-Guardrails günstig genug für den Dauerbetrieb, was generalistische LLM-Judges meist nicht sind.
- Der Ansatz der Intent-Kalibrierung funktioniert ohne vorab beschriftete Daten, sodass Teams ohne Eval-Historie trotzdem einen brauchbaren Testsatz bekommen.
- Ein kostenloser Tarif mit 1M Tokens und einem persönlichen Endpunkt lässt Sie die Kernidee testen, bevor Sie sich festlegen.
- On-Prem- und VPC-Deployment geben Sicherheitsteams eine klare Antwort darauf, wo die Agentendaten liegen.
- Eval-Erstellung ohne Code und CI/CD-Integration senken die Hürde, Evals als Teil der normalen Entwicklung laufen zu lassen.
Nachteile
- Die Kosten- und Latenzzahlen stammen aus Plurais eigenen Benchmarks, eine unabhängige Überprüfung gibt es also noch nicht.
- Es richtet sich an Engineering-Teams mit einem laufenden Agenten zum Testen. Ohne etwas, worauf man es richten kann, ist der kostenlose Tarif schwer zu beurteilen.
- Die Preisgestaltung ist nutzungsbasiert pro Token und wird über SLM-, LLM- und Enterprise-Tarife hinweg kompliziert, was die Budgetplanung im Voraus weniger offensichtlich macht.
Häufige Fragen
Plurai testet KI-Agenten und schützt sie in der Produktion. Es erzeugt einen Testsatz für die Aufgabe Ihres Agenten, bewertet die Ausgaben und führt dann dieselben Prüfungen auf dem Live-Verkehr aus, um schlechte Antworten in Echtzeit abzufangen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Plurai.
Alternativen zu Plurai
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.