
Polarity
Polarity · Coding
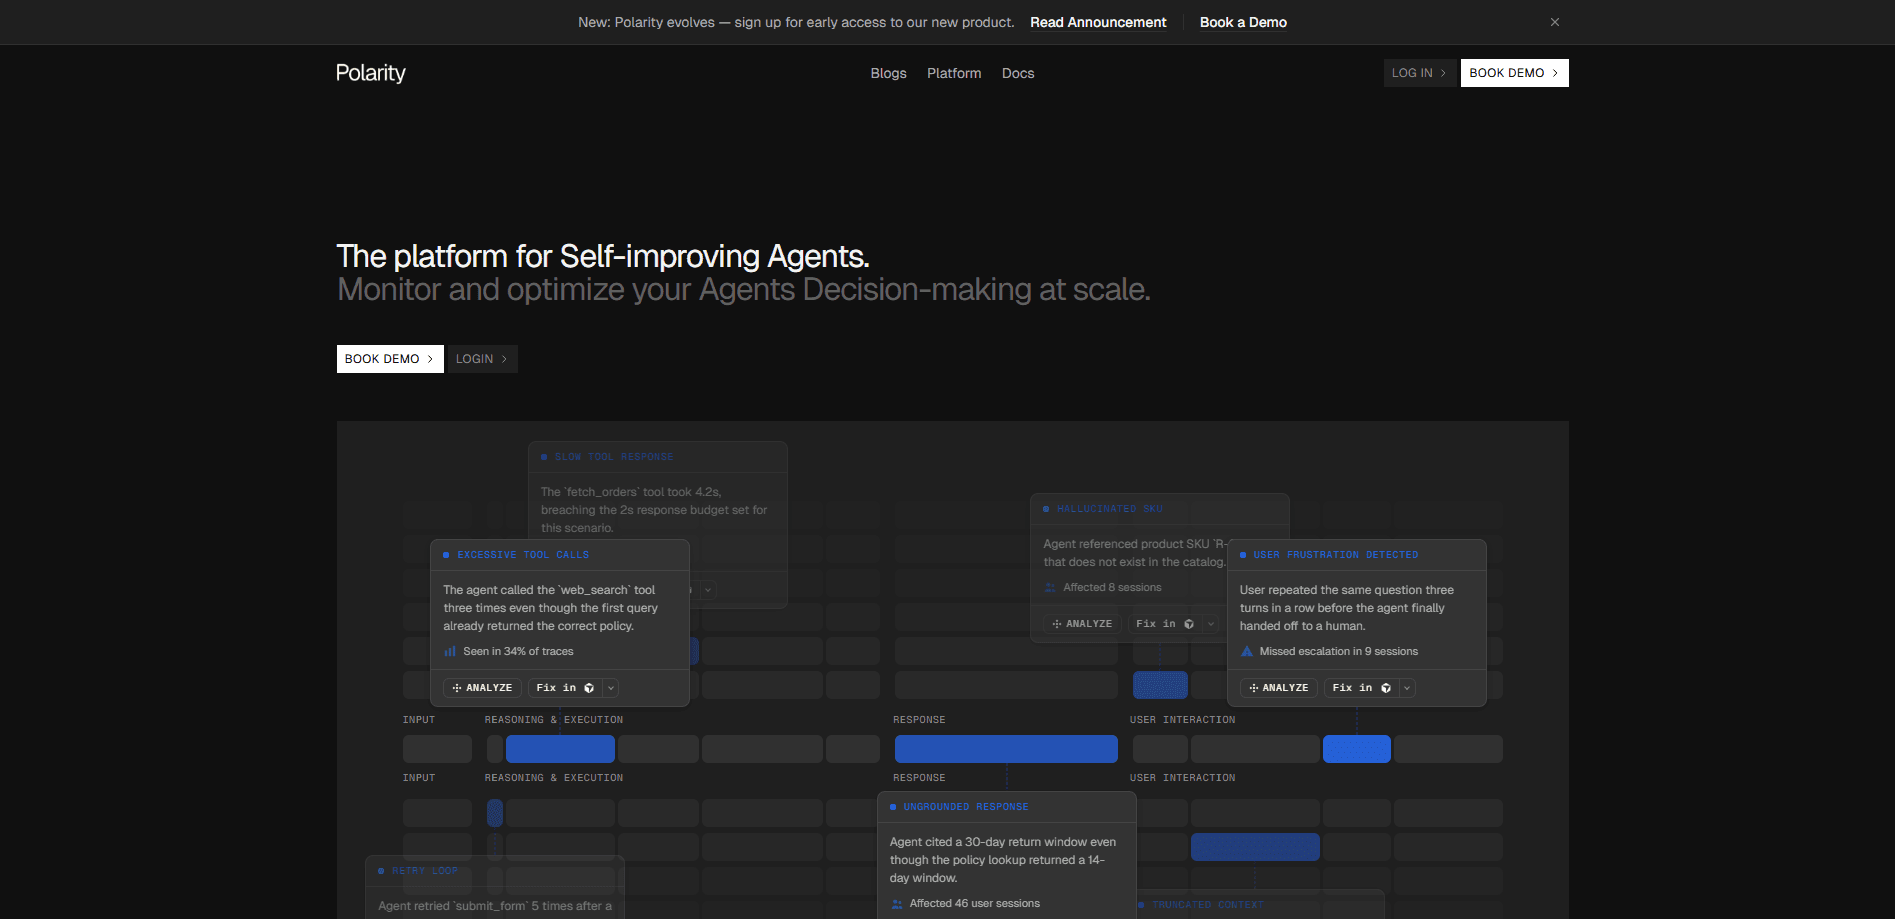
Polarity ist eine Sandbox-Plattform zum Bewerten und Überwachen von KI-Agenten. Sie führt Ihren Agenten in isolierten Docker-Umgebungen mit echten Hintergrunddiensten aus, bewertet, was der Agent tut, anhand von Invarianten und verbotenen Regeln und misst, wie stark sein Verhalten über wiederholte Läufe schwankt. Stellen Sie es sich als ein Tool zur Agentenbewertung vor, das das echte Verhalten als Test begreift. Wenn ein Lauf scheitert, lässt Sie die seed-basierte Wiedergabe die exakten Bedingungen wiederherstellen und den Fehler debuggen, statt zu raten.
Über Polarity
Was ist Polarity
Polarity ist eine Bewertungsplattform für Teams, die KI-Agenten ausliefern. Statt Agenten gegen ein geskriptetes Mock zu testen, führt die Plattform sie in einer Docker-Sandbox aus, die an echte Hintergrunddienste angebunden ist. So sieht der Agent dieselben APIs, Datenbanken und Tools, die er auch in der Produktion anfassen würde. Dieses Setup ist wichtig, denn die meisten Ausfälle eines Agenten kommen nicht von einer schlechten Antwort. Sie kommen daher, dass der Agent eine Aktion ausführt, die niemand wollte.
Die Plattform prüft zwei Dinge zugleich. Erstens, ob jeder Lauf die von Ihnen gesetzten Regeln einhält, die Polarity in Invarianten, die immer gelten müssen, und verbotene Regeln, die nie auslösen dürfen, aufteilt. Zweitens, wie stabil das Verhalten ist. Dieselbe Aufgabe über mehrere Replikas laufen zu lassen, bringt die Nichtdeterminiertheit ans Licht, die ein einzelner Durchlauf komplett verbergen würde. Und dieser Unterschied ist wichtig, denn ein Agent, der einen Lauf besteht und den nächsten verpatzt, ist die Sorte, die die Produktion still kaputtmacht, lange nachdem alle aufgehört haben hinzusehen.
Die größte Einschränkung ist der Umfang. Polarity ist ein Entwicklertool, keine Verbraucher-App. Sie brauchen also einen paketierten Agenten und aus der Sandbox erreichbare Hintergrunddienste, bevor Sie einen Nutzen haben. Teams ohne automatisiertes Testsetup verbringen die ersten Tage mit der Verkabelung.
Erste Schritte
- Melden Sie sich auf der Polarity-Website an und legen Sie ein Projekt für den Agenten an, den Sie bewerten wollen.
- Richten Sie das Projekt auf Ihren Agenten aus und definieren Sie die Hintergrunddienste, die er braucht, damit die Sandbox mit denselben Abhängigkeiten startet, die die Produktion hat.
- Schreiben Sie Ihre Invarianten und verbotenen Regeln als die Prüfungen, gegen die jeder Lauf bewertet wird.
- Führen Sie eine Aufgabe in einem oder mehreren Replikas aus, um zu sehen, ob das Verhalten stabil bleibt oder zwischen Versuchen abdriftet.
- Öffnen Sie einen beliebigen Fehler, geben Sie ihn aus seinem Seed wieder und beheben Sie die Ursache, bevor Sie ausliefern.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Polarity.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Engineering-Teams
- Plattform- und Infrastruktur-Engineers
- QA- und Reliability-Verantwortliche
Aufgaben
- Verhalten des Agenten bewerten
- Nichtdeterminiertheit aufspüren
- Fehler debuggen
- Regressionstests für Agenten vor dem Release
Szenarien
- Einen neuen Agenten in die Produktion bringen
- Einen sporadischen Fehler des Agenten debuggen
- Einen Agenten nach einem Modellwechsel prüfen
Wichtigste Funktionen
Sandbox-Läufe mit echten Diensten
Polarity führt jede Agentenaufgabe in einer Docker-Sandbox für KI-Agenten aus, nicht in einem simulierten Testaufbau. Die Sandbox ist an echte Hintergrunddienste angebunden, sodass der Agent während der Bewertung mit echten APIs und Datenspeichern interagiert. Das Verhalten, das Sie bewerten, liegt dadurch näher an dem, was Nutzer tatsächlich erleben.
Bewertung durch Invarianten und verbotene Regeln
Jeder Lauf wird an zwei Regeltypen gemessen. Invarianten beschreiben Bedingungen, die in jedem Lauf gelten müssen, während verbotene Regeln die Aktionen benennen, die nie passieren dürfen. Sie aufzuschreiben zwingt ein Team, sich darauf zu einigen, was „korrekt" bedeutet, und genau das ist oft der schwierigere Teil.
Messung der Nichtdeterminiertheit
Agenten verhalten sich nicht jedes Mal gleich, und ein einzelner erfolgreicher Lauf beweist sehr wenig. Polarity führt dieselbe Aufgabe über mehrere Replikas aus und vergleicht die Ergebnisse, sodass Sie sehen, wie stark der Agent zwischen Versuchen abdriftet. Eine hohe Varianz ist meist das erste Anzeichen für einen fragilen Prompt oder ein instabiles Tool.
Seed-basierte Wiedergabe
Wenn ein Lauf scheitert, kann Polarity ihn aus seinem ursprünglichen Seed wiedergeben. Die Wiedergabe baut dieselben Bedingungen nach, die den Fehler erzeugt haben, und macht so aus einem sporadischen Bug etwas, das Sie untersuchen, beheben und verifizieren können. Für Teams, die flaky Agenten gewohnt sind, per Hand zu jagen, ist das die Funktion, die am meisten Zeit spart.
Überwachung für ausgelieferte Agenten
Die Bewertung endet nicht beim Code-Review. Polarity übernimmt auch die Überwachung von KI-Agenten, sobald sie laufen, und bewertet das Live-Verhalten anhand derselben Regeln, die Sie im Test verwendet haben. Sie erkennen einen Regelverstoß in der Produktion, statt davon von einem Nutzer zu hören.
Vor- und Nachteile
Vorteile
- Echte Dienste in der Sandbox sorgen dafür, dass die Bewertungen das Produktionsverhalten widerspiegeln, kein vereinfachtes Mock.
- Die Bewertung durch Invarianten und verbotene Regeln liefert eine klare, testbare Definition von korrektem Verhalten.
- Replika-Läufe machen die Nichtdeterminiertheit sichtbar, die die meisten Eval-Tools mit einem Durchlauf übersehen.
- Die seed-basierte Wiedergabe verkürzt die Debug-Schleife bei sporadischen Fehlern.
- Die Überwachung dehnt dasselbe Regelwerk vom Test bis in die Produktion aus.
Nachteile
- Keine kostenlose Stufe, und die Preise werden nicht veröffentlicht, also müssen Sie mit dem Vertrieb sprechen, bevor Sie die Kosten beurteilen können.
- Es ist ein Entwicklertool, also hängt der Nutzen davon ab, dass Ihr Agent und seine Dienste schon für den Lauf in einer Sandbox paketiert sind.
- Echte Hintergrunddienste zu speichern und auszuführen erhöht den Einrichtungsaufwand und die Infrastrukturkosten im Vergleich zu mock-basierten Eval-Tools.
- Nicht ideal für Teams, die nur eine schnelle Demo wollen. Polarity setzt voraus, dass Sie bereits testen.
Häufige Fragen
Es bewertet und überwacht KI-Agenten. Sie definieren Regeln, Polarity führt Ihren Agenten in einer Docker-Sandbox mit echten Diensten aus, bewertet jeden Lauf anhand dieser Regeln und lässt Sie Fehler wiedergeben. Was bringt Ihnen das also? Weniger Überraschungen, wenn der Agent live geht.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Polarity.
Alternativen zu Polarity
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.