
Prefactor
Prefactor · Coding
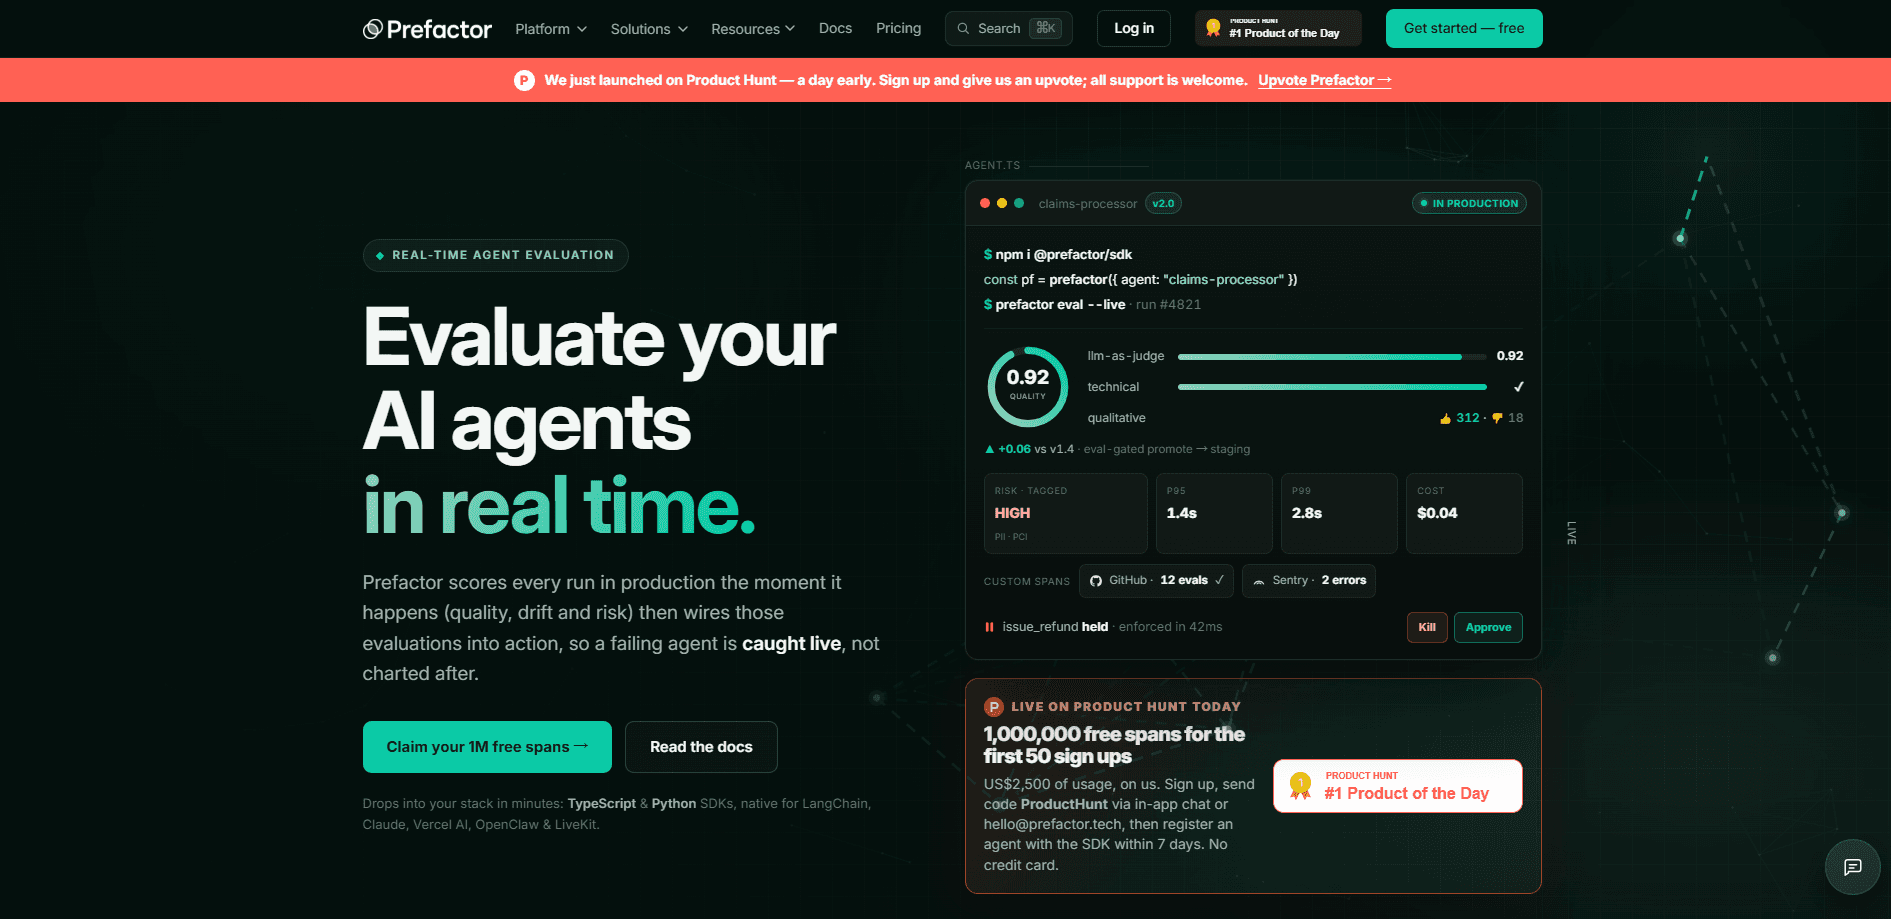
Prefactor ist eine Plattform zur Bewertung zur Laufzeit für KI-Agenten. Sie ist zugleich Leistungsüberwachung von Agenten mit Zähnen. Sie zeichnet jeden Schritt eines Agenten als Trace auf, bewertet diesen Schritt nach Qualität, Drift und Datenrisiko und erzwingt dann eine Aktion, wenn etwas eine Grenze überschreitet. Teams halten damit einen riskanten Lauf zur menschlichen Genehmigung an, blockieren eine Aktion ganz oder beobachten weiter mit voller Transparenz, statt den Fehler um 1 Uhr nachts aus einer Kundenmail zu erfahren. Die Bewertung läuft durchgehend. Die Kontrolle ebenso.
Über Prefactor
Was ist Prefactor
Die meisten Überwachungswerkzeuge zeichnen dir ein Diagramm und geben dir das Problem zurück. Bis du das Dashboard gelesen hast, hat der Agent schon gehandelt. Diese Lücke zwischen Sehen und Stoppen ist der ganze Grund, warum es Prefactor gibt.
Was macht Prefactor dagegen? Er sitzt auf der Laufzeitebene des Agenten. Leichte SDKs in TypeScript und Python erfassen jeden Modellaufruf, jeden Werkzeugaufruf und jede Entscheidung als Span und führen dann deine Bewertungen und Risikoprüfungen auf diesem Span aus, während der Agent arbeitet. Wenn ein Lauf eine von dir gesetzte Regel verletzt, greift Prefactor über dasselbe SDK oder dieselbe API ein, sodass die Richtlinie gilt, ob der Agent mitspielt oder nicht.
Der Preis dafür ist der Umfang. Prefactor ist für Teams gebaut, die Agenten an echte Nutzer ausliefern, nicht für jemanden, der am Wochenende an einem einzelnen Chatbot herumbastelt. Der kostenlose Tarif begrenzt dich auf drei Agenten mit sieben Tagen Datenaufbewahrung. Darüber hinaus zahlst du.
Erste Schritte
- Installiere die Prefactor CLI und melde dich an, um deinen Arbeitsbereich zu verbinden; sie entdeckt Agenten über all deine Laufzeitumgebungen hinweg ohne Migration.
- Binde das TypeScript- oder Python-SDK in deinen Agentencode ein. Native Integrationen gibt es für LangChain, Claude, Vercel AI, OpenClaw und LiveKit.
- Starte deinen Agenten und sieh zu, wie Läufe live als Traces hereinkommen, mit Kosten und Datenrisiko an jedem Schritt.
- Definiere die Bewertungen, die dir wichtig sind: LLM als Richter, technische Prüfungen, qualitative Messgrößen oder eine eigene Geschäftsregel.
- Lege die Kontrollaktion für jede Regel fest und lass Prefactor zur Laufzeit anhalten, genehmigen oder blockieren.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Prefactor.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Plattform- und ML-Engineering-Teams
- Sicherheits- und Compliance-Verantwortliche
- Solobauer im kostenlosen Tarif
Aufgaben
- Eine risikoreiche Aktion anhalten, bevor sie läuft
- Die Ausgabequalität an jedem Schritt bewerten
- Belegen, was ein Agent getan hat
- Eine Agentenversion zurückrollen
Szenarien
- Kundensupport-Agenten, die Rückerstattungen und Kontowechsel bearbeiten
- Teams, die mehrere Frameworks nebeneinander betreiben
- Unternehmen mit Schatten-Agenten, die niemand kontrolliert
- Einen Agenten zum ersten Mal in die Produktion bringen
Wichtigste Funktionen
Kontrolle zur Laufzeit, nicht nur Warnungen
Das ist die Funktion, die Prefactor von einem Dashboard unterscheidet. Bewertungen und die Risikobewertung des Agenten verdrahten sich direkt mit der Aktion, ein Lauf kann also in dem Moment pausiert, gedrosselt oder blockiert werden, in dem er eine Grenze überschreitet. Jede Kontrollentscheidung wird protokolliert, was zählt, wenn du später erklären musst, warum ein Agent gestoppt wurde.
Jeden Aufruf, jedes Werkzeug und jede Entscheidung nachzeichnen
Jeder Modellaufruf, jede Werkzeugausführung und jeder Nachrichtenwechsel wird zu einem Span innerhalb einer Trace, und verschachtelte oder eigene Geschäfts-Spans sind in jedem Tarif möglich. Kosten und Datenrisiko hängen an jedem Schritt. So siehst du nicht nur, was der Agent getan hat, sondern auch, was es gekostet hat und ob er sensible Daten berührt hat. Vollständige Traces kommen live herein, statt erst nach Ende des Laufs aufzutauchen.
Bewertungen, die du selbst festlegst
Prefactor führt die Evals aus, die du schreibst, und zwar an jedem Schritt: LLM als Richter, technische Prüfungen und qualitative Messgrößen, mit optionalem eigenem LLM für die Bewertungen. Es gibt keine Kosten pro Prüfung, und die menschliche Überprüfung speist sich in den Kreislauf ein. Deterministische Bewertung plus Risiko- und Musterprüfungen laufen über 100 % deiner Aktivität. Nichts rutscht durch.
Framework-unabhängige Integration
Eine Ebene deckt Claude, Copilot, LangChain, N8N und das ab, was dein Team als Nächstes baut. Das SDK fügt laut Prefactor unter einer Millisekunde Overhead pro Aufruf hinzu. Das ist die Zahl, die für latenzempfindliche Agenten zählt. Nativen Support gibt es für LiveKit und OpenClaw neben den allgemeinen TypeScript- und Python-Bibliotheken. Keine Proxies und keine Abfangung auf Netzwerkebene, nur Code, der mit deinen Agenten ausgeliefert wird.
Versionierung und Umgebungen
Agenten lassen sich mit sofortigem Rollback versionieren, und getrennte Umgebungen für Entwicklung, Staging und Produktion werden unterstützt, mit Eval-Gates im Förderpfad. Diese Kombination lässt dich eine Änderung gegen echte Verkehrsmuster testen, bevor sie die Nutzer erreicht. Verhält sie sich schlecht, machst du sie schnell rückgängig. Kein Warten auf einen Notfallpatch.
Stufen der Datenaufbewahrung
Die Aufbewahrung skaliert mit dem Tarif: sieben Tage bei Dev, drei Monate bei Startup, zwölf Monate bei Scaleup und Enterprise. Für Teams unter Prüfungsdruck ist diese Spanne oft der Unterschied zwischen dem Zitieren eines Protokolls und dem Eingeständnis, dass du nicht rekonstruieren kannst, was passiert ist. Die Stufen der Aufbewahrung zählen mehr, als sie klingen.
Vor- und Nachteile
Vorteile
- Die Kontrolle zur Laufzeit ist der eigentliche Unterschied; die meisten Werkzeuge bleiben bei Beobachtung und Bewertung stehen.
- Unter 1 ms SDK-Overhead pro Aufruf, die Instrumentierung wird also nicht zum Flaschenhals.
- Framework-unabhängig, was zu Teams passt, die ihren Stack schon gewählt haben und nicht migrieren wollen.
- Unbegrenzte Plätze in jedem Tarif, auch in der kostenlosen Dev-Stufe.
- PII-Prüfungen laufen innerhalb des Zuverlässigkeitskreislaufs ohne Kosten pro Prüfung.
Nachteile
- Der kostenlose Dev-Tarif begrenzt dich auf drei Agenten und behält nur sieben Tage Daten, der echte Produktionseinsatz beginnt also in der Stufe für $49/Monat.
- Der Preis richtet sich nach der Nutzung in Spans, was schwer vorherzusagen ist; der Schätzer zeigt 1.000.000 Spans pro Monat für etwa $2.449 bei Scaleup.
- Er richtet sich an Teams mit Engineering-Personal. Wenn bei dir niemand Evals schreiben oder Traces lesen kann, bleibt die Plattform ungenutzt.
- Kein Google Play und keine mobile App; das ist ein Entwicklerwerkzeug, genutzt über CLI, SDK und Web-App.
- Selbst gehostetes Deployment und SSO sind der Enterprise-Stufe vorbehalten, was ein Verkaufsgespräch bedeutet.
Häufige Fragen
Er zeichnet jeden Schritt auf, den ein KI-Agent geht, bewertet jeden Schritt nach Qualität und Risiko und handelt dann nach dieser Bewertung, indem er einen Lauf zur Laufzeit anhält, genehmigt oder blockiert. Das ist KI-Agent-Bewertung, direkt mit Kontrolle verdrahtet. Kurz gesagt schließt er den Kreislauf zwischen dem Erkennen eines Problems und seinem Stoppen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Prefactor.
Alternativen zu Prefactor
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.