
Privent
Privent Technologies, Inc. · Coding
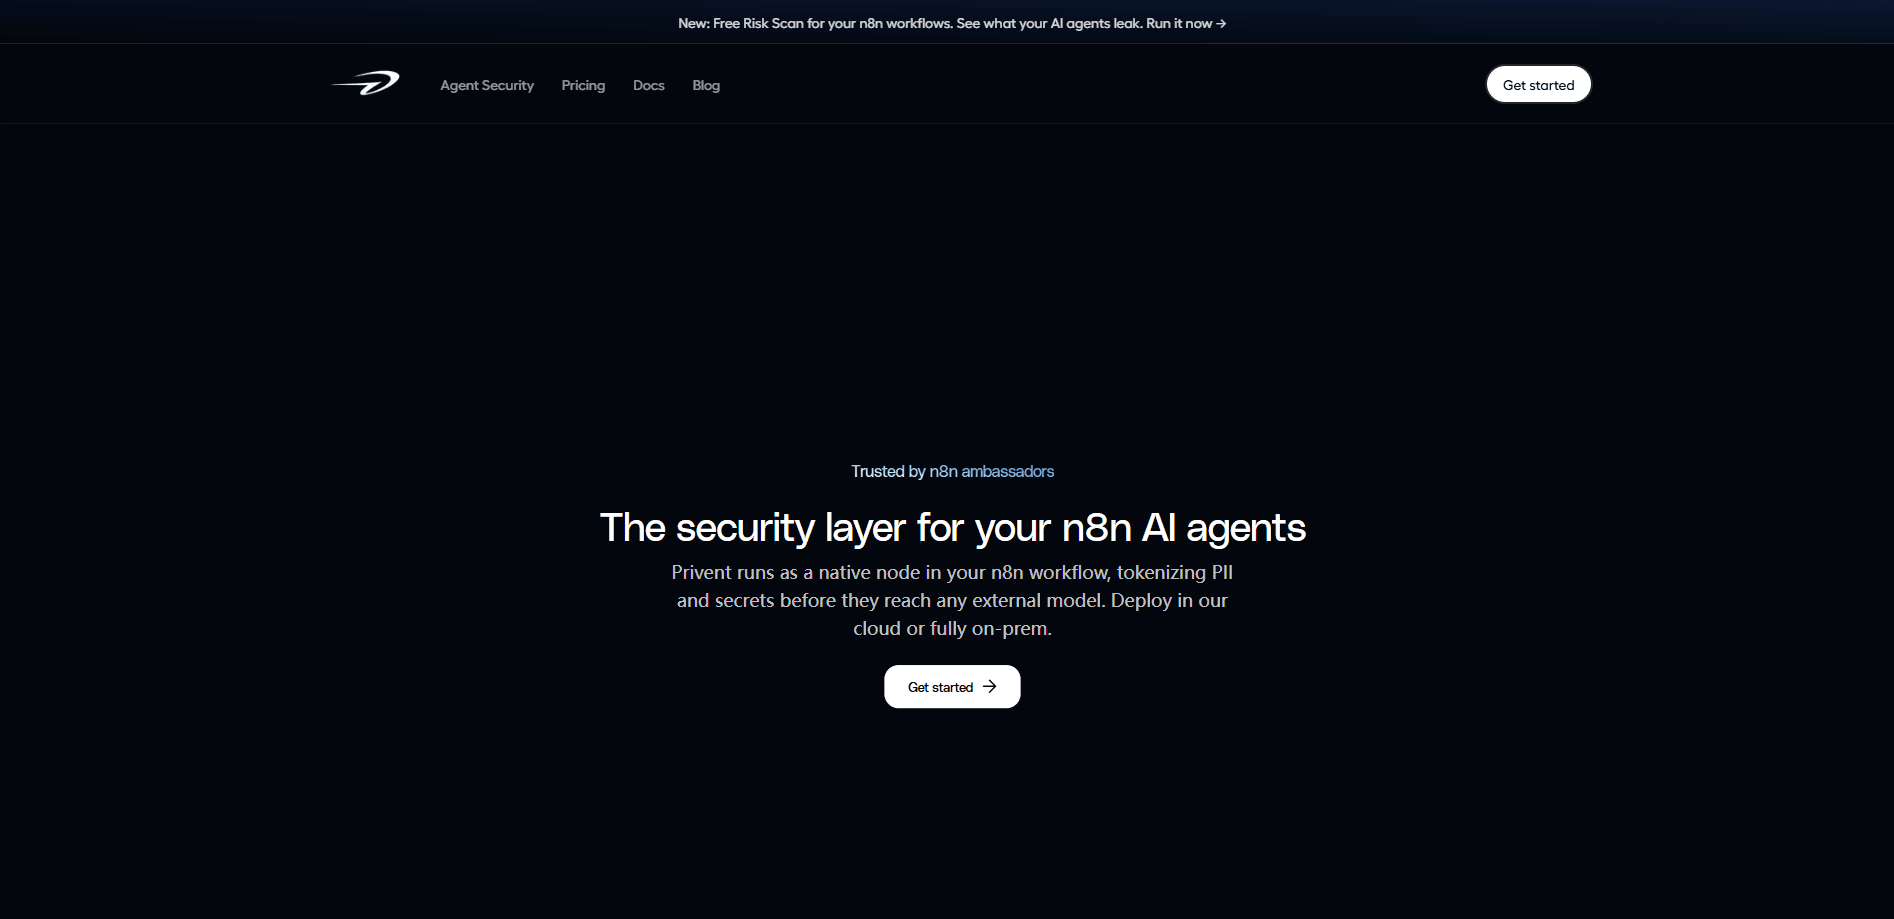
Privent ist eine Sicherheitsschicht zur Laufzeit, die für n8n-KI-Agenten gebaut wurde. Sie installiert sich als nativer Workflow-Knoten und prüft die Daten, die Ihr Agent gerade senden will, und fängt PII, PHI und Secrets ab, bevor sie ein externes LLM erreichen. Sensible Werte werden in umkehrbare Tokens umgewandelt, riskante Läufe bekommen einen Score, und jede Entscheidung landet in einem Prüfprotokoll. Man kann es sich als Datenkontrolle für KI-Agenten genau an der Stelle vorstellen, an der sie zählt. Sie können es in der Privent-Cloud, in Ihrer eigenen n8n-Engine oder vollständig on-prem laufen lassen.
Über Privent
Was ist Privent
Privent sitzt zwischen Ihrem KI-Agenten und der Außenwelt. Genau in dieser Lücke passieren die meisten Datenlecks. Ein Agent holt einen Kundendatensatz, baut einen Prompt und schickt das Ganze an ein Fremdmodell, ohne dass jemand prüft, was mitgereist ist.
Die Antwort des Produkts ist eine Kontrollschicht, die die Nutzlast zur Laufzeit liest. Sie erkennt persönliche und finanzielle Daten sowie Zugangsdaten und Quellcode und ersetzt dann die sensiblen Teile durch Tokens, mit denen der Agent weiterarbeiten kann. Die De-Tokenisierung passiert auf dem Rückweg. Die Logik Ihres Workflows ändert sich kaum. Der ganze Punkt ist, dass Ihre Prompts die Erkennungs-Pipeline nie als Klartext verlassen.
Es gibt echte Grenzen, die man im Kopf behalten sollte. Privent ist heute auf n8n zugeschnitten, mit LangGraph, CrewAI, MCP und einem eigenständigen SDK als bald verfügbar gelistet. Teams, die andere Agent-Frameworks nutzen, können es noch nicht einsetzen. Die Erkennung ist außerdem eine Pipeline, die man bereitstellen und pflegen muss, kein Schalter, den man einmal umlegt. Und wenn Sie die stärksten Garantien wollen, liegt der Wert bei On-Prem, was bedeutet, dass jemand auf Ihrer Seite die Installation übernehmen muss.
Erste Schritte
- Öffnen Sie in n8n die Einstellungen und gehen Sie zu Community-Nodes, dann installieren Sie das Paket
n8n-nodes-privent. - Fügen Sie ein PriventApi-Zugangsdatum mit Ihrem API-Schlüssel und Ihrer Basis-URL hinzu.
- Legen Sie die Nodes Session, Tokenize und Detokenize dort auf die Workflow-Leinwand, wo Daten in den Agenten hinein- und aus ihm herausgehen.
- Führen Sie einen Testlauf aus und prüfen Sie im Dashboard Erkennungsereignisse, Risiko-Scores und den Zugriffspfad.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Privent.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Sicherheits- und Plattform-Engineers, die n8n in Produktion betreiben
- Compliance-Teams in regulierten Branchen
- Kleine Agenturen, die Agent-Workflows für Kunden bauen
Aufgaben
- Kundendatensätze bereinigen, bevor ein Agent ein gehostetes LLM aufruft
- Dokumente in großem Umfang verarbeiten
- Belegen, was ein Agent getan hat und warum
Szenarien
- Ein Support-Agent, der Tickets liest und Antworten entwirft
- Ein Finanz-Workflow, der Transaktionen zusammenfasst
- Ein Deployment in einem isolierten Netz in einer Bank oder einem Krankenhaus
Wichtigste Funktionen
Laufzeit-Interceptor für n8n
Der Kern-Node beobachtet die Daten, während sie durch Ihren Agenten wandern, bevor sie in ein externes Modell übergehen. In der Praxis läuft die Sicherheit für n8n-Agenten genau darauf hinaus: die echte Nutzlast sehen, nicht nur die Verbindung. Er bewertet jede einzelne und entscheidet, ob die Aktion erlaubt, mit Warnung versehen oder blockiert wird. Weil er in der Laufzeitumgebung läuft und nicht am Netzrand, sieht er den tatsächlichen Inhalt, den der Agent gleich verwenden will.
Umkehrbare Tokenisierung
Erkannte Werte werden durch Tokens im Stil [KIND_NNN] ersetzt, die Typ und Position behalten. Zuerst läuft die PII-Erkennung, dann der Austausch. Der Agent kann weiter über den Datensatz nachdenken, und Detokenize stellt die echten Werte auf dem Rückweg wieder her. Sie bekommen nutzbare Ergebnisse, ohne je Klartext auf die Leitung zu legen.
Risiko-Score und Aufschlüsselung nach Kategorie
Jede Scoring-Anfrage erzeugt einen zusammengesetzten Risiko-Score plus eine Aufschlüsselung pro Signal. Die Kategorien decken PII, Finanzdaten, Quellcode sowie rechtliche und strategische Inhalte ab. Sie können die Richtlinie pro Datentyp justieren, statt alles als gleich gefährlich zu behandeln.
Prüfprotokolle und Zugriffspfade
Das System zeichnet das Ergebnis der Entscheidung auf, die angewandten Stufen, Zeitstempel, die Deployment-Gruppe und den Node im Ausführungsgraphen, der sie ausgelöst hat. Bei Dokument-Jobs wird auch jeder Download eines tokenisierten Ergebnisses protokolliert. Nichts speichert den Rohtext. Prompt-Inhalte werden im Speicher verarbeitet und verworfen.
Pipeline zur Dokumentverarbeitung
Ganze Dateien laufen durch dieselbe Tokenisierung wie Text, über eine asynchrone Jobs-API. Ein Job durchläuft vier Stufen: Queued, Extracting, Scoring und Tokenizing. Danach landet er in einem von drei Endzuständen, darunter ein eigenes Ergebnis "abgeschlossen mit Warnungen", das nie zu reinem Erfolg oder Fehlschlag zusammenfällt. Gescannte PDFs nutzen OCR über einen optionalen Build mit lokal eingebundenen Modellen, und gespeicherte Artefakte laufen standardmäßig nach 24 Stunden ab.
Cloud, selbst gehostet oder vollständig on-prem
Sie wählen, wo die Pipeline lebt. On-Prem-KI-Sicherheit ist hier das eigentliche Verkaufsargument. Installationen enthalten den kompletten Stack mit ML-Inferenz, sodass selbst die flüchtige Verarbeitung im Speicher in Ihrem Netz bleibt. Die Dokument-Engine startet fail-closed. Ein Produktions-Deployment weigert sich zu starten, statt Scans stillschweigend zu überspringen.
Überwachungs-Erweiterung
Eine separate Browser-Erweiterung zur KI-Überwachung wird über MDM verteilt, etwa Google Workspace oder Intune. Sobald sie mit einem API-Schlüssel und einem Deployment-Gruppenschlüssel konfiguriert ist, erscheinen Erkennungsereignisse in Echtzeit im Dashboard.
Vor- und Nachteile
Vorteile
- Funktioniert als nativer n8n-Node, sodass bestehende Workflows nur ein paar neue Schritte auf der Leinwand brauchen statt eines kompletten Neuaufbaus.
- Die Tokenisierung ist umkehrbar, was bedeutet, dass die Ausgabe des Agenten korrekt bleibt, während das Modell selbst nie an irgendeinem Punkt rohe sensible Daten verarbeitet.
- Starke On-Prem-Geschichte: Der gesamte Stack, ML-Inferenz eingeschlossen, kann isoliert ohne ausgehende Aufrufe laufen.
- Transparente, öffentliche Preise ab einem kostenlosen Tarif, ohne separate Enterprise-Stufe, die die echten Kosten versteckt.
- Klare Datenrichtlinie: Prompt-Text wird im Speicher verarbeitet und nie auf die Festplatte geschrieben, indexiert oder zum Training genutzt.
Nachteile
- n8n ist derzeit das einzige voll unterstützte Framework; LangGraph, CrewAI, MCP und das SDK sind noch Vorschau oder bald verfügbar, also müssen breitere Teams warten.
- Die Framework-Lücke zu schließen heißt, selbst eine Erkennungs-Pipeline zu pflegen, sobald Sie auf On-Prem gehen, was zusätzliche Betriebsarbeit bedeutet.
- Artefakte von Dokument-Jobs laufen standardmäßig nach 24 Stunden ab, sodass jede langfristige Aufbewahrung etwas ist, das Ihre Speicherschicht übernehmen muss.
Häufige Fragen
Es prüft Daten, die durch Ihre n8n-KI-Agenten wandern, und fängt sensible Inhalte ab, bevor sie ein externes LLM erreichen. Sensible Werte werden zu umkehrbaren Tokens, und jeder Lauf bekommt einen Risiko-Score samt vollständigem Prüfeintrag, den Sie später einsehen können.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Privent.
Alternativen zu Privent
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.