
Pulse for Elasticsearch and OpenSearch
NeverBlink · Coding · Sonstiges
Pulse for Elasticsearch and OpenSearch ist eine KI-Plattform von NeverBlink, die Ihre Cluster überwacht, langsame Abfragen und Verschwendung meldet und Ihnen Lösungen liefert.
Über Pulse for Elasticsearch and OpenSearch
About
Was ist Pulse for Elasticsearch and OpenSearch
Pulse ist ein Werkzeug zur Überwachung und Optimierung für Teams, die Elasticsearch oder OpenSearch betreiben. Statt Sie Dashboards lesen und raten zu lassen, prüft es Ihre Cluster rund um die Uhr und sagt Ihnen, was langsam ist, was verschwendet wird und was kurz vor dem Ausfall steht. Jede Empfehlung kommt mit der Begründung dahinter, sodass Ihr Engineering-Team die Kontrolle darüber behält, was umgesetzt wird.
Das Problem, das es angeht, ist die stille Abgabe beim Betrieb von Such-Clustern im großen Maßstab: langsame Abfragen, ausufernde Cloud-Rechnungen und Anrufe um zwei Uhr nachts. Dieses Fachwissen ist knapp und im eigenen Haus schwer zu halten, und mit KI-Agenten, die Abfragen und Schemas in Maschinengeschwindigkeit ausliefern, wird es noch schwieriger. Pulse dockt an dem an, was Sie bereits betreiben, statt es zu ersetzen, und es arbeitet mit Werkzeugen wie Grafana und Datadog zusammen, indem es eine datenbankspezifische Ursachenanalyse ergänzt, die diese Tools nicht sehen.
Die Grenzen sollten Sie vorab kennen. Pulse liest nur Metriken und Metadaten und kann daher nicht den Inhalt Ihrer Dokumente einsehen. Es empfiehlt Änderungen, statt sie von selbst anzuwenden, was bedeutet, dass jemand in Ihrem Team sie noch umsetzen muss. Und der volle Support konzentriert sich heute auf Elasticsearch und OpenSearch, während ClickHouse und PostgreSQL noch in der privaten Beta sind.
Getting Started
- Verbinden Sie Ihre Cluster über einen leichtgewichtigen Collector, der in Ihrer Umgebung läuft, ohne etwas auf den Datenbankservern selbst zu installieren
- Lassen Sie die Plattform Metriken, Logs, Abfragen und Konfiguration lesen, um ein Bild der Gesundheit jedes Clusters zu erstellen
- Sehen Sie die priorisierten Empfehlungen zu Indizes, Projektionen und Abfrage-Neuschreibungen durch, jede mit ihrer Begründung
- Entscheiden Sie, was wann umgesetzt wird, und verfolgen Sie die Ergebnisse im Dashboard
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Pulse for Elasticsearch and OpenSearch.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Plattform-Engineers
- SRE-Teams
- Data Engineers
- Engineering-Manager
- Entwickler von KI-Agenten
Aufgaben
- Cluster-Kosten senken
- Langsame Abfragen aufspüren
- Cluster-Gesundheit bewerten
- Vorfälle verhindern
- Index-Mappings prüfen
- Agenten versorgen
Szenarien
- Ein Plattformteam mit Dutzenden von Clustern
- Ein Team vor einer unerwarteten Cloud-Rechnung
- Ein Suchausfall zur ungünstigen Stunde
- Ein KI-Workflow, der echte Daten abfragt
- Ein kleines Startup mit einem Cluster
Wichtigste Funktionen
Kontinuierliche Bewertung der Cluster-Gesundheit
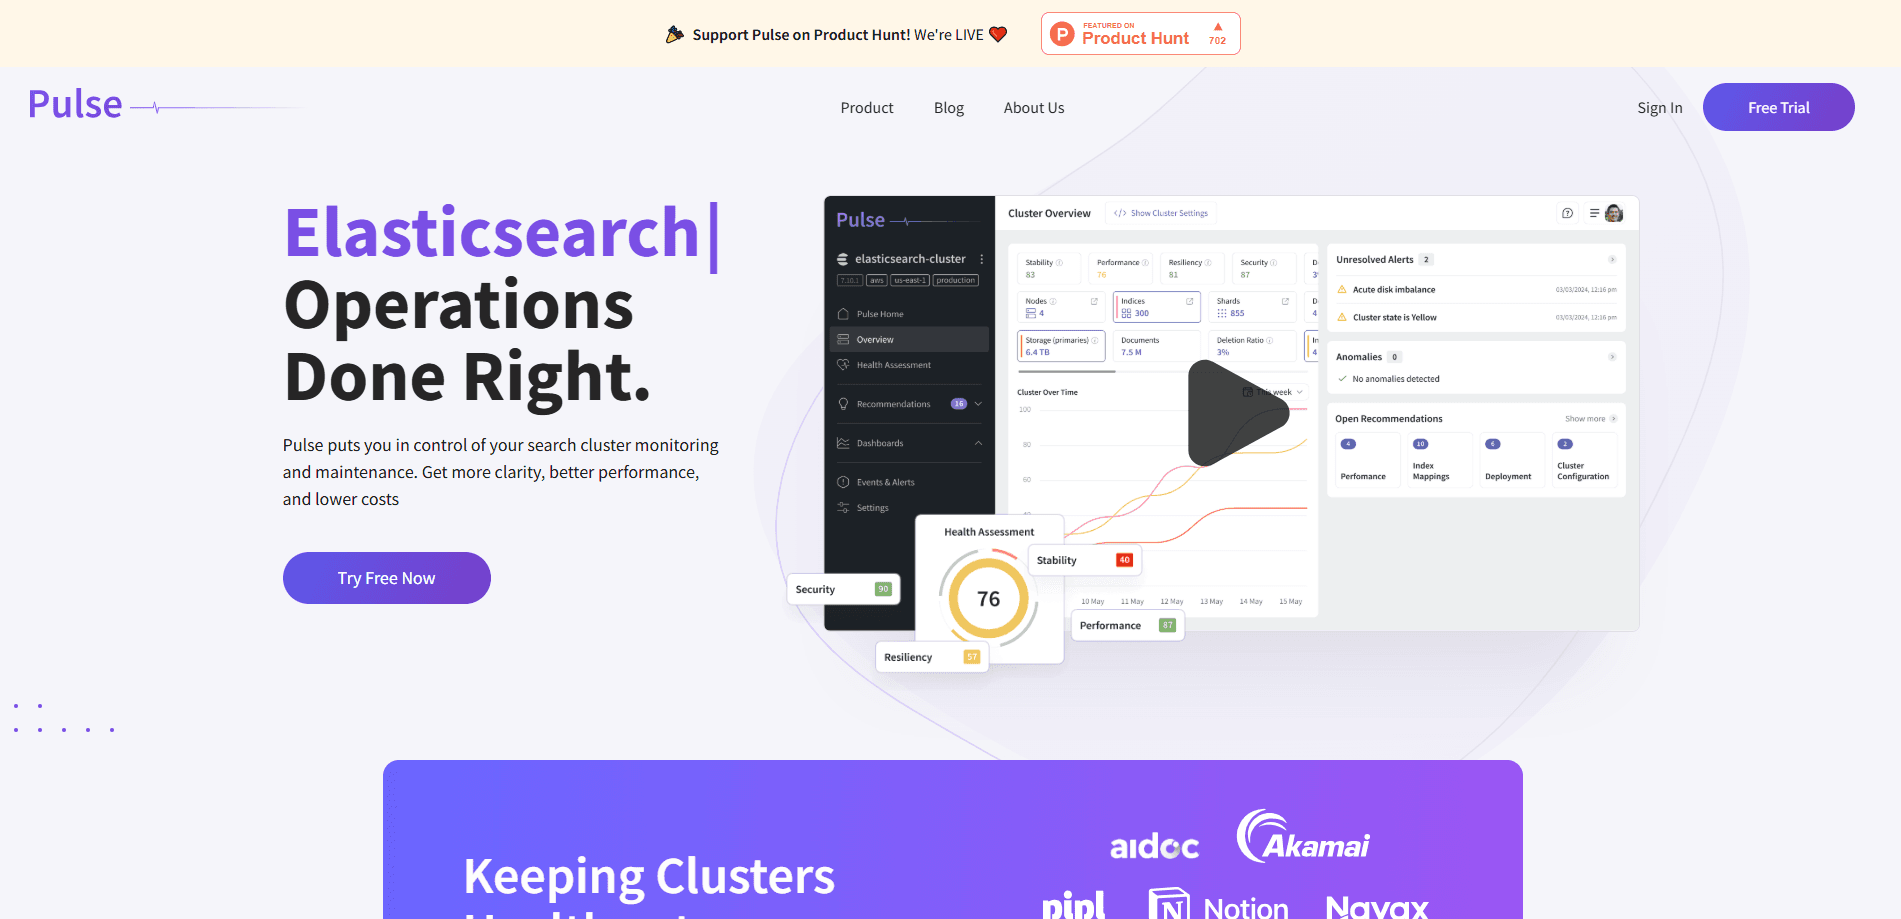
Pulse bewertet die Gesundheit jedes Clusters, den es überwacht, und hält diese Bewertung aktuell, wenn sich die Lage ändert. Genau hier beginnt jede Produktivumgebung, die Elasticsearch überwachen und Elasticsearch optimieren will. Sie sehen Stabil und Aufmerksamkeitsbedürftig nebeneinander, ohne ein Dutzend Konsolen zu öffnen. Das ist der Unterschied zwischen Problemsuche und der Ansage, wo sie liegen.
Abfrage-Analyse, die das Teure benennt
Die Plattform verfolgt Abfragemuster über jeden Cluster und klassifiziert sie, dann legt sie die langsamen, teuren und redundanten Abfragen hinter Ihrer Latenz und Ihren Kosten offen. Sie bekommen Latenz pro Abfrage, Aufrufzahlen und Ressourcennutzung, dazu konkrete Empfehlungen zu Indizes, Projektionen und Neuschreibungen. Das macht aus einem vagen "es ist langsam" eine gezielte Lösung.
Automatisierte Ursachenanalyse
Wenn ein Alarm auslöst, geht Pulse über das rohe Signal hinaus und erklärt, was ihn wahrscheinlich verursacht hat, samt der zu ergreifenden Maßnahmen. Es ist darauf ausgelegt, Überwachungswerkzeuge wie Grafana und Datadog zu ergänzen statt zu ersetzen, indem es eine datenbankspezifische Ursachenanalyse ergänzt, die diese Tools nicht bieten. Der Punkt ist, die Zeit zwischen Warnung und Behebung zu verkürzen.
Kostenoptimierer
Pulse markiert die Entscheidungen, die Ihre Cloud-Rechnung unbemerkt aufblähen, etwa überdimensionierte Knoten und Indizes, die mehr kosten als sie einbringen. Die Kostenoptimierung läuft derzeit für Cloud-Deployments, daher bekommen Teams mit selbst verwalteter Infrastruktur nicht alle Kostensignale. Selbst eine vierteljährliche Prüfung kann sich rechnen, wenn ein Cluster überbaut ist.
Einheitliche Ansicht
Jede Datenbank, die Sie betreiben, landet in einer Ansicht, über Cluster, Umgebungen und Clouds hinweg, und Sie können sie so gruppieren, wie Ihr Team denkt. Die Gesundheitsbewertung jedes Clusters und aktive Alarme stehen direkt daneben. Wer mehrere Konsolen jongliert, spart mit dieser Zusammenführung am meisten Zeit.
API und MCP-Server für Entwickler
Eine vollständige REST-API und ein MCP-Server lassen Sie Pulse an Ihre Workflows, CI-Pipelines und Werkzeuge anbinden. Sie können es mit Claude Code, Codex und Cursor verbinden, damit Ihre KI-Agenten mit echten Einblicken statt mit Vermutungen über die Datenplattform nachdenken. Es erstellt außerdem Tickets aus Empfehlungen in Systemen wie GitHub und Jira.
Vor- und Nachteile
Vorteile
- Liest nur Metriken und Metadaten, Ihre echten Daten verlassen also nie Ihre Umgebung
- Empfehlungen kommen mit Begründung, und Ihr Team entscheidet, was umgesetzt wird
- Die Abfrage-Analyse benennt die konkreten Abfragen, Indizes und Mappings hinter Latenz und Kosten
- Eine Ansicht deckt alle Cluster über Clouds, Umgebungen und Teams hinweg ab
- REST-API und MCP-Server lassen Coding-Agenten mit echten Signalen arbeiten
- SOC 2 Type II zertifiziert, mit einem Collector, der nichts auf den Datenbankservern installiert
Nachteile
- Es empfiehlt Änderungen, statt sie anzuwenden, Sie brauchen also weiterhin jemanden, der sie umsetzt
- Der volle Support konzentriert sich auf Elasticsearch und OpenSearch, während ClickHouse und PostgreSQL noch in der privaten Beta sind
- Der Kostenoptimierer deckt nur Cloud-Deployments ab, selbst gehostete Setups verpassen diese Signale
- Der Preis wird pro Cluster und Monat berechnet, was sich bei vielen kleinen Clustern summiert
Häufige Fragen
Es ist eine KI-gestützte Plattform zur Überwachung und Optimierung für Elasticsearch- und OpenSearch-Cluster, gebaut von NeverBlink. Sie prüft die Cluster-Gesundheit, analysiert Abfragen, findet verschwendete Kosten und liefert priorisierte Lösungen mit der jeweiligen Begründung.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Pulse for Elasticsearch and OpenSearch.
Alternativen zu Pulse for Elasticsearch and OpenSearch

Udon
Udon · Coding · ProduktivitätUdon macht aus einem Apple-Silicon-Mac einen Heimserver, den Sie im Browser steuern, mit Containern, Dateifreigaben und einem optionalen KI-Systemadministrator.

offstage
offstage cloud · Coding · Produktivitätoffstage gibt KI-Agenten und CI-Jobs einen echten Mac: ein frisches macOS-27-Konto auf Apple Silicon, per API gesteuert und sekundengenau abgerechnet.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Coding · ProduktivitätMit BotBus lassen sich KI-Agenten vom Smartphone steuern, auch wenn der Rechner im Büro steht: Befehle freigeben, Aufgaben starten, Ergebnisse lesen.