

QAgent
QAgent Inc. · Coding · Business
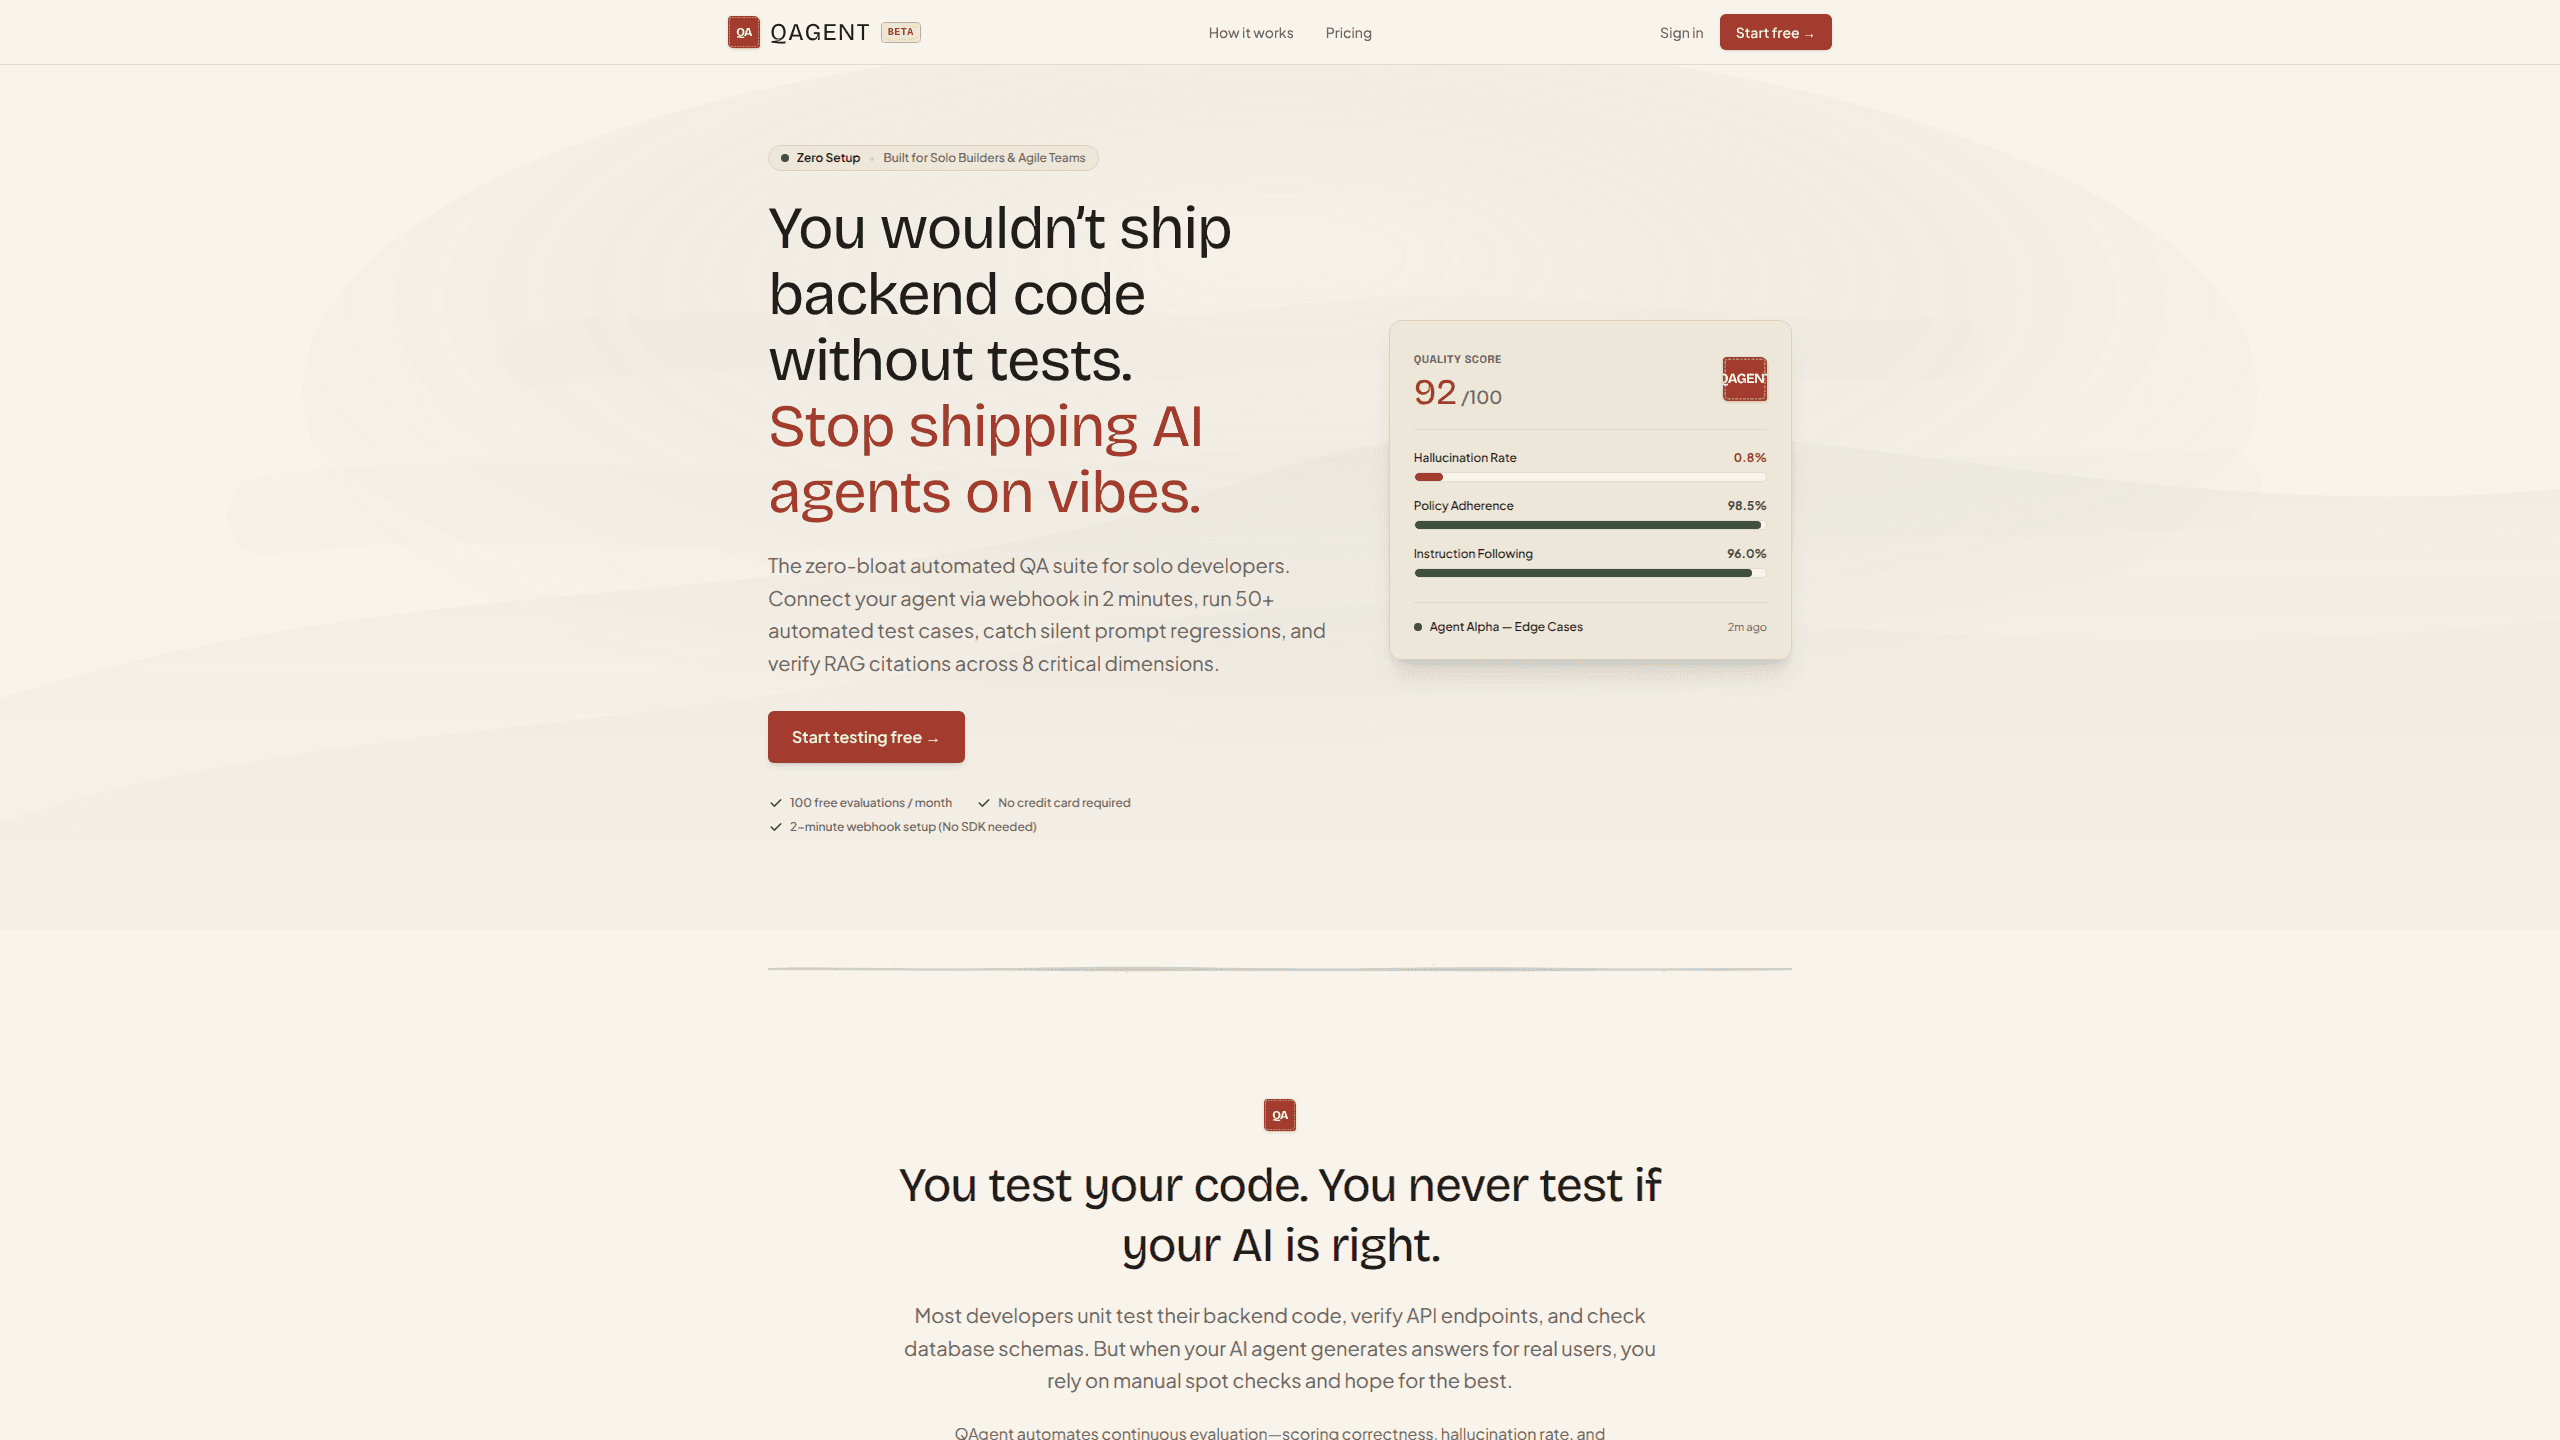
QAgent ist eine automatisierte Plattform für Qualitätssicherung von KI-Agenten. Sie richten die Plattform auf den Endpunkt Ihres Agenten, definieren die Grundwahrheit, an die er sich halten soll, und sie führt Testreihen aus, die Antwortqualität, Halluzinationsrate, Richtlinientreue und Mehrfachzug-Memory bei jedem Release bewerten. Sie funktioniert als LLM-Bewertungstool, das jeder in wenigen Minuten starten kann. Gedacht ist sie für Solo-Entwickler und kleine Teams, die Agenten ohne eigene QA-Abteilung ausliefern.
Über QAgent
Was ist QAgent
QAgent ist eine webbasierte Testplattform, die eine Frage beantwortet, die die meisten KI-Entwickler überspringen: Gibt Ihr Agent tatsächlich korrekte Antworten? Statt ein paar Antworten in einem Playground zu lesen und das Beste zu hoffen, verbinden Sie Ihren Agenten und lassen QAgent nach jeder Prompt-Änderung dieselbe Prüfreihe ausführen.
Das Produkt zielt auf eine konkrete Lücke. Entwickler testen Backend-Code mit Unit-Tests und prüfen API-Endpunkte, doch sobald ein LLM eine Antwort für einen echten Nutzer erzeugt, werden Qualitätsprüfungen zu manuellen Stichproben. Das ist ein Problem. QAgent behandelt die Agentenausgabe als etwas Testbares und bewertet sie nach Regeln, die Sie geschrieben haben, nicht nach dem, was im Moment überzeugend klingt.
Die größte Einschränkung ist der Umfang. QAgent bewertet Genauigkeit, Sicherheit und Konsistenz. Er repariert Ihre Prompts nicht für Sie, und seine Bewertung ist nur so gut wie die Grundwahrheit, die Sie ihm geben. Schreiben Sie echte Regeln. Wenn Ihre Rückerstattungsrichtlinie oder Ihre Preisstufen nicht definiert sind, hat der Richter nichts zum Abgleichen.
Erste Schritte
- Erstellen Sie ein kostenloses Konto und verbinden Sie Ihren Agenten über einen Webhook-Endpunkt, einen LangChain-Workflow oder ein einfaches HTTP-POST-Ziel.
- Definieren Sie Ihre Grundwahrheit: Preisstufen, Rückerstattungsfristen, verbotene Themen und alle Wissensdokumente, die der Agent beachten soll.
- Schreiben Sie Testrubriken, die einen Prompt mit dem erwarteten Verhalten verbinden, mit klaren Muss- und Darf-nicht-Regeln.
- Führen Sie die Reihe aus und prüfen Sie die Bewertungen bestanden oder nicht bestanden, zusammen mit schrittweisen Ursachen für jeden Fehler.
- Hängen Sie dieselbe Reihe in Ihren Release-Ablauf ein, damit Prompt-Änderungen vor dem Deploy neu bewertet werden.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von QAgent.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Solo-Entwickler
- Kleine Teams ohne eingestellte QA-Kraft
- Freelancer und Agenturen
Aufgaben
- Halluzinationen erkennen
- Prompt-Regressionen verfolgen
- RAG-Zitate prüfen
- Mehrfachzug-Memory testen
Szenarien
- Eine späte Prompt-Anpassung, um den Sonderfall eines Kunden zu beheben, gefolgt von einem vollständigen Regressionslauf in rund einer Minute.
- Einem Kunden einen KI-Chatbot übergeben und eine Scorecard beilegen, die Faktenbezug und Richtlinientreue zeigt.
- Einen Deployment-Release an die Ergebnisse der automatisierten Bewertung knüpfen statt an das Bauchgefühl.
- Angriffs-Eingaben testen, um zu bestätigen, dass der Agent an einen Menschen eskaliert, statt Rabatte zu versprechen, die er nicht geben kann.
Wichtigste Funktionen
Acht Bewertungsdimensionen
QAgent bewertet Agenten über acht getrennte Messwerte statt über einen einzigen vagen Score. Sie decken Antwortqualität, Faktenbezug, Richtlinientreue, Korrektheit der Eskalation, RAG-Treue, kontextuelle Relevanz, Kontextabruf und Mehrfachzug-Memory ab, und jede Dimension entspricht einem echten Ausfallmodus in der Produktion. Dieses Detail zählt. Eine niedrige Zahl zeigt ein konkretes Problem, nicht eine allgemeine Stimmung.
Deterministische Bewertung mit LLM als Richter
Statt Zeichenketten oder Regex-Muster abzugleichen, befragt QAgent jede Antwort mit einem kalibrierten Richter-Modell. Es läuft auf Groq-LPUs für Geschwindigkeit, was zählt, wenn Sie eine vollständige Regressionsreihe in unter einer Minute wollen. Bestanden- und Nicht-bestanden-Urteile kommen mit einem Konfidenzniveau, sodass Sie wissen, wann ein Ergebnis nah an der Grenze liegt und vor dem Vertrauen eine manuelle Prüfung verdient.
Grundwahrheit und Rubrikensystem
Jeder Test verbindet drei Zutaten: Ihre offiziellen Regeln, den Test-Prompt mit erwartetem Verhalten im Stil von RFC 2119 und die Live-Antwort des Agenten. Der Richter prüft streng gegen die Rubrik. Eine höfliche, aber falsche Antwort fällt trotzdem durch. Genau das unterscheidet QAgent von einer Bauchgefühl-Prüfung in einem Chatfenster.
Intelligente Ausnahmen für Falschmeldungen
Der Richter kennt den Unterschied zwischen einer Halluzination und normalem Verhalten. Ticket-IDs, die sich pro Sitzung ändern, Live-Kontostände und höfliche Begrüßungen werden nicht als unbelegte Aussagen markiert. Gut. Enthält der am besten bewertete Abschnitt die vollständige Antwort, ziehen niedriger eingestufte Ergebnisse den Score nicht nach unten. Jailbreak-Tests bestrafen den Abrufer nicht für fehlende Angriffsdokumente.
Prompt-Regressionsverfolgung
QAgent erfasst Score-Abweichungen bei jeder Prompt-Iteration. Sie sehen sofort, ob eine Änderung, die einen Fall behoben hat, an anderer Stelle einen Rückgang verursacht hat. Das ist der ganze Sinn. Für Teams, die System-Prompts oft bearbeiten, macht das eine stille Verschlechterung zu einer sichtbaren Linie in einem Diagramm.
Qualitätsaudit-Berichte
Der Solo-Plan exportiert CSV und druckfertige Qualitätsaudit-Berichte. Sie zeigen Faktenbezug in Prozent, RAG-Treue und Richtlinientreue, was nützlich ist, wenn ein Kunde Belege statt eines Versprechens will. Senden Sie die Datei. Berichte machen aus einem Testlauf etwas, das Sie einer Projektübergabe beilegen können.
Vor- und Nachteile
Vorteile
- Die Webhook-Einrichtung dauert etwa zwei Minuten, ohne SDK zum Installieren oder Code zum Schreiben.
- Acht benannte Dimensionen geben konkretes Feedback statt eines einzigen gemischten Scores.
- Die kostenlose Stufe mit 100 Bewertungen pro Monat erleichtert das Ausprobieren vor dem Bezahlen.
- Eine transparente Prüfspur zeigt Abfrage, Rubrik, Antwort und Befunde des Bewerters für jeden Test.
- Fester Monatspreis ohne Jahresbindung oder Vertriebsgespräche.
Nachteile
- Ein verbundener Agenten-Endpunkt in der kostenlosen Stufe, sodass das Testen mehrerer Agenten den Bezahlplan erfordert.
- Die Bewertung hängt völlig von der Grundwahrheit ab, die Sie bereitstellen; vage Regeln erzeugen vage Ergebnisse.
- Die Plattform ist noch in der Beta, sodass sich Funktionen und Limits ändern können.
Häufige Fragen
Er testet, ob Ihr KI-Agent korrekte, richtlinienkonforme Antworten gibt. Das umfasst Halluzinationserkennung, Befolgen von Anweisungen, RAG-Treue, Eskalationsverhalten und Mehrfachzug-Memory, bewertet über acht Dimensionen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu QAgent.
Alternativen zu QAgent
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.