
Scrapeless
Scrapeless · Coding
Scrapeless ist eine Cloud-Plattform für Web-Scraping und Browser-Automatisierung. Die Web-Scraping-API bündelt Anti-Detection-Browser, Unlocker-API, Residential-Proxys und strukturierte Scraper in einem Toolkit für KI-Agenten und Datenteams.
Über Scrapeless
What Is Scrapeless
Scrapeless ist eine verwaltete Plattform für Webdaten. Statt eigene Headless-Browser, Proxy-Pools und CAPTCHA-Solver zu betreiben, schicken Sie eine URL oder starten eine Cloud-Browser-Sitzung über eine einzige API. Den Rest erledigt der Dienst im Hintergrund: Bot-Erkennung, IP-Rotation, JavaScript-Rendering und CAPTCHA-Herausforderungen.
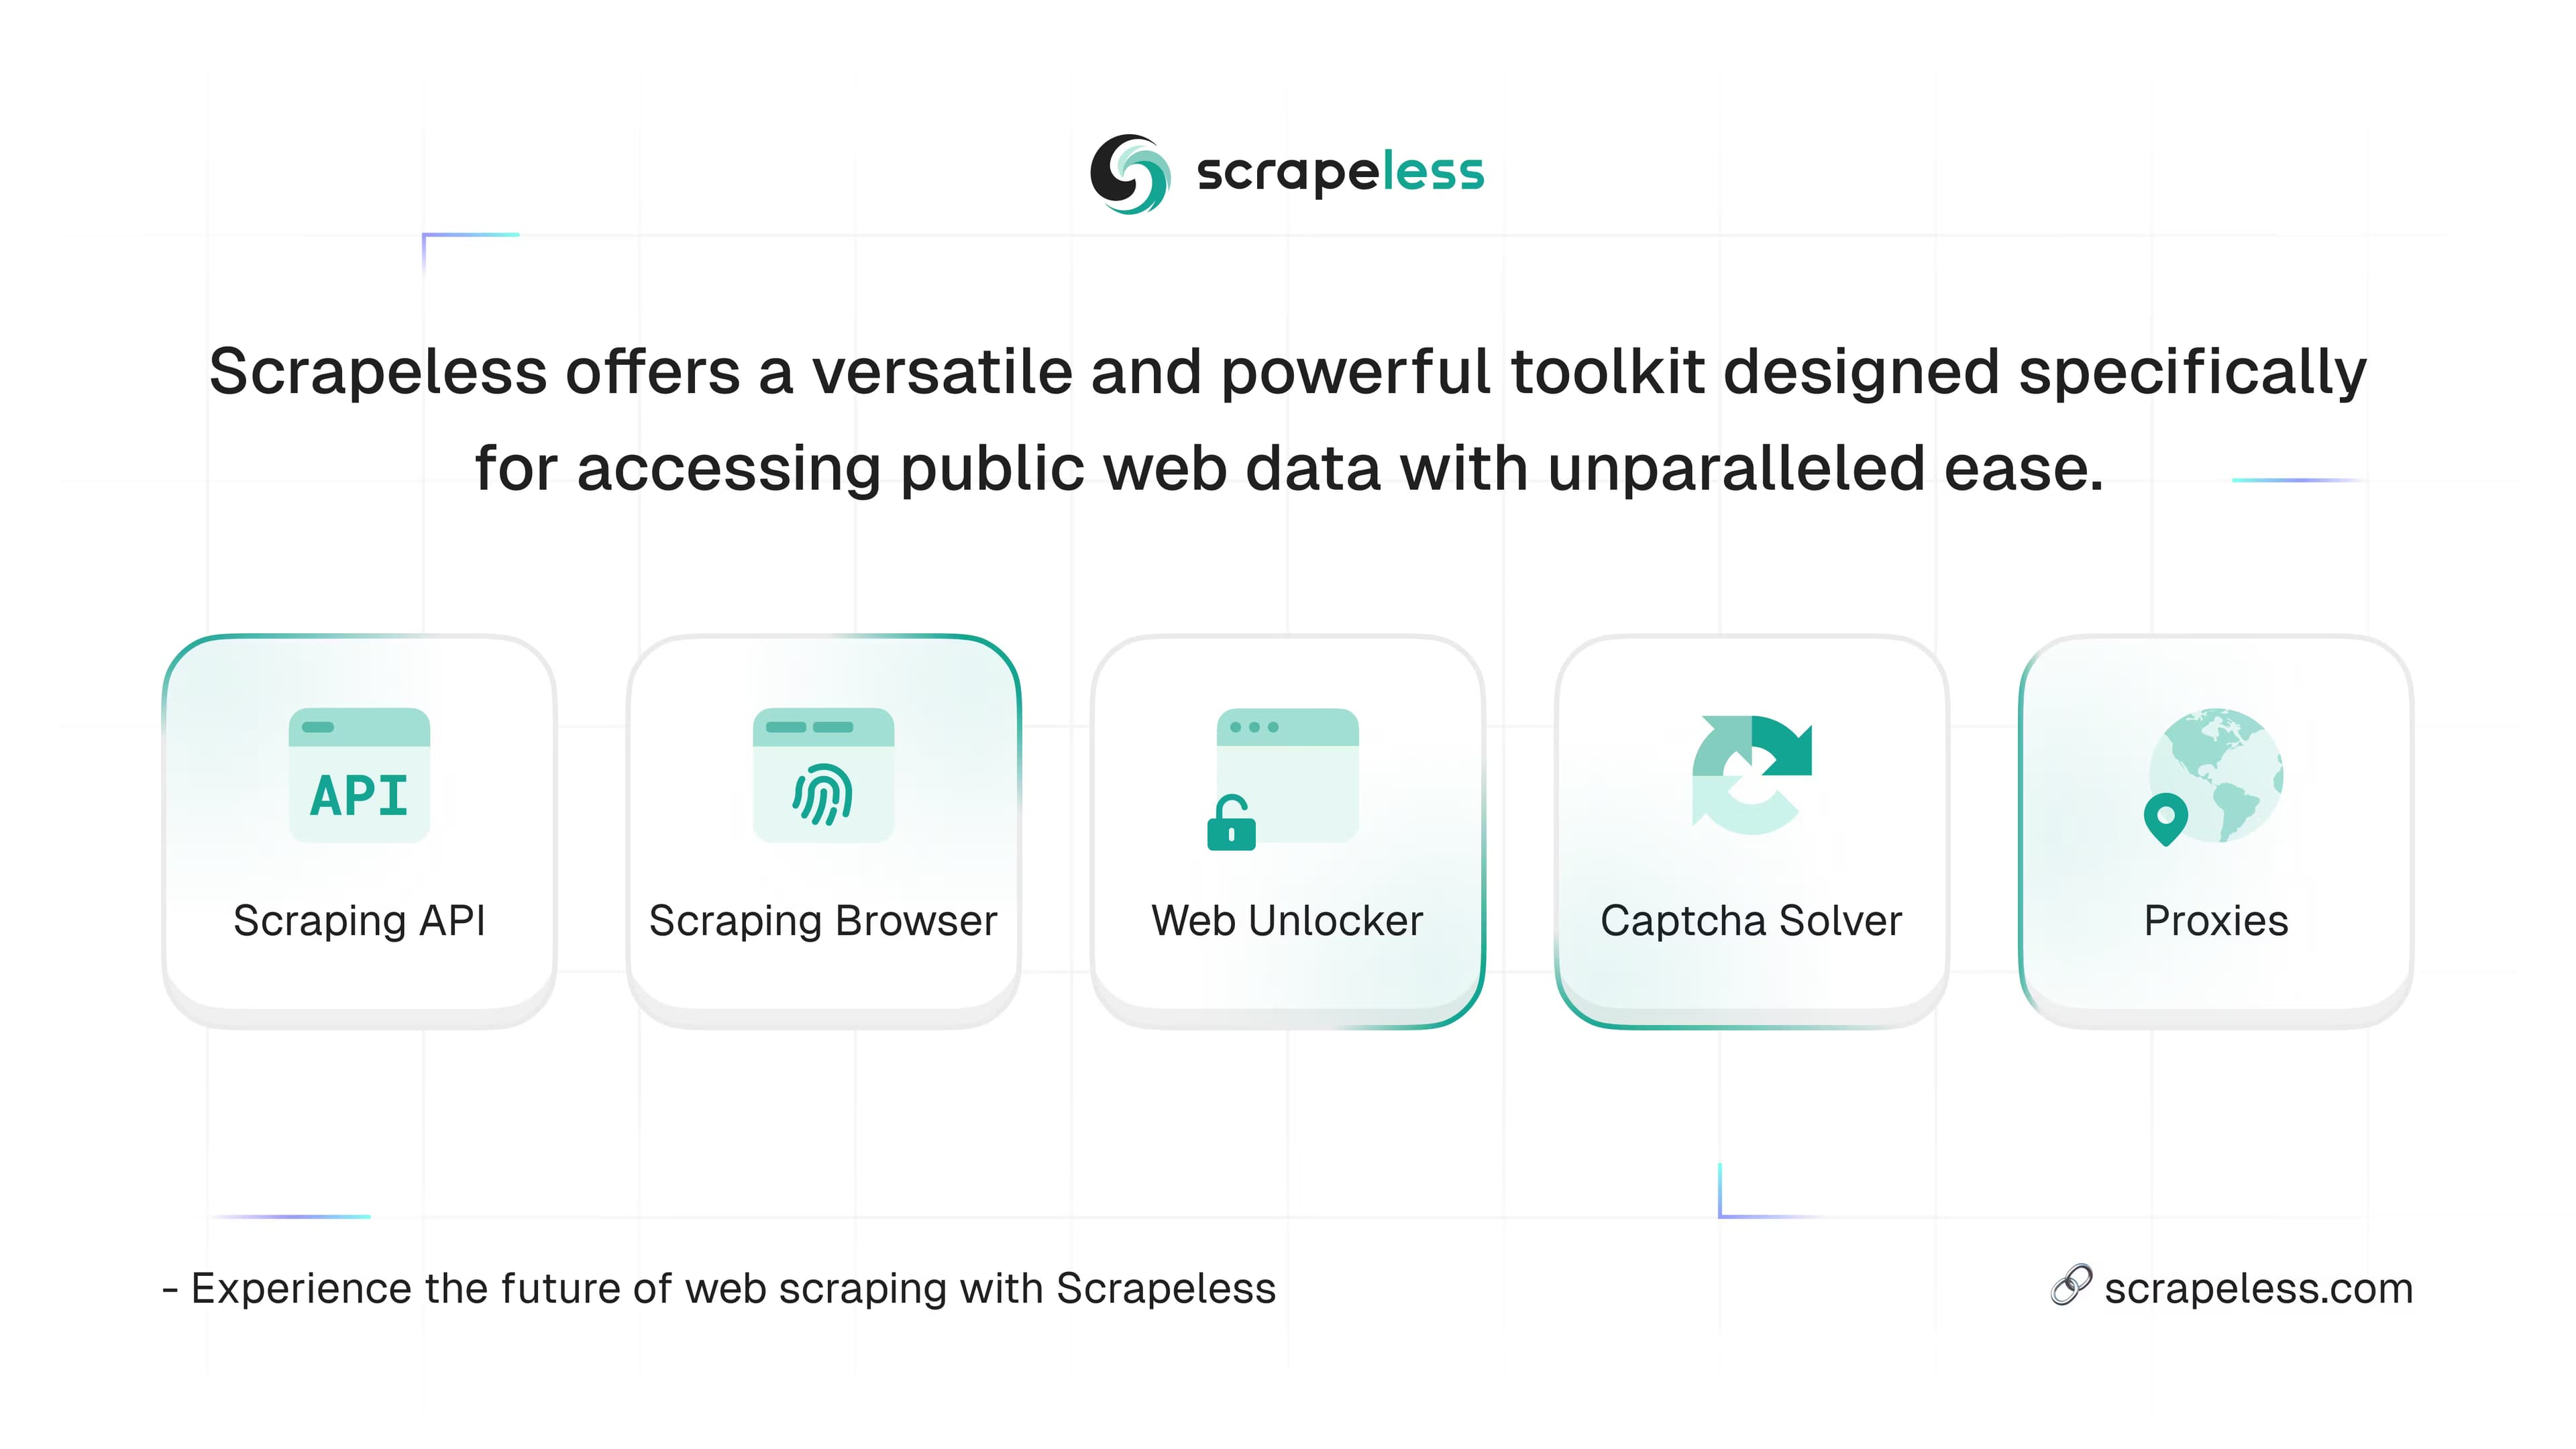
Die Produktlinie deckt mehrere Aufgaben ab. Agent Browser gibt KI-Agenten einen echten Cloud-Browser zum Navigieren, Klicken und Ausfüllen von Formularen. Web Unlocker holt Inhalte von Seiten, die durch Cloudflare, DataDome oder AWS WAF geschützt sind. AI Scraper sammelt Antworten und Zitate von Engines wie ChatGPT, Perplexity und Gemini. Für Google Search, Amazon und TikTok gibt es eigene Scraper. Crawl verwandelt ganze Websites in Markdown oder HTML für RAG-Pipelines, und Proxys liefern geolokalisierte IPs für den eigenen Stack.
Die größte Einschränkung liegt in der Zielgruppe. Scrapeless richtet sich an Entwickler und Datenteams, deshalb brauchen Sie etwas Code oder eine Integration wie n8n oder Make, um wirklich etwas damit anzufangen. Der Preis richtet sich nach Nutzung, was kleine Jobs günstig macht, bei sehr großen Crawls aber ins Geld gehen kann.
Getting Started
- Registrieren Sie sich im Scrapeless-Dashboard. Neue Konten bekommen 5 Dollar Guthaben gratis, ohne Kreditkarte.
- Kopieren Sie Ihren API-Schlüssel aus dem Dashboard und halten Sie ihn geheim.
- Wählen Sie das Produkt, das zu Ihrer Aufgabe passt, etwa Agent Browser, Web Unlocker oder die Scraping API.
- Senden Sie eine Testanfrage über die REST-API, ein SDK in Python, Node oder Go oder den MCP-Server.
- Prüfen Sie das zurückgegebene HTML, JSON oder Markdown und binden Sie es in Ihre Pipeline ein.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Scrapeless.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Data Engineers
- KI-Agent-Entwickler
- SEO- und Growth-Teams
- E-Commerce-Analysten
Aufgaben
- JavaScript-lastige Seiten scrapen
- Anti-Bot-Abwehr umgehen
- Korpus für RAG aufbauen
- Markensichtbarkeit in der KI überwachen
Szenarien
- Lange Agenten-Workflows ausführen
- Sammlung mit hohem Volumen
- Einmalige Recherche
Wichtigste Funktionen
Agent Browser mit Tarnung auf Engine-Ebene
Agent Browser ist ein Cloud-Browser, der einen Standard-CDP-Endpunkt per WebSocket bereitstellt, sodass Ihr bestehendes Puppeteer- und Playwright-Code mit einer geänderten Zeile läuft. Die Anti-Detection steckt in einer eigens gebauten Browser-Engine, nicht in einem Plugin. Das umfasst TLS- und JA3-Fingerabdrücke, Canvas- und WebGL-Rauschen, Randomisierung des Audio-Kontexts und das Blockieren von WebRTC-IP-Lecks.
Eingebautes CAPTCHA-Lösen
reCAPTCHA-, Cloudflare-Turnstile- und AWS-WAF-Herausforderungen werden automatisch in der Sitzung gelöst. Scrapeless gibt an, dass sein Solver gängige CAPTCHA-Typen zu 98 % oder mehr löst, im Schnitt in unter zwei Sekunden. Er ist kostenlos dabei, kein separater bezahlter Solver.
Web-Unlocker-API
Web Unlocker nimmt eine URL und liefert sauberes HTML, JSON, Markdown oder einen Screenshot zurück, womit Sie strukturierte Datenextraktion ohne Parsing-Aufbau bekommen. Er erkennt das Anti-Bot-System, rotiert die IP, rendert JavaScript und versucht es selbst erneut. Abgerechnet wird nur die erfolgreiche Anfrage, fehlgeschlagene Versuche kosten nichts.
Netzwerk aus Residential-Proxys
Jedes Produkt stützt sich auf ein Netzwerk aus Residential-Proxys in 195 Ländern, mit Ausrichtung auf Bundesstaat und Stadt sowie festen Sitzungen für zustandsbehaftete Crawls. Scrapeless nennt vier Proxy-Typen: Residential, statisches ISP, Rechenzentrum und IPv6.
Persistente Sitzungen und Live View
In der Cloud gespeicherte Profile bleiben über Läufe hinweg angemeldet und ersparen wiederholte Anmeldungen bei langen Jobs. Live View überträgt das DOM der Sitzung in unter 100 Millisekunden, und Session Replay spielt die Frames samt Netzwerk- und Konsolen-Logs ab, sodass Sie sehen, was ein Agent beim Fehlschlag gefunden hat.
MCP-Server und SDKs für mehrere Sprachen
Ein nativer MCP-Server stellt Browser-Aktionen, Scraping und Suche als Werkzeuge bereit, die Clients wie Claude Code, Cursor und Cline aufrufen können. Für tiefergehende Integration decken offizielle SDKs Python, Node mit TypeScript und Go ab, mit eigenen Konnektoren für n8n, Make, LangChain und Dify.
Vor- und Nachteile
Vorteile
- Eine Plattform deckt Cloud-Browsing, Unlocking, Proxys, Crawling und strukturierte Scraper ab, sodass Sie nicht mehrere Anbieter zusammenstückeln müssen.
- Nutzungsbasierter Preis mit 5 Dollar Gratisguthaben und ohne Kreditkarte zum Start.
- CAPTCHA-Lösen und Residential-Proxys sind eingebaut, nicht als separate bezahlte Extras.
- Ihr bestehender Puppeteer- und Playwright-Code verbindet sich über einen Standard-CDP-Endpunkt.
Nachteile
- Es ist vor allem ein Entwicklerwerkzeug. Ohne Code brauchen Sie eine Integration wie n8n oder Make, um etwas Nützliches zu tun.
- Die nutzungsbasierten Kosten können bei sehr großen Crawls schnell steigen, daher sollten Sie den Guthabenverbrauch im Blick behalten.
- Manche Erfolgs- und Geschwindigkeitszahlen stammen von Scrapeless selbst und sind nicht unabhängig geprüft.
- Das Produktspektrum ist breit, was Einsteigern die Wahl des richtigen Startpunkts erschwert.
Häufige Fragen
Scrapeless sammelt öffentliche Webdaten und führt Browser-Automatisierung in der Cloud aus. Teams nutzen es, um geschützte Seiten zu scrapen, RAG-Pipelines zu füttern, KI-Suchergebnisse zu überwachen und KI-Agenten einen echten Browser zu geben.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Scrapeless.
Alternativen zu Scrapeless
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.