
SemanticGuard
SemanticGuard · Coding
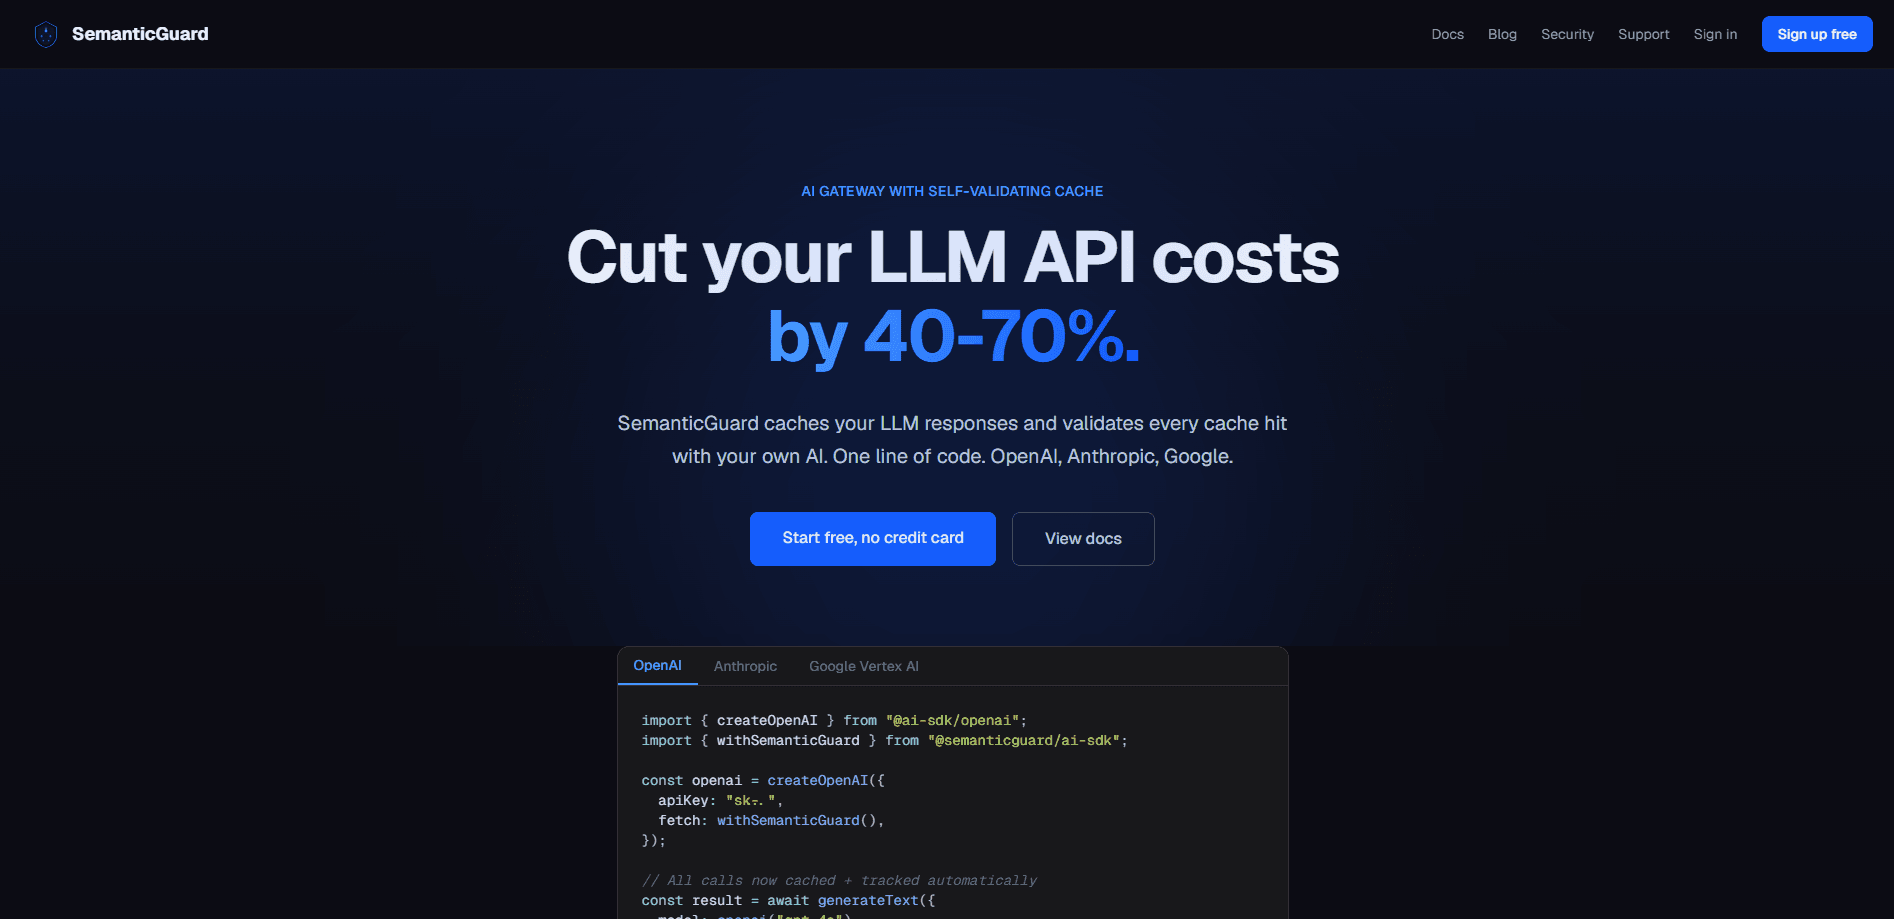
SemanticGuard ist ein KI-Gateway, das zwischen Ihrer App und den LLM-Anbietern sitzt, die Sie bereits nutzen. Es erledigt zwei Aufgaben zugleich: Es speichert Antworten zwischen, damit Sie für wiederkehrende Fragen nicht mehr den vollen Preis zahlen, und es prüft und steuert die Tool-Aufrufe, die Ihre KI-Agenten ausführen. Der Anbieter meldet in seinem eigenen Benchmark eine mittlere Ersparnis von 50 % bei den LLM-Ausgaben, mit einer kostenlosen Stufe für 10K Anfragen im Monat und einem Pro-Tarif für 49 $/Monat.
Über SemanticGuard
Was ist SemanticGuard
SemanticGuard ist ein OpenAI-kompatibler Proxy mit einem selbstvalidierenden semantischen Cache. Richten Sie Ihren Client darauf statt auf den Anbieter, fügen Sie einen SG-API-Schlüssel ein, und jede Anfrage wird zwischengespeichert, protokolliert und verfolgt. Der Verkaufsargument? Der Cache traut sich selbst nicht. Eine zweite Schicht prüft Treffer mit Ihrer eigenen KI, bevor sie ausgeliefert werden, sodass eine Paraphrase, die nahe an einer alten Anfrage liegt, nicht stillschweigend die falsche Antwort liefert.
Die andere Hälfte ist die Governance von KI-Agenten. Jeder Tool-Aufruf, den Ihr LLM ausgibt, erscheint in einem Aktivitätsfeed mit Name, Argumenten, Modell und Sitzungszuordnung. Ein Klassifikator bewertet jeden Aufruf als Lesen, Schreiben oder destruktiv. Eine Regel-Engine erlaubt, verweigert oder markiert ihn dann zur Freigabe. Das fängt den klassischen Fehler ab, bei dem ein harmlos wirkendes run_shell heimlich ein rm -rf verpackt, oder ein Agent versucht, direkt auf main zu pushen.
Der Haken: Das ist Infrastruktur, keine Verbraucher-App. Sie brauchen einen Ort zum Ausführen, API-Schlüssel zum Verwalten und zumindest ein klares Gefühl dafür, wie Ihr LLM-Datenverkehr fließt. Das Caching setzt zudem echte Wiederholung in Ihrem Datenverkehr voraus; eine App mit geringem Volumen und jedes Mal einzigartigen Prompts wird wenig Nutzen sehen. Der Schattenmodus existiert, damit Sie Ihre eigene Ersparnis messen, bevor Sie einen Dollar ausgeben.
Erste Schritte
- Melden Sie sich bei semanticguard.dev an und erstellen Sie einen API-Schlüssel im Dashboard. Für die kostenlose Stufe ist keine Kreditkarte nötig.
- Aktivieren Sie zuerst den Schattenmodus. Er protokolliert jede Anfrage und zeigt, was Sie sparen würden, bevor überhaupt eine zwischengespeicherte Antwort ausgeliefert wird.
- Leiten Sie Ihren Datenverkehr durch den Proxy. Setzen Sie entweder
ANTHROPIC_BASE_URLfür Claude Code, oder fügen Sie den fetch-Wrapper des AI SDK mit Ihrem SG-Schlüssel zu Aufrufen an OpenAI, Anthropic, Google, Azure, Bedrock oder Mistral hinzu. - Prüfen Sie das Dashboard, bis Sie sich mit der prognostizierten Ersparnis wohlfühlen, und aktivieren Sie dann das Caching und legen Sie Ihre Regeln für destruktive Tool-Aufrufe fest.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von SemanticGuard.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Entwickler, die LLM-Kosteneinsparungen suchen
- Engineering-Teams, die Governance von KI-Agenten nutzen
Aufgaben
- LLM-API-Ausgaben senken
- Tool-Aufrufe von Agenten prüfen
- Destruktive Agentenaktionen blockieren
Szenarien
- Produktionsagenten, die Live-Systeme berühren
- Multi-Anbieter-Setups
- Teams, die einen einzigen Claude Code Proxy wollen
Wichtigste Funktionen
Selbstvalidierender semantischer Cache
Der Cache gleicht nach Bedeutung ab, nicht nur nach Wortlaut, sodass eine umformulierte Frage trotzdem treffen kann. Was ihn unterscheidet, ist die Validierungsschicht: Treffer werden mit mehrschichtiger Prüfung und fortlaufender, von KI beurteilter Stichprobenahme geprüft, sodass Korrektheit als etwas gilt, das zu beweisen ist, nicht anzunehmen. Der Anbieter behauptet 100 % Cache-Korrektheit in seinem öffentlichen Benchmark, und anbieterübergreifendes Caching bedeutet, dass die Antwort eines Modells eine Paraphrase bedienen kann, die auf ein anderes zielt.
Governance der Tool-Aufrufe von Agenten
Jeder Tool-Aufruf, den Ihr LLM ausgibt, landet in einem Aktivitätsfeed mit Tool-Name, Argumenten, Modell und vollständiger Sitzungszuordnung. Ein deterministischer Klassifikator bewertet jeden Aufruf als Lesen, Schreiben oder destruktiv. Wenn Sie bereits über SemanticGuard leiten, funktioniert das ohne Codeänderungen.
Regel-Engine mit Freigaberegeln
Sie legen fest, was läuft und was nicht, nach Muster, Risikostufe, Workspace oder Nutzer. Sinnvolle Standardwerte sind ab Tag eins dabei: destruktive Aufrufe in prod verweigern, Freigabe für Deploys verlangen, PRs auf main blockieren. Regeländerungen erscheinen in Sekunden in der Audit-Spur.
AI-SDK-Integration in einer Zeile
Fügen Sie einen fetch-Wrapper mit dem Vercel AI SDK zu jedem Anbieter hinzu. Es funktioniert mit OpenAI, Anthropic, Vertex AI und allem anderen, das eine eigene fetch-Funktion akzeptiert. Für Claude Code und andere Clients des Anthropic-SDK leitet eine einzige Umgebungsvariable den Datenverkehr durch das Gateway, inklusive Kostenverfolgung, Audit und Schwärzung personenbezogener Daten.
Schattenmodus
Bevor Sie dem Cache vertrauen, protokolliert der Schattenmodus alles und meldet, was Sie gespart hätten, ohne eine einzige zwischengespeicherte Antwort auszuliefern. Das ist der ehrliche Weg herauszufinden, ob sich Ihr Datenverkehr genug wiederholt, um den Wechsel zu rechtfertigen. Die kostenlose Stufe ist darum herum gebaut, ohne Kreditkarte.
Selbst gehostete Bereitstellung in Ihrem eigenen Tenant
Die Installation aus dem Vercel Marketplace stellt den Proxy in Ihrem eigenen Vercel-Konto bereit, gestützt auf Ihr Neon Postgres, Upstash Redis und Upstash Vector. Prompts, Antworten, Embeddings und Cache-Inhalte verlassen nie Ihren Tenant; nur Lizenz, API-Schlüsselvalidierung und ein Health-Heartbeat erreichen die Steuerungsebene von SemanticGuard.
Observability und Steuerung pro Tenant
Das Dashboard deckt Kostenanalyse und Tracing pro Anfrage ab, mit einem Prometheus-Endpoint für Teams, die Metriken in ihren eigenen Stack leiten. Jeder Tenant bekommt seinen eigenen Kill-Switch und Audit-Log.
Vor- und Nachteile
Vorteile
- Finanziert seine eigenen Kosten durch die LLM-Ausgaben, die es einspart, statt eine separate Position hinzuzufügen.
- Anbieterübergreifendes Caching ist wirklich ungewöhnlich; die nativen Caches von OpenAI und Anthropic bleiben jeweils in ihren eigenen Modellen.
- Governance kommt über eine Umgebungsvariable oder einen fetch-Wrapper, sodass die Einführung kein Umschreiben des Agenten erfordert.
- Die selbst gehostete Option hält Prompts, Antworten und Embeddings in Ihrem eigenen VPC.
- Die Korrektheitsvalidierung mit von KI beurteilter Stichprobenahme adressiert die Hauptangst, die Menschen vor semantischem Caching haben.
Nachteile
- Die Ersparnis hängt davon ab, dass sich Ihr Datenverkehr wiederholt; einzigartige Prompts ohne Überschneidung zeigen wenig Nutzen, sodass der Schattenmodus ein Pflichtschritt ist.
- Der Enterprise-Tarif wird mit 15 % der dokumentierten Ersparnis und einem Mindestbetrag von 500 $/Monat abgerechnet, was schwerer vorherzusagen ist als eine Pauschale.
- Einige Governance-Bausteine, wie der Freigabe-Posteingang mit Mensch in der Schleife und der Proxy der MCP-Schicht, stehen noch auf der Roadmap.
- Die 10K Anfragen/Monat der kostenlosen Stufe sind für Teams, die in echtem Volumen testen, schnell aufgebraucht.
Häufige Fragen
Es ist ein KI-Gateway mit zwei Hälften. Die eine speichert LLM-Antworten zwischen, um API-Kosten zu senken, und die andere prüft und steuert die Tool-Aufrufe, die Ihre Agenten ausführen. Sie leiten Ihren bestehenden LLM-Datenverkehr hindurch, und beide Funktionen laufen auf denselben Anfragen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu SemanticGuard.
Alternativen zu SemanticGuard
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.