

Serpex.dev
Serpex.dev · Coding
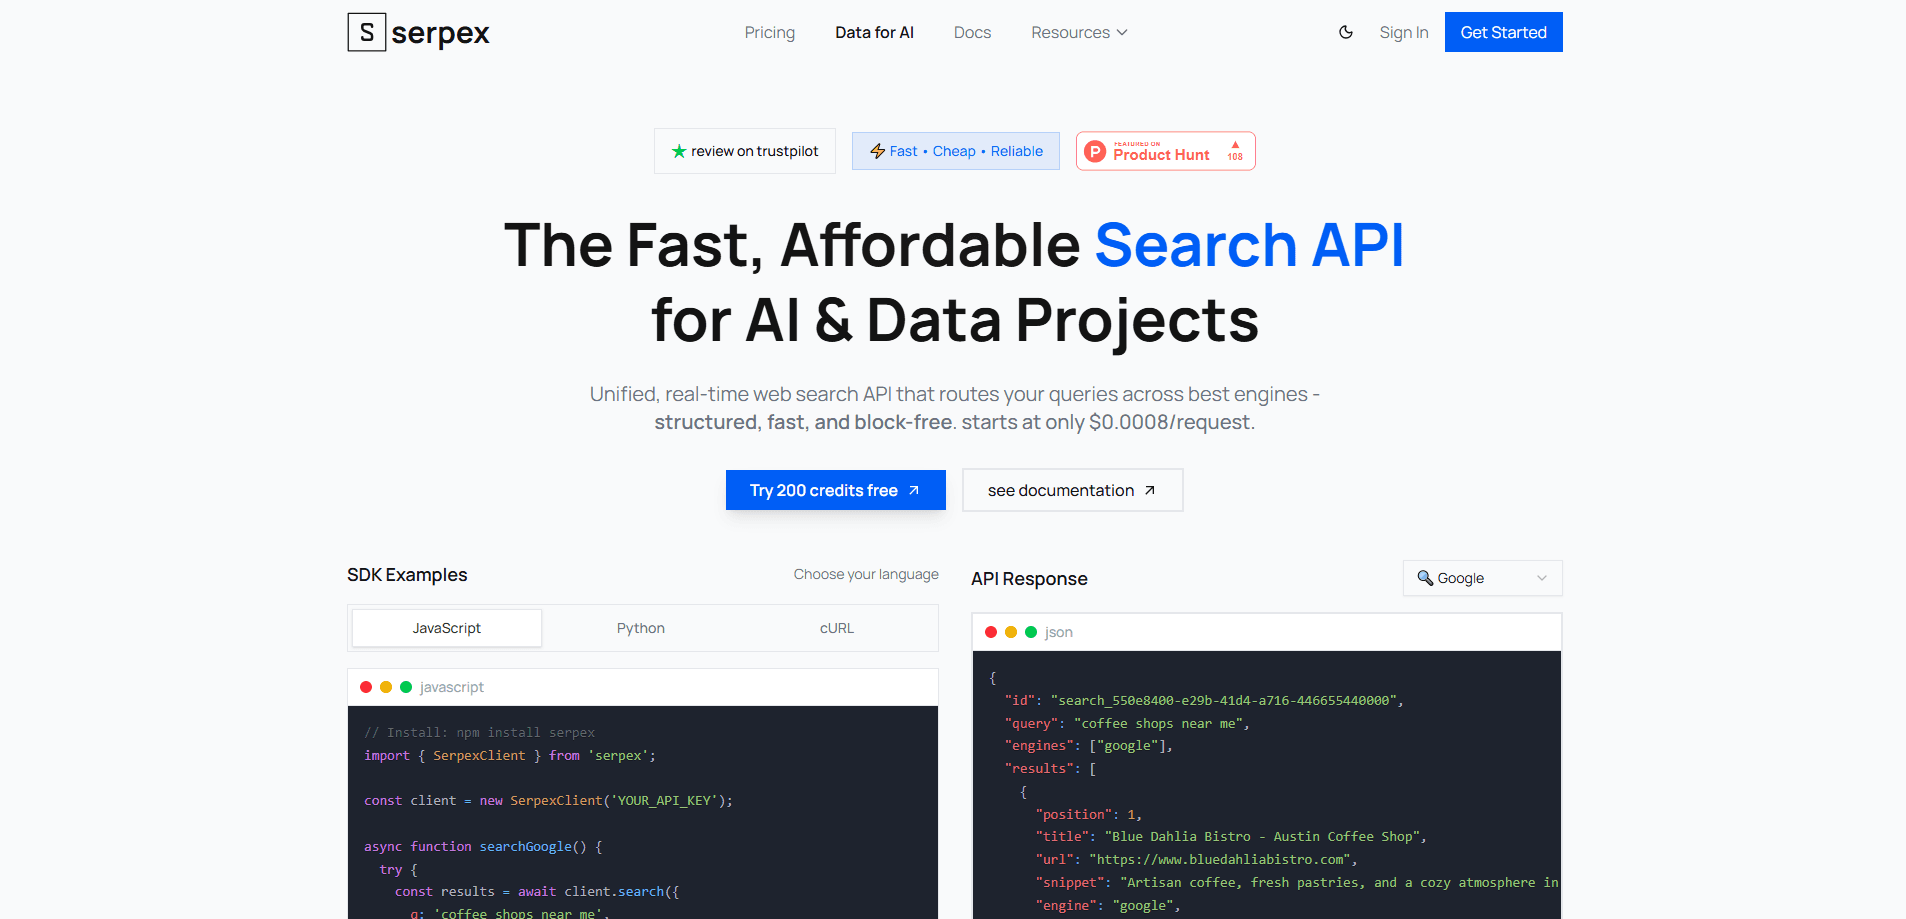
Serpex.dev ist eine Such- und Extraktions-API für Entwickler. Sie liefert strukturierte Web-Ergebnisse und den sauberen Inhalt einer Seite in einem einzigen Aufruf. Sie richtet sich an KI-Agenten, RAG-Pipelines und Datenprojekte, die frische Web-Daten brauchen, ohne eigene Browser oder Scraper zu betreiben. Anfragen starten bei rund 0,0008 $ pro Stück, und bezahlt werden nur erfolgreiche Aufrufe.
Über Serpex.dev
Was ist Serpex.dev
Serpex.dev ist eine Websuche-API für alle, die Live-Daten aus dem Internet in Software einbinden. Sie senden eine Suchanfrage und bekommen geordnete Ergebnisse in JSON zurück: Titel, URLs, Snippets, Positionen und die Engine, die geantwortet hat. Sie senden eine Liste von URLs und erhalten den Seiteninhalt als Markdown oder HTML, bereits bereinigt.
Den Dienst gibt es, weil es ein aussichtsloses Unterfangen ist, KI-Systeme auf veralteten Trainingsdaten zu gründen. Wer einen Agenten baut, der die heutigen Preise braucht, oder eine RAG-Datenaufnahme, die zitieren soll, was im Web tatsächlich steht, für den ist eigenes Scraping eine Arbeit ohne Ende. Und was heißt das für die Person, die alles verkabelt? Der Browser, der Proxy-Pool und die Retry-Logik, die man sonst selbst schreiben und pflegen würde, sitzen hinter dem Endpunkt eines anderen, und die eigene Aufgabe schrumpft darauf, eine Anfrage zu formatieren und eine JSON-Liste zurückzulesen.
Die wichtigste Grenze ist der Umfang. Das ist Infrastruktur für Entwickler, kein Dashboard für gelegentliches Suchen. Sie brauchen einen API-Schlüssel, etwas Code und ein Gefühl dafür, wie viele Anfragen Ihre App abschicken wird. Die Extraktion ist zudem auf 10 URLs pro Anfrage begrenzt, große Crawls brauchen also Stapelverarbeitung. Seiten hinter starkem Anti-Bot-Schutz können trotzdem scheitern. Fehlgeschlagene Stealth-Anfragen sind kostenlos, eine blockierte Seite zehrt also nicht am Guthaben.
Erste Schritte
- Registrieren Sie sich bei app.serpex.dev und sichern Sie sich die 200 Gratis-Credits, die ein neues Konto mitbringt.
- Erzeugen Sie einen API-Schlüssel im Dashboard und speichern Sie ihn als
sk_...auf Ihrem Server, niemals im clientseitigen Code. - Senden Sie Ihre erste Anfrage mit einem POST an
https://api.serpex.dev/api/search, übergeben Sie eine Suchanfrage wie{"q": "openai gpt-4o"}und Ihren Bearer-Token im Header. - Für Seiteninhalte rufen Sie
POST /api/crawlmit einer Liste von URLs auf und fügen"stealth": truehinzu, wenn eine Seite normale Anfragen blockiert. - Lesen Sie die JSON-Antwort und speisen Sie die Ergebnisse in Ihren Agenten, Ihre Vektordatenbank oder Ihre Reporting-Pipeline ein.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Serpex.dev.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI- und Backend-Entwickler
- Datenteams, die RAG-Pipelines bauen
- SEO- und Marktforscher
Aufgaben
- LLM-Antworten fundieren
- Inhaltsaufnahme
- Wettbewerbsbeobachtung
Szenarien
- Sie prototypen einen Recherche-Agenten und wollen weder Proxies noch Headless-Browser verwalten.
- Sie brauchen einen günstigen Weg, um für einen Analyse-Job Tausende Anfragen zu fahren, ohne Unternehmensverträge.
- Eine Seite blockiert normales Scraping, und Sie brauchen einen Ausweg, der den Anti-Bot-Schutz umgeht.
Wichtigste Funktionen
Vereinheitlichte Suche und Extraktion
Die meisten Such-APIs enden auf der Ergebnisseite. Serpex geht einen Schritt weiter. Sie können Ergebnisse abfragen und dann den vollständigen Inhalt hinter jedem einzelnen aus demselben Dienst ziehen, mit demselben Schlüssel und demselben Guthaben. Das bedeutet eine Integration weniger zu bauen und eine Rechnung weniger am Monatsende abzugleichen. Für eine RAG-Pipeline spart das echte Einrichtungsarbeit.
Strukturierte JSON-Antworten
Suchaufrufe liefern Felder für Titel, URL, Snippet, Position und Engine in einer vorhersehbaren JSON-Form. Sie kommen als einfaches Array, über das Sie iterieren, filtern oder speichern können, ohne eine Zeile Code zum Parsen von HTML zu schreiben oder einen Headless-Browser auf Ihren Servern am Leben zu halten. Genau diese Struktur lässt Sie Ergebnisse ordnen, filtern und ablegen, ohne improvisierte Scraping-Logik.
Stealth-Modus für blockierte Seiten
Manche Seiten wehren sich gegen automatisierten Zugriff. Ein stealth: true in einer Crawl-Anfrage leitet sie durch ein Setup, das starken Anti-Bot-Schutz überwindet, abgerechnet mit fünf Credits pro URL. Fehlgeschlagene Stealth-Anfragen kosten nichts, eine blockierte Seite leert also nicht Ihr Guthaben. Denken Sie daran als Web-Scraping-API mit einem Umgehungsschalter für die hartnäckigen Seiten.
Multi-Engine-Routing
Eine Auto-Routing-Schicht wählt die Engine für jede Anfrage, statt Sie pro Aufruf eine wählen zu lassen. Ergebnisse kommen mit der Engine gekennzeichnet zurück, die geantwortet hat. Dieses Kennzeichen hilft, wenn Sie vergleichen wollen, wie verschiedene Quellen dieselbe Anfrage ordnen.
Krypto-freundliches Credit-Modell
Credits verfallen nie, und Sie können sie nutzungsbasiert oder als einmaliges Paket kaufen. Keine Abo-Bindung. Eine fehlgeschlagene Anfrage wird nicht berechnet, und die Gratisstufe startet Sie bei 200 Credits, ein reibungsarmer Weg, den Dienst vor einer Festlegung zu testen.
Erschwingliche Preisstufen
Der Preis der Such-API sinkt mit wachsendem Volumen: rund 0,80 $ pro 1.000 Anfragen bei Starter, 0,65 $ bei Standard und 0,50 $ bei Scale. Stealth-Extraktion läuft je nach Stufe bei rund 4,00 $, 3,25 $ und 2,50 $ pro 1.000. Das ist das Hauptargument, und es hält gut stand gegen teurere SERP-API-Optionen am Markt.
Globales Proxy-Netzwerk und Nebenläufigkeit
Jede Stufe läuft auf einem globalen Proxy-Netzwerk mit 99,7 % Verfügbarkeit und Schutz gegen Ratenlimits. Die Nebenläufigkeit skaliert mit Ihrem Plan, Sie können also 10 parallele Anfragen bei Starter, 50 bei Standard und bis zu 100 bei Scale fahren, mit individuellen Obergrenzen für Unternehmenskonten, die Tausende gleichzeitige Aufrufe brauchen.
Analytik und Support
Das Dashboard berichtet detaillierte Nutzungsanalytik, damit Sie sehen, wohin die Credits gehen, und der Support ist rund um die Uhr per Chat und E-Mail erreichbar. Bei einem pro Anfrage abgerechneten Dienst zählt es, genau zu wissen, was Ihr Guthaben verbraucht hat.
Vor- und Nachteile
Vorteile
- Suche und Seitenextraktion stecken in einer API, Sie sparen sich also einen zweiten Scraping-Anbieter.
- Der Preis pro Anfrage von rund 0,0008 $ hält große Suchvolumen günstig.
- Fehlgeschlagene Stealth-Anfragen sind kostenlos, das mildert die Kosten blockierter Seiten.
- Credits verfallen nie, und es gibt keine Abo-Bindung.
- 200 Gratis-Credits machen das Testen vor dem Bezahlen leicht.
Nachteile
- Kein Browser-Dashboard für gelegentliches Suchen. Sie brauchen Code und einen API-Schlüssel.
- Crawl-Anfragen sind auf 10 URLs begrenzt, große Jobs brauchen also Stapelverarbeitung.
- Der Stealth-Modus kostet das Fünffache des normalen Tarifs, was sich auf geschützten Seiten summiert.
Häufige Fragen
Serpex.dev gibt Entwicklern einen schnellen Weg, Live-Websuchergebnisse und Seiteninhalte in eine Anwendung zu holen. Am häufigsten kommt es in KI-Agenten, RAG-Pipelines und Datenprojekten vor, die aktuelle Informationen statt des eingebauten Modellwissens brauchen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Serpex.dev.
Alternativen zu Serpex.dev
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.