
Soup CLI
MePlay, Inc. · Coding
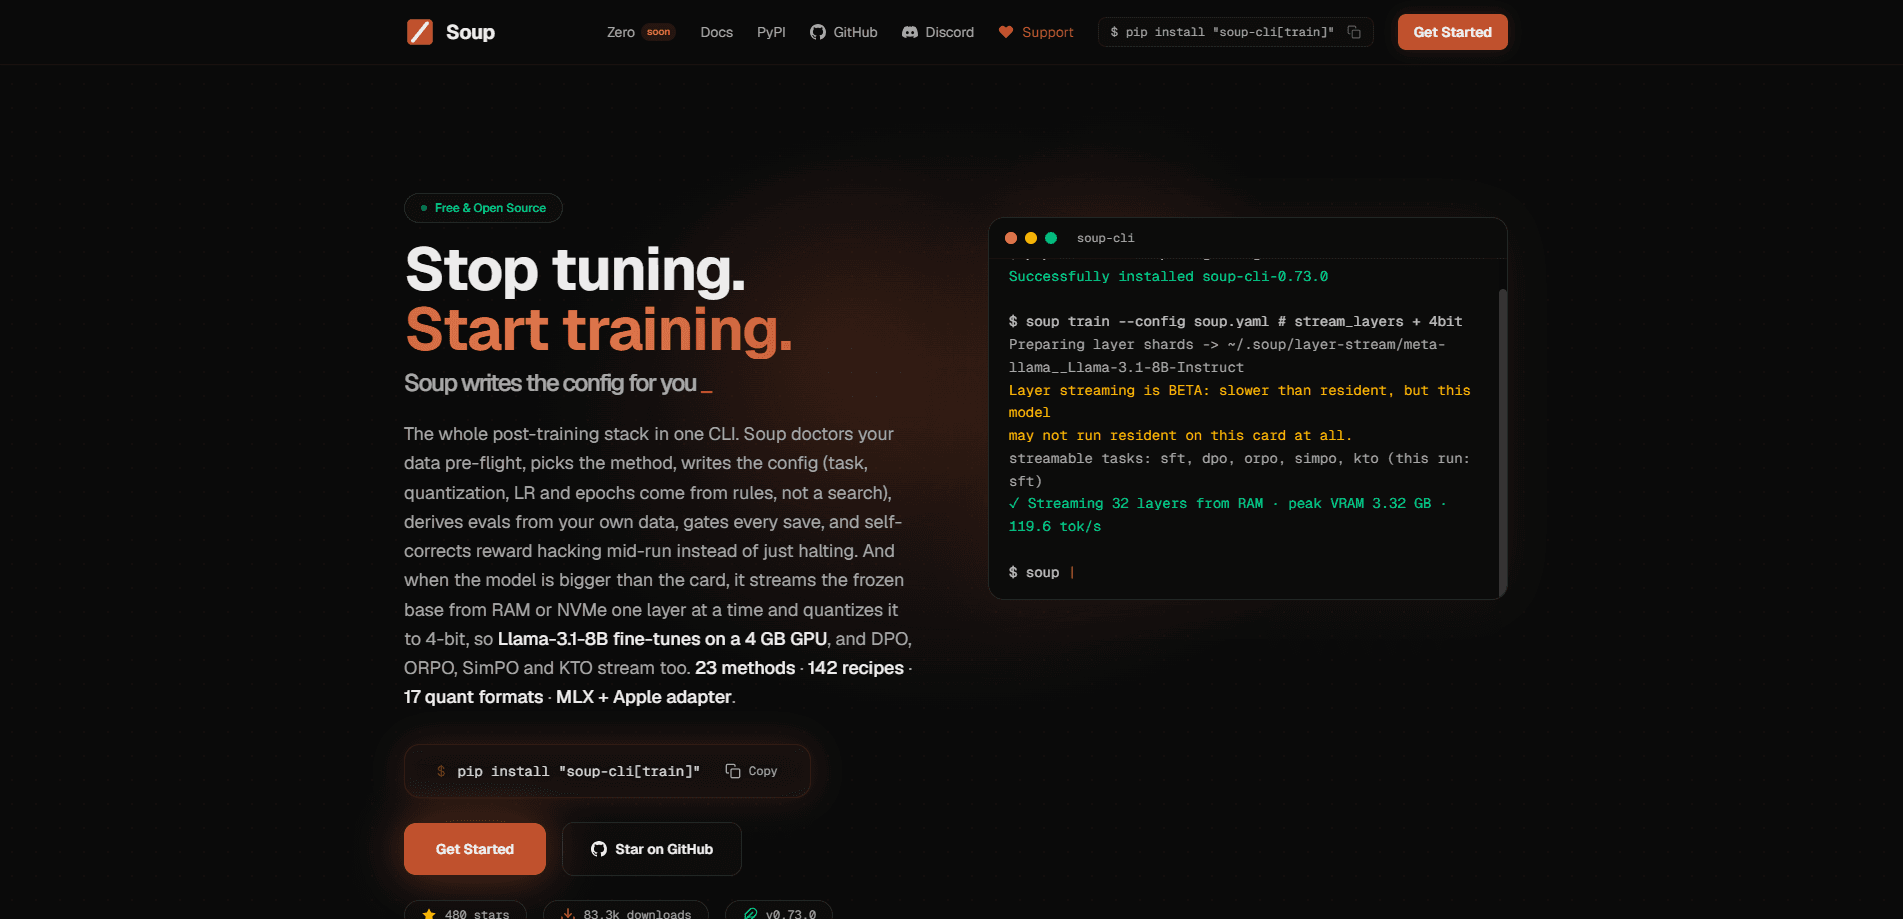
Soup CLI ist ein quelloffenes Kommandozeilen-Tool zum Fine-Tuning und Post-Training großer Sprachmodelle. Als Tool zum Fine-Tuning von LLM verwandelt es die übliche Einrichtungsarbeit in einen einzigen Ablauf: Man schreibt eine YAML-Datei, führt `soup train` aus, und Soup kümmert sich selbst um GPU-Erkennung, Batch-Größe und Quantisierung. Das Projekt richtet sich an alle, die Modelle lieber lokal trainieren, statt Cloud-GPUs zu mieten oder sich mit Trainingsskripten herumzuschlagen, und sein Aushängeschild, das Layer-Streaming, lässt ein 8B-Modell auf der GPU eines Laptops mit nur 4 GB VRAM trainieren.
Über Soup CLI
Was ist Soup CLI
Soup CLI (auch als Python-Paket soup-cli veröffentlicht) ist ein CLI-zentrierter Stack, der den gesamten Post-Training-Zyklus abdeckt: Datenbereinigung, Methodenwahl, Konfigurationserzeugung, Evaluierung und Checkpoint-Filterung. Das Projekt wird von MePlay, Inc. gepflegt und unter der Apache-2.0-Lizenz veröffentlicht, sodass man den Quellcode lesen, forken oder in die eigene Pipeline einbauen kann.
Das Hauptproblem, das es löst, ist der Reibungsverlust. Wer schon einmal ein Modell trainiert hat, kennt den Ablauf: Hardware auswählen, mit Abhängigkeitskonflikten kämpfen, die Batch-Größe raten und einen Absturz bei Schritt 400 debuggen. Soup presst das in eine Konfigurationsdatei, die es für einen schreibt. Warum ist das wichtig? Weil die Einrichtung, nicht das Training selbst, der Punkt ist, an dem die meisten Anfänger-Fine-Tunings scheitern. Es richtet sich an Entwickler, Forscher und kleine Teams, die ein funktionierendes Fine-Tuning wollen, ohne Infrastrukturingenieure zu werden.
Die größte Einschränkung ist die Hardware. Das Training braucht weiterhin eine CUDA-GPU, und ein echter 7B- bis 8B-Job auf einer normalen Maschine bedeutet, QLoRA und quantisierte Gewichte zu akzeptieren statt Training in voller Präzision. Das ist der Kompromiss. Das Layer-Streaming, die Funktion, die winzige GPUs tragfähig macht, ist weiterhin als BETA gekennzeichnet und muss von Hand aktiviert werden.
Erste Schritte
- Installiere das Paket. Nutze
pipx install "soup-cli[train]"oderuv tool install "soup-cli[train]". Die reinesoup-cli-Installation ist eine leichte CLI ohne PyTorch, also brauchst du das Extra[train], um zu trainieren. - Erzeuge eine Konfiguration. Führe
soup init --template chataus, um eine Start-soup.yamlfür ein Chat-Fine-Tuning zu erstellen. - Richte sie auf deine Daten und das Basismodell. Bearbeite die YAML, um den Pfad deines Datensatzes und das Modell festzulegen, das du anpassen willst.
- Starte das Training. Führe
soup trainaus und lass es deine GPU erkennen und die Einstellungen wählen. Bei großen Modellen auf kleinen Karten setze vorherstream_layers: true. - Bediene oder exportiere das Ergebnis. Nutze
soup serve, um das trainierte Modell hinter einem OpenAI-kompatiblen API-Endpunkt bereitzustellen.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Soup CLI.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Einzelentwickler und Hobbyisten
- ML-Ingenieure und Forscher
- Kleine Startups
Aufgaben
- Überwachtes Fine-Tuning
- Präferenzoptimierung
- Lokales Experimentieren
Szenarien
- Ein reiner Laptop-Ablauf
- Privates Fine-Tuning
- Ein trainiertes Modell in einen Dienst verwandeln
Wichtigste Funktionen
Eine Konfiguration, ein Befehl
Der Kern der Idee ist, dass eine einzige YAML-Datei den ganzen Job beschreibt. Man führt soup init aus, um eine Startkonfiguration zu erzeugen, bearbeitet ein paar Felder und führt dann soup train aus. Soup liest die Konfiguration, prüft die GPU und wählt eine passende Batch-Größe und Quantisierung. Für alle, die schon einmal einen Ordner voller Trainings-Shell-Skripte gepflegt haben, ist das der Reiz: Die Konfiguration ist die Dokumentation.
Layer-Streaming für winzige GPUs
Das Layer-Streaming ist die Funktion, die die meiste Aufmerksamkeit bekommt. Statt das gesamte eingefrorene Basismodell in den VRAM zu laden, hält Soup es außerhalb des Speichers und füttert die GPU eine Decoder-Schicht nach der anderen. Auf einer RTX 3050 Laptop mit 4 GB meldet das Projekt ein 8B-Modell bei 3,32 GB Spitzenspeicher. Ein großes Ergebnis. Der Haken: Es ist optional und weiterhin BETA, und die Durchsatzwerte stammen aus einer bestimmten älteren Version, also behandle die Geschwindigkeit als Untergrenze und nicht als Versprechen.
Eingebaute Evaluierung und Checkpoint-Filterung
Soup hört nicht beim Training auf. Es leitet Evaluierungen aus deiner Einrichtung ab und filtert Checkpoints dagegen, sodass ein Lauf, der schlechter wird, markiert wird, statt stillschweigend gespeichert zu werden. Für Teams, die oft trainieren, zählt das mehr als reine Geschwindigkeit. Man will eine Pipeline, die meldet, wenn ein Checkpoint schlechter ist als der vorige.
OpenAI-kompatible Bereitstellung
Der Befehl soup serve verwandelt ein trainiertes Modell mit einem einzigen Befehl in einen API-Dienst. Er stellt die Standard-Endpunkte /v1/chat/completions, /v1/models und /health bereit, unterstützt Streaming-Antworten und kann für höheren Durchsatz auf vLLM- oder SGLang-Backends umschalten. LoRA-Adapter lassen sich direkt bereitstellen, wobei das Basismodell aus der Adapter-Konfiguration aufgelöst wird, sodass man die Gewichte nicht erst von Hand zusammenführen muss.
Lokal zuerst, keine Cloud nötig
Alles ist darauf ausgelegt, auf Hardware zu laufen, die man bereits besitzt. Keine Cloud nötig. Es gibt kein Pflichtkonto, kein gehostetes Dashboard und keine Daten, die die Maschine verlassen, außer man richtet es so ein. Für Teams mit sensiblen Daten ist das oft der ausschlaggebende Punkt gegenüber einem verwalteten Trainingsdienst.
Datenwerkzeuge und Inspektionsbefehle
Die leichte soup-cli-Installation enthält trotzdem soup data ... und Inspektionsbefehle, die ohne PyTorch funktionieren. Das heißt, man kann seinen Datensatz auf einer Maschine ganz ohne GPU bereinigen und prüfen. Jetzt vorbereiten, später trainieren.
Vor- und Nachteile
Vorteile
- Quelloffen unter Apache-2.0, also keine Herstellerbindung und vollständig prüfbarer Code.
- Eine einzige YAML-Konfigurationsdatei ersetzt den größten Teil der Skriptarbeit und Einrichtung, die ein Fine-Tuning sonst verlangt.
- Layer-Streaming macht wirklich große Modelle auf kleinen Consumer-GPUs trainierbar.
- Bereitstellung und Evaluierung gehören zum selben Tool, sind also keine getrennten Werkzeuge, die man verbinden muss.
- Läuft vollständig offline, was Daten und Gewichte auf der eigenen Hardware hält.
Nachteile
- Das Layer-Streaming, die herausragende Funktion, ist weiterhin BETA und muss manuell aktiviert werden, ist also keine Einmal-einstellen-und-vergessen-Option.
- Die beste Leistung setzt eine CUDA-GPU voraus; die Unterstützung für Apple Silicon und CPU ist experimentell und langsam.
- Die geteilte Installation kann Neulinge verwirren, da ein einfaches `pip install soup-cli` kein Training erlaubt, bis man das Extra `[train]` hinzufügt.
- Die Dokumentation ist dicht und versionsspezifisch, sodass Ratschläge aus älteren Anleitungen nicht zur aktuellen Version passen können.
Häufige Fragen
Es ist ein quelloffenes Kommandozeilen-Tool zum Fine-Tuning und Post-Training großer Sprachmodelle. Man definiert einen Job in einer YAML-Datei und führt soup train aus, und es übernimmt GPU-Erkennung, Quantisierung und Batching für einen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Soup CLI.
Alternativen zu Soup CLI
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.