
TraceLLM
TraceLLM · Coding
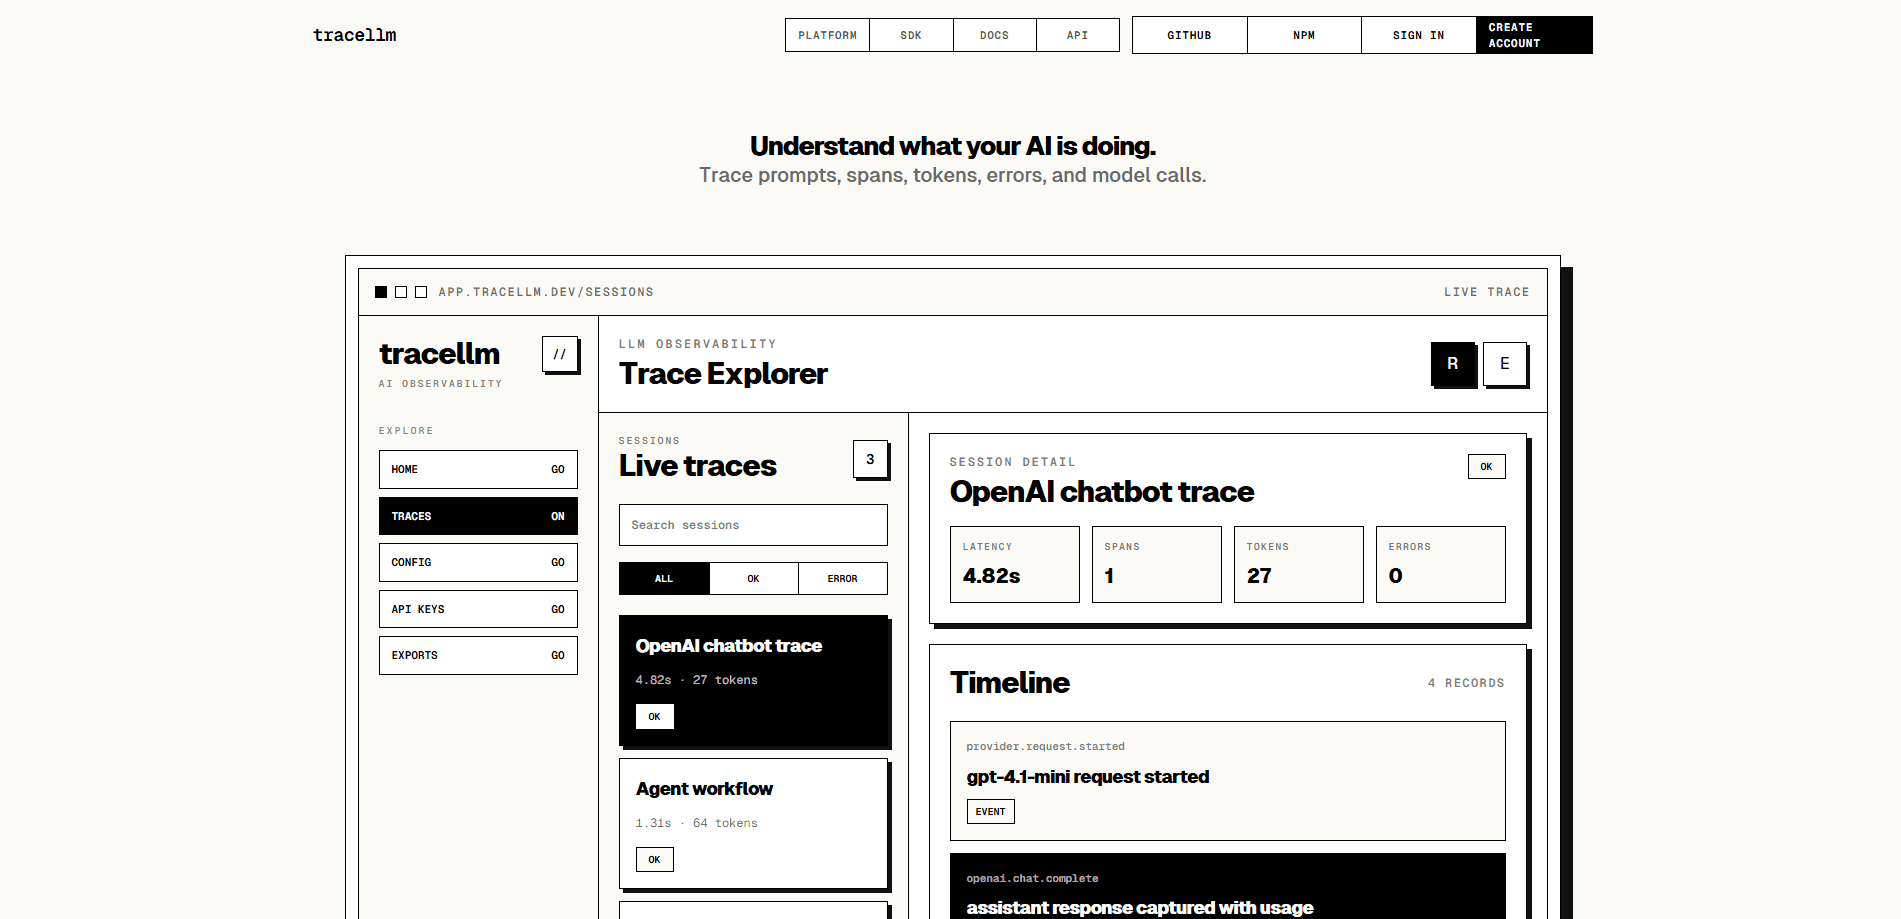
TraceLLM ist eine LLM-Observability-Plattform mit lokalem Schwerpunkt für Teams, die KI-Anwendungen im Produktivbetrieb betreiben. Sie zeichnet Sitzungen, Spans, Prompts und Ausgaben (wenn Sie es erlauben), Token-Verbrauch, Latenz und Fehler über Chatbots, Agenten und RAG-Pipelines hinweg auf und zeigt alles auf einer einzigen Trace-Zeitleiste. Eine Richtlinienebene entscheidet, was erfasst, geschwärzt oder verworfen wird, und ein OpenTelemetry-Exportpfad leitet ausgewählte Traces an Backends wie SigNoz oder Honeycomb weiter. Was bringt Ihnen das? Eine einzige Stelle, um zu beantworten, warum eine Antwort schiefgelaufen ist.
Über TraceLLM
Was ist TraceLLM
TraceLLM ist eine Observability-Plattform, die speziell für KI-Anwendungen gebaut wurde. Statt Hinweise über Anbieter-Dashboards, App-Logs und Nutzer-Bugreports zu verstreuen, gibt sie jedem KI-Workflow eine einzige Trace-Zeitleiste: was ihn ausgelöst hat, welcher Modellaufruf lief, wie lange jeder Schritt dauerte, wie viele Tokens verbraucht wurden und wo es fehlschlug.
Das Projekt ist Open Source unter der MIT-Lizenz, mit dem Code auf GitHub und der gehosteten App unter tracellm.in. Es entstand aus einem häufigen Problem: Eine falsche Antwort taucht im Produktivbetrieb auf, doch der App-Code, der Vektorspeicher und der Modellanbieter halten jeweils nur Fragmente der Geschichte. TraceLLM näht diese Fragmente zu einem einzigen prüfbaren Datensatz zusammen.
Die wichtigste Grenze ist die Reife. TraceLLM ist jung. Das Node-SDK ist ein Workspace-Paket statt einer auf npm veröffentlichten Version, und die Dokumentation verweist noch auf eine lokale Schnellstartanleitung. Wenn Sie heute ein kampferprobtes Tool mit einer großen Integrationsgalerie brauchen, ist das noch nicht so weit. Wenn Sie den Code lesen und selbst hosten wollen, passt es gut.
Erste Schritte
- Erstellen Sie ein Konto auf tracellm.in oder starten Sie den Stack lokal mit
pnpm install,pnpm infra:buildundpnpm infra:up. - Erstellen Sie ein Projekt und kopieren Sie den projektbezogenen API-Schlüssel (
trllm_...). - Installieren Sie das Node-SDK in Ihrer App und starten Sie eine Sitzung mit Ihrem Endpunkt, dem API-Schlüssel und dem Servicenamen.
- Umhüllen Sie Ihre Modellaufrufe mit Spans und erfassen Sie anschließend Ereignisse, Token-Zahlen und Fehler.
- Öffnen Sie den Trace-Explorer, um jede Sitzung zu prüfen, und fügen Sie optional einen OTLP-Endpunkt hinzu, um Traces an Ihr eigenes Backend weiterzuleiten.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von TraceLLM.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Ingenieure und Backend-Entwickler
- Kleine Produktteams ohne Plattformbudget
- Support-Mitarbeiter mit Fokus auf Debugging
Aufgaben
- Eine schlechte Chatbot-Antwort nachverfolgen
- Den Token-Verbrauch beobachten
- Fehler an echte Sitzungen gebunden halten
- In ein bestehendes APM exportieren
Szenarien
- Einen Agenten in Produktion bringen und eine Möglichkeit brauchen, eine fehlschlagende Konversation nachzuspielen
- Unter Inhaltsregeln arbeiten, bei denen Prompts personenbezogene Daten enthalten
- Observability über mehrere KI-Dienste vereinheitlichen
Wichtigste Funktionen
Sitzungs- und Span-Tracing
TraceLLM organisiert einen KI-Workflow als Sitzung mit verschachtelten Spans. Eine Sitzung enthält den Nutzer-Turn. Jeder Span deckt eine Arbeitseinheit ab, etwa einen Anbieteraufruf, einen Retrieval-Schritt oder einen Tool-Lauf. Das ist der Kern des LLM-Tracings. Sie starten eine Sitzung, öffnen darin Spans, erfassen Ereignisse, während sie passieren, und schließen beide mit einem Status. Die Struktur verwandelt einen losen Haufen Log-Zeilen in einen nachspielbaren Lauf.
Erfassungsrichtlinien
Nicht alles sollte gespeichert werden. Sie legen die Richtlinie pro Projekt fest: ob der Inhalt von Prompts und Ausgaben erfasst wird, wie viele Metadaten und Nutzung behalten werden und ob die Schwärzung API-Schlüssel und Bearer-Tokens maskiert, bevor sie die Datenbank erreichen. Hier bekommt das Prompt-Tracing seine Leitplanken. Sampling kann 0 % bis 100 % der Sitzungen erfassen, und bestimmte Span-Arten können ganz übersprungen werden.
Token-Verbrauch und Latenz verfolgen
Jeder Span kann Token-Zahlen und Zeiten neben seinen Attributen tragen. Kosten und Geschwindigkeit stehen in derselben Ansicht wie der Aufruf selbst. Sie sehen, welcher Schritt langsam und welcher teuer ist. Ohne zwei Dashboards zusammenzuführen. Das ist der Unterschied zwischen dem Wissen, dass die Rechnung gestiegen ist, und dem Wissen, welcher Prompt es verursacht hat.
OpenTelemetry- und OTLP-Export
TraceLLM behält seine eigene Produkt-Zeitleiste und kann ausgewählte Traces an einen eigenen OTLP-HTTP-Collector weiterleiten. Sie fügen einen Endpunkt ein, wählen, welche Signale weitergeleitet werden, und die Daten fließen zu SigNoz, Honeycomb, Tempo, Datadog oder jedem OTLP-kompatiblen Backend. Teams, die bereits ein APM betreiben, behalten ihren bestehenden Stack und behandeln TraceLLM als die KI-spezifische Ebene darüber.
Anbieterunabhängige Instrumentierung
Denken Sie daran als ein KI-Debugging-Tool, das Sie nicht an einen Anbieter bindet. Die Spans kümmern sich nicht darum, welches Modell Sie aufrufen. TraceLLM arbeitet mit OpenAI, Claude, Gemini, eigenen Routern, internen Diensten und MCP-förmigen Workflows, weil Sie den Aufruf selbst umhüllen, statt auf ein anbieterspezifisches Plugin zu setzen. Ein Wechsel von Modell oder Gateway bricht Ihr Tracing-Setup nicht.
Projektbezogene API-Schlüssel
Jeder API-Schlüssel ordnet Anfragen einem Projekt zu und trägt dessen Erfassungsrichtlinie in die SDK-Laufzeit. Erstellen Sie mehrere Schlüssel. Benennen Sie sie. Widerrufen Sie alte, wenn ein Dienst sie nicht mehr nutzt. So leckt eine gemeinsame Richtlinie nicht in unverwandte Apps, und der Schlüsselwechsel wird zu einer einfachen Zwei-Schritt-Aufgabe.
Vor- und Nachteile
Vorteile
- MIT-lizenziert und Open Source, also kein Abo und der Code ist lesbar.
- Das lokale Design lässt Sie selbst hosten und Trace-Daten auf Ihrer eigenen Infrastruktur halten.
- Die Erfassungsrichtlinie trennt Inhalt, Metadaten, Nutzung und Fehler, was bei sensiblen Prompts hilft.
- Der OTLP-Export bedeutet, dass Sie ein bestehendes SigNoz- oder Datadog-Setup nicht aufgeben.
- Anbieterunabhängige Spans decken OpenAI, Claude, Gemini und eigene Gateways ohne Plugins ab.
Nachteile
- Das Node-SDK ist noch nicht auf npm veröffentlicht, daher installieren frühe Anwender es aus dem Repository oder als Workspace-Paket.
- Es ist ein junges Projekt, also erwarten Sie weniger fertige Integrationen und Community-Beispiele als bei ausgereiften Tools.
- Selbsthosting bedeutet, dass Sie Deployment, Updates und Speicherdimensionierung selbst stemmen.
- Die Dokumentation füllt sich noch, daher erfordern manche Einrichtungsschritte das Lesen des Quellcodes.
Häufige Fragen
TraceLLM wird verwendet, um KI-Anwendungen im Produktivbetrieb zu debuggen und zu überwachen. Es zeichnet Sitzungen, Spans, Token-Verbrauch, Latenz und Fehler von Chatbots, Agenten und RAG-Pipelines auf und zeigt sie auf einer Zeitleiste, damit Sie finden, warum eine bestimmte Antwort schiefgelaufen ist.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu TraceLLM.
Alternativen zu TraceLLM
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.