

Unbody
Unbody (Unbody Labs) · Coding · Sonstiges
Unbody ist ein KI-natives Backend, das Inhalte aufnimmt, anreichert und vektorisiert und sie über eine einzige GraphQL-API für semantische Suche, Chatbots und generierte Antworten bereitstellt.
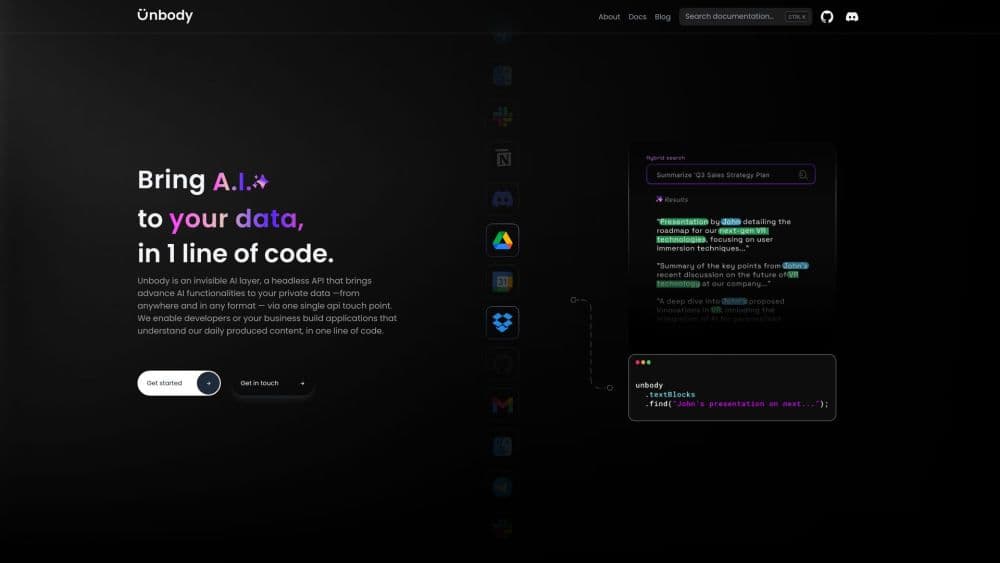
Über Unbody
About
Was ist Unbody
Unbody ist ein Backend für Teams, die KI-Funktionen wollen, ohne die Infrastruktur selbst zusammenzubauen. Sie verbinden eine Datenquelle, wählen einige Anreicherungsschritte und fragen das Ergebnis über einen einzigen GraphQL-Endpunkt ab. Das Versprechen lautete: ein RAG-Backend und Chatbot-Backend in einer Box, ohne Vektordatenbank, Embedding-Dienst, LLM-Hülle und Job-Queue, die ständig abgeglichen werden müssen.
Die Architektur besteht aus vier Schichten. Wahrnehmung übernimmt Aufnahme, Parsing, Anreicherung und Vektorisierung. Gedächtnis speichert die entstandenen Objekte und Vektoren. Schlussfolgern führt Modellaufrufe und Prompts aus. Aktion stellt alles über APIs und SDKs bereit. Fertige Konnektoren gibt es für Google Drive, Discord und GitHub, und die Push-API nimmt jede andere Quelle an, sobald Sie ein Schema dafür definieren. Anreicherer ergänzen Zusammenfassungen, Schlüsselwörter, Bildunterschriften, OCR-Text und gecrawlte Seiten, bevor die Inhalte indexiert werden.
Ein Punkt wiegt schwerer als jedes Feature: Unbody wird nicht mehr weiterentwickelt. Das GitHub-Repository ist archiviert, die gehostete Anwendung unter app.unbody.io lädt nicht mehr, und die Dokumentationsdomain liefert Fehler. Unbody Labs arbeitet heute an Adapt, einem separaten Framework für Gedächtnis. Diese Seite hält fest, was die Plattform bot, und dient als Wegweiser durch den archivierten Code, falls Sie ihn selbst betreiben wollen. Der Code ist Alpha-Qualität, und niemand veröffentlicht Korrekturen.
Erste Schritte
- Installieren Sie Node.js 20 oder 22, Docker, Docker Compose und yarn. Klonen Sie das Repository unbody-io/unbody und führen Sie yarn aus, um die Abhängigkeiten zu installieren.
- Kopieren Sie .env.example nach .env.local und tragen Sie einen OpenAI-API-Schlüssel ein. Der Schlüssel versorgt Embeddings und generative Endpunkte.
- Starten Sie die Dienste mit docker compose up und führen Sie danach yarn start aus. Die Indexierungsjobs laufen über Temporal, dessen Dashboard auf Port 8233 erreichbar ist.
- Legen Sie ein Projekt an und fügen Sie mit dem Befehl unbody-cli source add eine Quelle hinzu. Danach lässt sich verfolgen, wie die ersten Dateien Parsing, Anreicherung und Vektorisierung durchlaufen.
- Fragen Sie das Projekt über die GraphQL-API oder das TypeScript-SDK ab. Das SDK bündelt Abruf, Suche und Generierung in einem verkettbaren Client.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Unbody.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Backend-Entwickler, die einem bestehenden Produkt Suche oder Chat hinzufügen
- Kleine Produktteams ohne Machine-Learning-Ingenieur
- Teams, deren Inhalte schon in Google Drive, Discord oder GitHub liegen
Aufgaben
- Ein Dokumentenarchiv in eine durchsuchbare Wissensdatenbank verwandeln
- Einen Dokumentations-Chatbot auf einer Website ergänzen
- Inhalte im Stapel zusammenfassen und verschlagworten
- Semantische oder visuelle Ähnlichkeit testen
Szenarien
- Ein KI-natives Backend prüfen, bevor Sie selbst eines bauen
- Ein älteres Projekt weiterbetreiben
- Eine RAG-Pipeline lehren oder vorführen
Wichtigste Funktionen
Eine einzige GraphQL-API für alle Inhalte
Alles, was die Plattform speichert, ist über einen GraphQL-Endpunkt erreichbar, der als Knowledge-Base-API und semantische Such-API dient, mit Filtern, Sortierung, Paginierung und verschachtelten Objekten in derselben Abfrage. Sie fordern die Felder an, die Sie brauchen, und erhalten angereicherte Datensätze samt generierten Zusammenfassungen und Schlüsselwörtern. Getrennte Endpunkte für Bild und Video decken die Medienverarbeitung ab, und die Admin-API verwaltet Projekte und Quellen ohne Dashboard.
Fertige Konnektoren und Push-API
Für Google Drive, Discord und GitHub gibt es fertige Integrationen. Jede definiert einen Einstiegspunkt, etwa einen Ordner oder einen Kanal, und zieht die Inhalte dann nach Zeitplan. Für alles andere nimmt die Push-API Datensätze in einem selbst definierten Schema auf und deckt interne Datenbanken, exportierte Archive und eigene Feeds ab. Zusammen löste das den üblichen Start eines Wissensprodukts ohne maßgeschneiderte ETL-Pipeline.
Pipelines zur Anreicherung
Vor der Indexierung parst eine konfigurierbare Pipeline den Inhalt und lässt Anreicherer darauf laufen. AutoSummary schreibt kurze Zusammenfassungen, AutoKeywords zieht die wichtigen Begriffe heraus, und AutoVision erzeugt Bildunterschriften, liest Text per OCR aus und verschlagwortet Objekte. Crawler machen aus Webseiten strukturierte Datensätze. Pipelines richten Sie im Dashboard oder über die Admin-API ein, und eigene Plugins lassen sich registrieren, wenn der eingebaute Satz nicht reicht.
Fünf Suchmodi
Die API bietet semantische Suche, Stichwortsuche und hybride Suche sowie zwei Ähnlichkeitsmodi: Datensatzähnlichkeit und visuelle Ähnlichkeit. Die semantische Suche arbeitet mit Bedeutung, was hilft, wenn die Formulierung des Nutzers nicht zum Dokument passt. Die Stichwortsuche bleibt bei exakten Begriffen berechenbar. Die hybride Suche mischt beide. Visuelle Ähnlichkeit arbeitet mit Bildvektoren, sodass ein Produktfoto ähnliche Motive in einem Katalog findet.
Generative Suche und JSON-Ausgabe
Auf dem Abruf setzen zwei Generierungsmodi auf. From One schickt einen Prompt an jedes Objekt und kann Feldwerte in den Text einsetzen. From Many nimmt eine Gruppe von Objekten und erzeugt ein Ergebnis für alle, was zu Zusammenfassungen und Vergleichen passt. Ein eigener Modus liefert strukturiertes JSON, geprüft gegen ein Schema, und ist für Feldextraktion statt Prosa gedacht. Das Modell wählen Sie über Plugins, deshalb hängt das Backend nicht an einem Anbieter.
TypeScript-SDK und Frontend-Bausteine
Das TypeScript-SDK macht aus GraphQL-Aufrufen einen verkettbaren Client: Sammlung holen, filtern, suchen, Felder auswählen, dann generieren. Startprojekte gibt es für Next.js, Nuxt, NestJS und Express, und die Frontend-Schicht liefert fertige Komponenten für React und Vue. Nichts davon bindet Sie an einen gehosteten Dienst, denn dasselbe SDK zeigt auf eine lokale Instanz.
Vor- und Nachteile
Vorteile
- Eine API deckt Aufnahme, Anreicherung, Vektorisierung, Suche und Generierung ab und ersetzt damit einen Stapel getrennter Dienste.
- Der Code ist unter Apache 2.0 öffentlich, Sie können die Implementierung lesen, forken und auf eigener Hardware betreiben.
- Die Konnektoren für Google Drive, Discord und GitHub verkürzen die erste lauffähige Demo auf einen Nachmittag.
- Anreicherung läuft in der Pipeline, deshalb stehen Zusammenfassungen, Schlüsselwörter und Bild-Tags schon vor der ersten Abfrage bereit.
- Das TypeScript-SDK und die Startprojekte verringern die Menge an GraphQL, die Sie von Hand schreiben.
Nachteile
- Das Repository ist archiviert und die gehostete App offline. Es gibt keine Sicherheitsupdates, keine Bugfixes und keinen Support-Kanal.
- Die Dokumentationsseite löst nicht mehr auf, deshalb kommen Installationsdetails aus dem Code, dem README und alten Blogbeiträgen.
- Es war Alpha-Software: APIs änderten sich zwischen Releases, und einige Plugins blieben unfertig.
- Selbstbetrieb verlangt Docker, Node, einen Temporal-Worker und einen OpenAI-Schlüssel, dazu Geduld beim Debuggen eines Stacks, den niemand pflegt.
Häufige Fragen
Unbody war ein Backend für KI-Funktionen. Es zog Inhalte aus Quellen wie Google Drive und Discord, reicherte sie mit Zusammenfassungen und Metadaten an, speicherte Vektoren und lieferte das Ergebnis über eine GraphQL-API aus. Teams nutzten es für semantische Suche, Dokumenten-Chatbots und generierte Antworten.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Unbody.
Alternativen zu Unbody
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.