
Unreal Speech
Unreal Speech · Stimme & Sprache
Unreal Speech ist eine Text-zu-Sprache-API, die geschriebenen Text in natürliche KI-Stimmen verwandelt, das Audio in rund 300ms ausliefert und Wort-Zeitstempel für einen Bruchteil des Preises üblicher Sprach-APIs mitliefert.
Über Unreal Speech
About
Was ist Unreal Speech
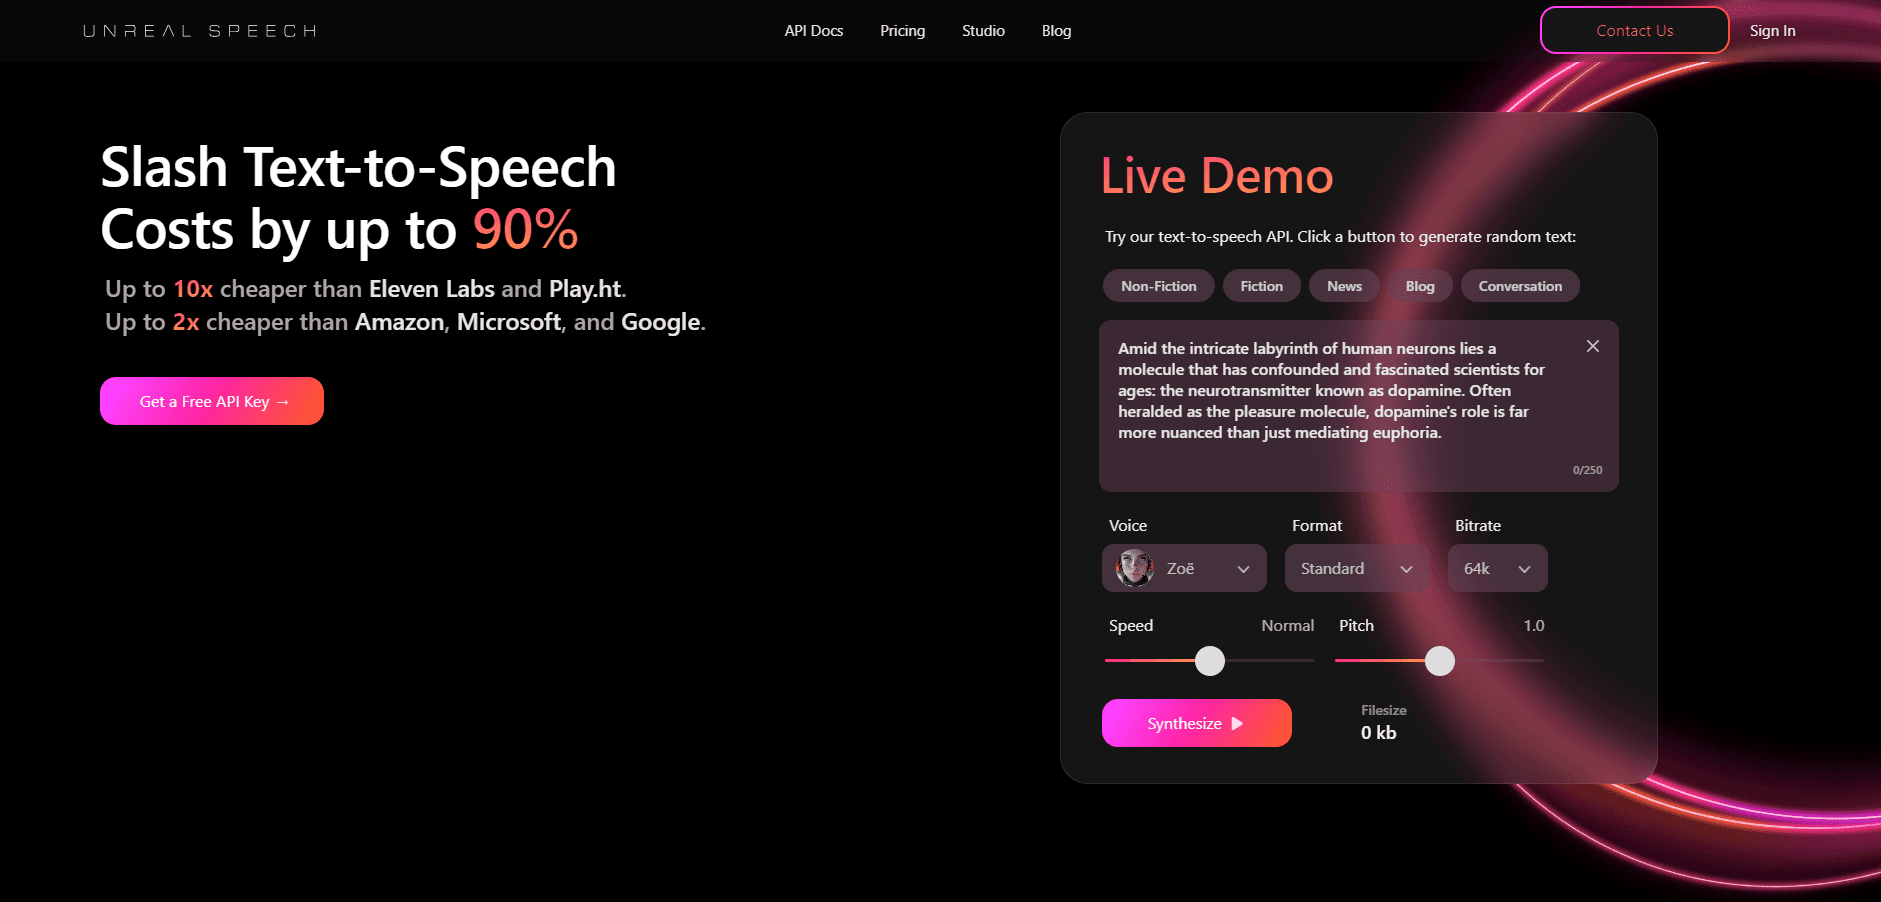
Unreal Speech ist eine Text-zu-Sprache-API für alle, die einer App Sprache hinzufügen wollen, ohne die Preise der gehobenen Sprach-KI zu zahlen. Man schickt Text an einen Endpunkt und bekommt gesprochenes Audio über einen einfachen REST-Aufruf oder eine WebSocket-Verbindung im Streaming zurück. Das Unternehmen positioniert den Dienst als Sprachsynthese-API, die etwa 11-mal günstiger als ElevenLabs ist und die Sprachausgabe dennoch nah am Menschen hält. Wer Sprachwerkzeuge vergleicht, sucht oft eine günstigere Alternative zu ElevenLabs, und genau beim Preis punktet diese hier.
Die Hauptaufgabe ist, Sprache in großem Umfang zu erzeugen. Über pures Audio hinaus liefert Unreal Speech Wort-Zeitstempel, die Anfang und Ende jedes Worts markieren, genau das, was man für Untertitel, Karaoke-Hervorhebung und Text im Video braucht. Auch lange Aufträge sind drin: Eine einzige Anfrage deckt über den Endpunkt für asynchrone Aufgaben bis zu 10 Stunden Audio ab, sodass Hörbücher und lange Erzählungen nicht an Zeitüberschreitungen scheitern.
Die Grenzen sollte man kennen. Der kostenlose Tarif deckt ein festes Kontingent an Zeichen pro Monat, sodass Produktionsprojekte auf einen bezahlten Tarif oder eine Abrechnung nach Nutzung wechseln. Der Stimmkatalog ist kleiner als bei den großen Cloud-Anbietern, und die Qualität hängt von der gewählten Stimme und dem Modell ab. Es ist außerdem ein reines API-Produkt: Es gibt kein Studio, um eine Erzählung per Hand zu bearbeiten, wer nicht programmiert, braucht also ein anderes Werkzeug, um es zu steuern.
Erste Schritte
- Holen Sie sich einen kostenlosen API-Schlüssel auf der Unreal-Speech-Seite, ohne Karte zum Start.
- Senden Sie eine POST-Anfrage an den Endpunkt /stream oder /speech mit Ihrem Text, einer VoiceId und Einstellungen wie Bitrate, Geschwindigkeit und Tonhöhe.
- Wählen Sie einen Codec wie libmp3lame oder pcm_mulaw und justieren Sie Tonhöhe und Geschwindigkeit, um die Stimme zu formen.
- Wechseln Sie bei langem Text zum Endpunkt /synthesisTasks und fragen Sie ihn ab, bis Audio und Zeitstempel bereit sind.
- Speichern Sie die zurückgegebene MP3, oder binden Sie die Zeitstempel in eine Untertitel- oder Hervorhebungsebene Ihrer App ein.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Unreal Speech.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- App- und Backend-Entwickler
- Kleine Studios und Einzelentwickler
- Content-Teams, die regelmäßig Audio produzieren
Aufgaben
- Erzählung für Video erzeugen
- Lange Dokumente in Hörbücher verwandeln
- Sprache in eine App oder einen Bot einbauen
Szenarien
- Sprachfunktionen mit Startup-Budget ausliefern
- Ein Lese- oder Barrierefreiheitswerkzeug bauen
- Erzählung für mehr Reichweite lokalisieren
Wichtigste Funktionen
Audio im Streaming in rund 300ms
Der Endpunkt /stream liefert Audio schnell zurück, das Unternehmen nennt eine Antwort von rund 300ms. Das ist der zentrale Pfad für Streaming-TTS und der, den man wählt, wenn Latenz zählt: Audio kommt als Streaming-Daten, nicht als Datei, auf die man ganz warten muss. In Assistenten, Spielen und Live-Oberflächen entscheidet dieser Unterschied, ob sich ein Gespräch flüssig oder abgehackt anfühlt.
Wort-Zeitstempel
Unreal Speech liefert Zeitdaten zurück, die Anfang und Ende jedes Worts markieren, als JSON neben dem Audio. Das trägt Untertitel, Karaoke-Hervorhebung und Text, der der Stimme genau folgt. Eine neuere WebSocket-Route streamt Audio und Zeitstempel zusammen, sodass die Hervorhebungsebene in Echtzeit aktualisiert wird, ohne auf den ganzen Clip zu warten.
Lange Synthese bis 10 Stunden
Der Endpunkt /synthesisTasks bewältigt große Aufträge in einer Anfrage, das Unternehmen nennt Unterstützung für bis zu 10 Stunden Audio. Das passt zu Hörbüchern, langen Kursen und ganzen Berichten, die sonst zerstückelt und wieder zusammengesetzt werden müssten. Sie senden den Text, fragen den Auftrag ab und holen das fertige Audio samt Zeitstempeldatei ab, sobald er fertig ist.
Natürliche Stimmen mit Steuerung von Geschwindigkeit und Tonhöhe
Jede Anfrage nimmt eine VoiceId sowie Werte für Geschwindigkeit, Tonhöhe und Bitrate, sodass Sie die Darbietung formen, ohne neu aufzunehmen. Die Bitrate reicht bis 320k für sauberes Abspielen, und Geschwindigkeit und Tonhöhe lassen sich an eine Figur oder ein Tempo anpassen. Der Katalog stützt sich auf ein kuratiertes Set benannter Stimmen statt auf Hunderte Optionen, was die Auswahl einfacher, aber die Vielfalt kleiner macht.
Flexible Codecs und Formate
Die API gibt Audio in Codecs wie libmp3lame und pcm_mulaw aus und deckt gängige MP3-Auslieferung und bandbreitenarmes Telefon-Audio ab. Sie stellen Abtastrate und Bitrate passend zur Zielplattform ein, sodass derselbe Dienst Web-Wiedergabe und telefonartige Pipelines bedient. Diese Bandbreite erspart Ihnen die nachträgliche Formatumwandlung.
Einfache REST- und WebSocket-API für Entwickler
Der Dienst dreht sich um wenige Endpunkte: /stream für schnelle Clips, /speech für mittleren Text mit Zeitstempel-URLs, /synthesisTasks für lange Aufträge und /streamWithTimestamps für Audio und Zeit in Echtzeit. Die Authentifizierung ist ein schlichter Bearer-Token, und die Doku zeigt Beispiele in Python, Node und cURL. Diese Schlichtheit macht die Voice-API für Entwickler attraktiv, weil sie an einem Nachmittag in einem Prototyp läuft.
Vor- und Nachteile
Vorteile
- Der Preis ist das Aushängeschild: Als günstiges TTS kostet es ein Mehrfaches weniger als ElevenLabs, was zählt, wenn ein Projekt viel Sprachvolumen erzeugt.
- Der kostenlose Tarif lässt Sie die API mit echten Zeichen testen, bevor Sie zahlen, sodass Sie die Qualität an Ihrem eigenen Skript beurteilen.
- Wort-Zeitstempel kommen mit dem Audio zurück, was den Extraschritt erspart, Untertitel oder Hervorhebungen von Hand auszurichten.
- Der Aufgaben-Endpunkt bewältigt bis zu 10 Stunden Sprache in einem Auftrag, sodass lange Hörbücher und Berichte nicht manuell geteilt werden müssen.
- Eine WebSocket-Route im Streaming startet Audio in rund 300ms und hält Echtzeit-Sprachantworten reaktionsschnell.
Nachteile
- Der Stimmkatalog ist kleiner als bei den großen Cloud-Sprachanbietern, sodass Nischenakzente oder Sprachen fehlen können.
- Genauigkeit und Tempo schwanken je nach Stimme und Modell, daher sollten Sie ein Beispiel testen, bevor Sie ein ganzes Projekt auf eine Wahl festlegen.
- Es ist ein reines API-Produkt ohne Klick-Editor, sodass Nicht-Programmierer ein weiteres Werkzeug brauchen, um eine fertige Erzählung zu erstellen.
- Die Qualität in kostenlosen oder rabattierten Tarifen ist durch die monatlichen Zeichen begrenzt, sodass intensiver Gebrauch das Kontingent schneller aufbraucht als erwartet.
Häufige Fragen
Unreal Speech ist eine Text-zu-Sprache-API und TTS-API, die geschriebenen Text in natürliche KI-Stimmen umwandelt. Entwickler senden Text an REST- oder WebSocket-Endpunkte und erhalten gesprochenes Audio, mit Wort-Zeitstempeln für Untertitel und Hervorhebung. Sie richtet sich an Teams, die Sprachfunktionen wollen, ohne Premium-Preise für Sprach-KI zu zahlen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Unreal Speech.
Alternativen zu Unreal Speech

Foley
Hanamori Labs, LLC · Stimme & Sprache · Produktivität · KI-AssistentFoley ist eine Sprach-To-do-Liste: Ein gesprochener Satz wird zur einsortierten Aufgabe mit Projekt, Datum und Uhrzeit, und danach plant die App den Tag um das, was schon auf der Liste steht.

HireKey
HireKey · Stimme & Sprache · Produktivität · LernenHireKey ist ein KI-Copilot für die Jobsuche, entwickelt von einer erfahrenen Tech-Recruiterin. Er prüft die Passung, passt den Lebenslauf an, trainiert Interviews und sammelt jede Bewerbung.

Fluence
Yay Software (Yannick Huchard) · Schreiben · Stimme & Sprache · ProduktivitätFluence ist eine Android-App, die PDF, EPUB, Word-Dateien und Web-Artikel vorliest, den gesprochenen Satz mitführt und Fragen zum Text direkt auf dem Telefon beantwortet.