
Vogent Voicelab
Vogent · Stimme & Sprache · Coding
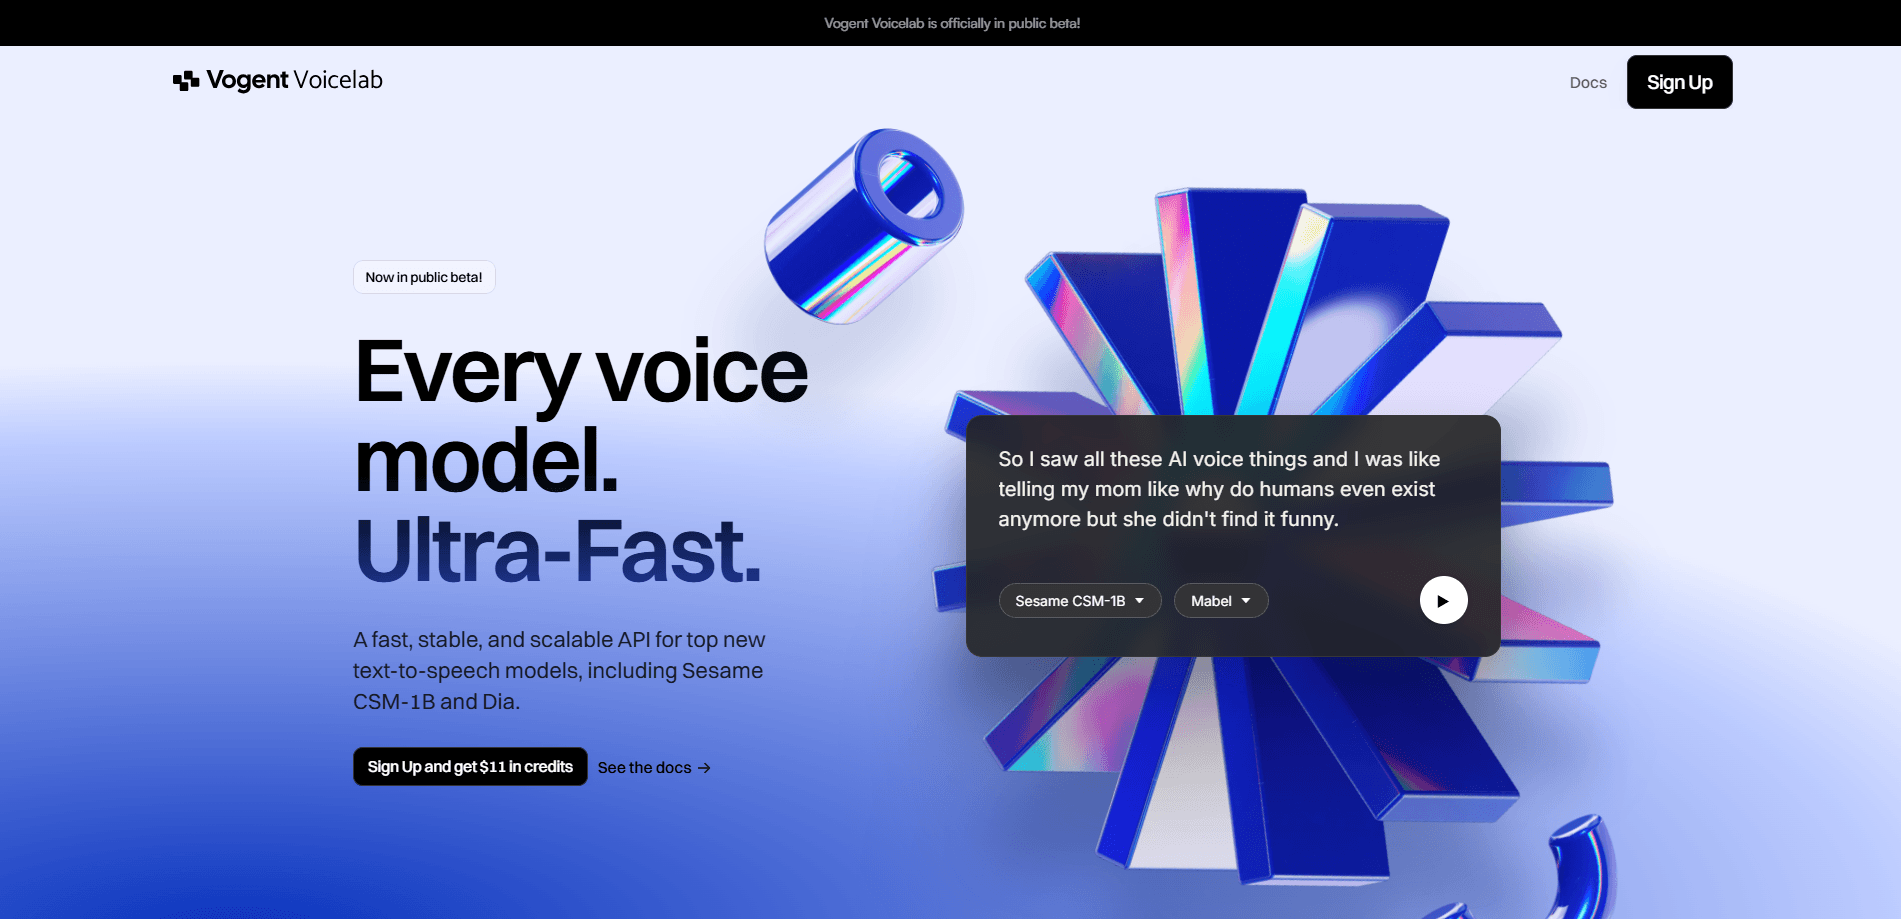
Vogent Voicelab ist eine Text-zu-Sprache-API, die Open-Source-Stimmodelle wie Sesame CSM-1B und Dia über einen schnellen, günstigen Endpunkt bereitstellt, samt Stimmklonen aus einem kurzen Clip.
Über Vogent Voicelab
What Is Vogent Voicelab
Vogent Voicelab ist eine API, um die besten Open-Source-Text-zu-Sprache-Modelle zu betreiben, also die, die in den Sprach-Rankings immer oben stehen, ohne eigene GPUs aufzustellen. Sie schicken Text an einen Endpunkt, wählen eine Stimme und bekommen Audio zurück. Das ist die ganze Arbeit, und sie richtet sich an Entwickler, die realistische Sprache in einem Produkt wollen statt eines weiteren Abos, das verwaltet werden muss.
Die Modelle sind der Reiz. Sesame CSM-1B meistert natürlichen Dialog hin und her, Dia liest allgemeinen Text und nimmt emotionale Marken wie ein Lachen oder Seufzen an, und Orpheus legt beim Ausdruck noch eine Schippe drauf. Alle paar Wochen kommt eine neue Open-Source-Stimme dazu, und Voicelab hält eine laufende Liste bereit, damit Sie das Neueste testen, ohne Ihren Stack umzubauen.
Die Einschränkung sollten Sie von Anfang an kennen. Manche Modelle sind noch nicht nachtrainiert, deshalb kann die Qualität zwischen Durchläufen schwanken, und fast das ganze Sortiment spricht zuerst Englisch. Voicelab ist zudem im Kern ein Entwicklerwerkzeug, der Nutzen zeigt sich also, wenn Sie Sprache in eine App einbauen, nicht wenn Sie schnell einen gesprochenen Satz brauchen.
Getting Started
- Melden Sie sich bei app.vogent.ai an und holen Sie sich einen kostenlosen API-Schlüssel im API-Bereich der Seitenleiste.
- Wählen Sie eine Stimme aus der Bibliothek, oder laden Sie einen Clip von 15 bis 20 Sekunden hoch, um Ihre eigene zu klonen.
- Schicken Sie eine POST-Anfrage an den TTS-Endpunkt mit Text und voiceId, und speichern Sie die zurückgegebene Audiodatei.
- Für zwei Sprecher wechseln Sie zum Multispeaker-Endpunkt und übergeben mehrere Zeilen, jede mit eigener Stimme.
- Für Live-Apps öffnen Sie die WebSocket-Route und streamen den Text, damit Audio läuft, bevor der Satz endet.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Vogent Voicelab.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- App-Entwickler
- Unabhängige Entwickler und Startups
- Produktteams, die konversationelle KI ergänzen
Aufgaben
- Voiceover für Demos und Videos erzeugen
- Einen Dialog zu zweit bauen
- Eine bestimmte Stimme klonen
- Sprache in eine Live-App streamen
Szenarien
- Mehrere TTS-Modelle vor der Entscheidung testen
- Einen Sprachpiloten mit knappem Budget fahren
- Von einem einzelnen Voiceover zu vielen gleichzeitigen Agenten wachsen
Wichtigste Funktionen
Eine API für mehrere Sprachmodelle
Voicelab stellt CSM-1B, Dia, Orpheus und eine wachsende Liste von Open-Source-Modellen hinter einen einzigen Endpunkt. Sie wechseln das Modell, ohne den Aufruf zu ändern. Das erspart Ihnen, die Integration neu zu bauen, sobald eine bessere Stimme auftaucht, was in diesem Feld oft passiert.
Sofortiges Stimmklonen
Laden Sie eine Aufnahme von 15 bis 20 Sekunden hoch, und Voicelab baut einen brauchbaren Klon dieser Stimme. Für fast jedes Projekt reicht das, und die Doku rät zu einem natürlichen, gesprächsnahen Clip statt einer polierten Lesung, um dem Original näher zu kommen. Stimmen professioneller Sprecher sind ebenfalls fertig vortrainiert da, falls Sie lieber gar nichts klonen.
Realistische Gesprächssprache
CSM-1B ist auf Dialog gebaut, nicht nur aufs Vorlesen. Es trägt das kleine Hin und Her eines echten Gesprächs mit und hält eine Stimme auch über lange Generierungen stabil. Wenn Ihr Produkt einen Assistenten hat, mit dem Menschen sprechen, fangen Sie mit diesem Modell an.
Dialog mit mehreren Sprechern
Ein eigener Endpunkt macht aus einer Liste von Zeilen ein fertiges Gespräch, jede Zeile mit ihrer Stimme. Zwei Sprecher wechseln sich in einer Datei ab. So produzieren Sie Interviews, Podcasts oder Figurenszenen, ohne Audio per Hand zusammenzusetzen.
Echtzeit-Streaming per WebSocket
Für den Live-Einsatz öffnet Voicelab eine WebSocket-Route, die Text streamt und Audiostücke zurückgibt, sobald sie entstehen. Ihre App kann sprechen, bevor die ganze Antwort geschrieben ist. Das zählt bei Chatbots und überall dort, wo eine Pause den Fluss ruiniert.
Emotionsmarken und Feinabstimmung
Dia und Orpheus nehmen Marken wie ein Seufzen oder ein Kichern an, die die Lesung zu einem Gefühl schieben statt in einen flachen Ton. In den höheren Tarifen können Sie eine Stimme auch mit eigenen Daten feinabstimmen und hosten, tief genug, um den Stil zu ändern, nicht nur zu kopieren.
Vor- und Nachteile
Vorteile
- Eine API deckt mehrere führende Open-Source-TTS-Modelle ab, Sie testen sie also ohne getrennte Konten.
- Der Gratis-Tarif enthält 180 Minuten Sprache, API-Zugang und Klonen.
- Sofortiges Klonen braucht nur einen kurzen Clip, eigene Stimmen bleiben also erreichbar.
- Der Minutenpreis sinkt mit höherem Tarif, von rund 6 Cent auf 3.
- Streaming, Multispeaker und Emotionsmarken sind eingebaut, nicht als Extras verkauft.
Nachteile
- Nicht jedes Modell ist nachtrainiert, die Qualität schwankt also zwischen Generierungen.
- Die meisten Modelle sind derzeit zuerst englisch, andere Sprachen hängen also an englischer Ausgabe.
- Es ist ein Entwicklerwerkzeug, also gibt es keinen Drag-and-drop-Editor für einen schnellen Satz.
- Nach Kundenwunsch trainierte Stimmen und lokale Bereitstellung stecken im Business-Tarif, den Sie per Kontakt anfragen.
Häufige Fragen
Es ist eine API, um Open-Source-Text-zu-Sprache-Modelle wie Sesame CSM-1B, Dia und Orpheus zu betreiben. Sie schicken Text, wählen eine Stimme und bekommen Audio zurück, alles ohne die Modelle selbst zu hosten.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Vogent Voicelab.
Alternativen zu Vogent Voicelab

Foley
Hanamori Labs, LLC · Stimme & Sprache · Produktivität · KI-AssistentFoley ist eine Sprach-To-do-Liste: Ein gesprochener Satz wird zur einsortierten Aufgabe mit Projekt, Datum und Uhrzeit, und danach plant die App den Tag um das, was schon auf der Liste steht.

HireKey
HireKey · Stimme & Sprache · Produktivität · LernenHireKey ist ein KI-Copilot für die Jobsuche, entwickelt von einer erfahrenen Tech-Recruiterin. Er prüft die Passung, passt den Lebenslauf an, trainiert Interviews und sammelt jede Bewerbung.

Fluence
Yay Software (Yannick Huchard) · Schreiben · Stimme & Sprache · ProduktivitätFluence ist eine Android-App, die PDF, EPUB, Word-Dateien und Web-Artikel vorliest, den gesprochenen Satz mitführt und Fragen zum Text direkt auf dem Telefon beantwortet.