
VoiceCanvas
ITUSI · Stimme & Sprache
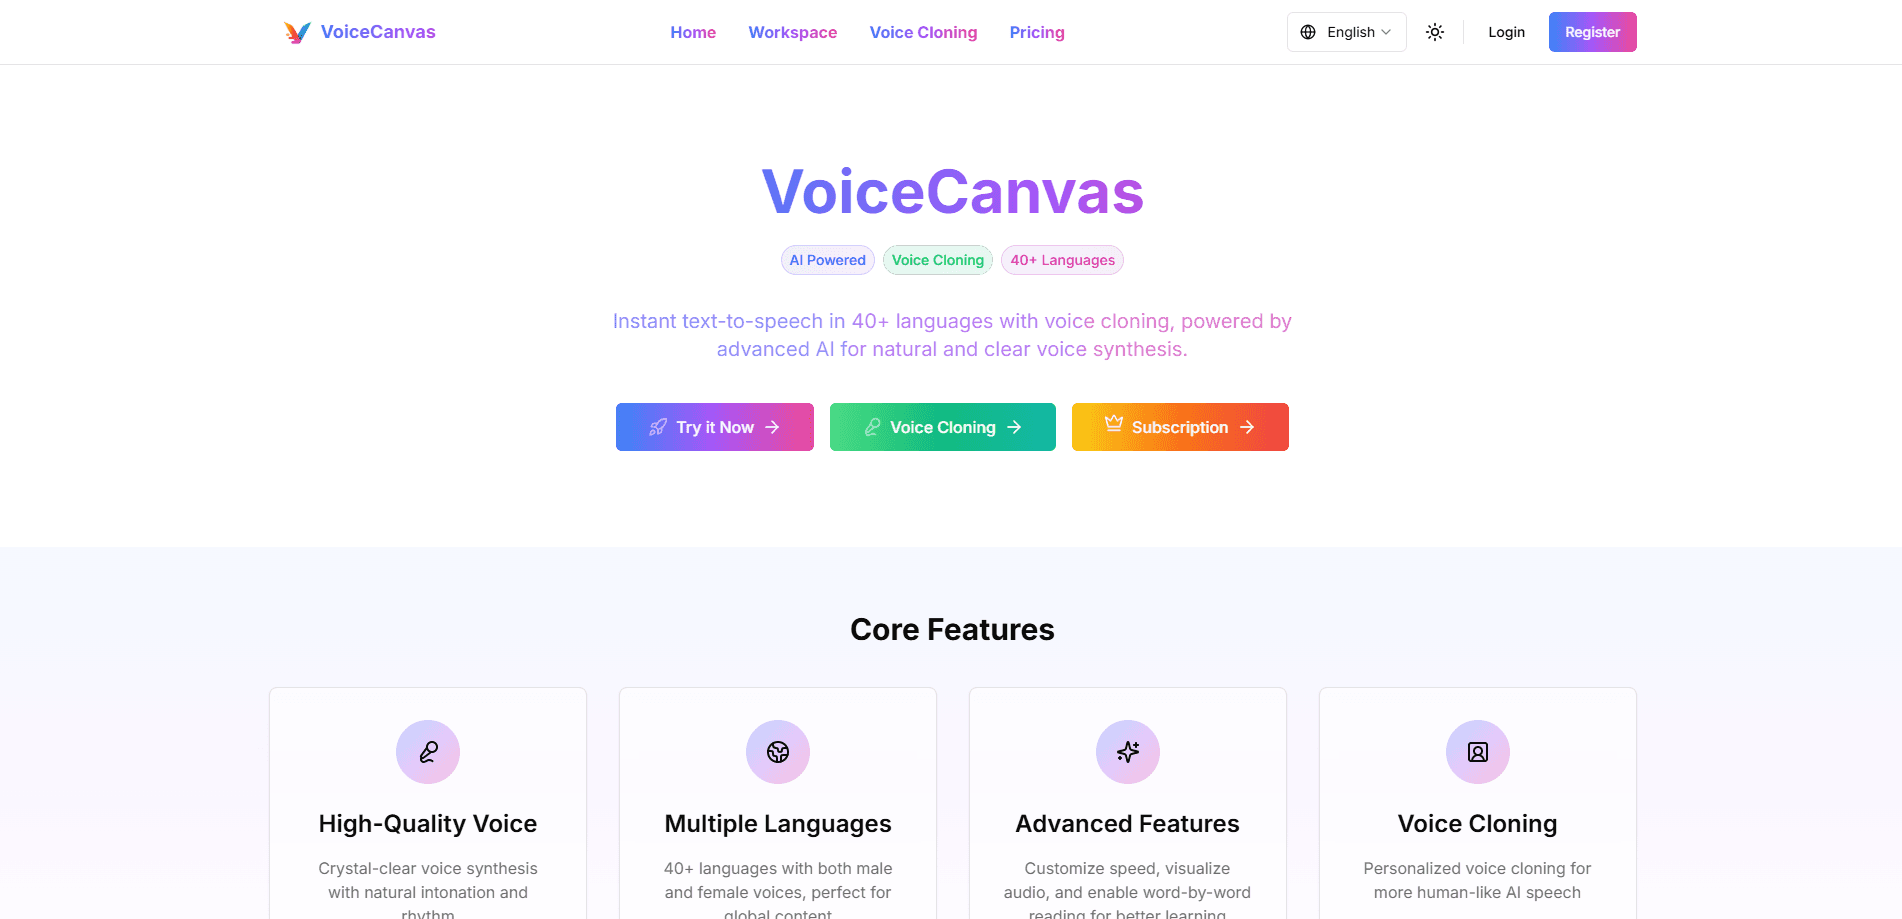
VoiceCanvas ist eine KI-Sprachsynthese-Plattform, die Text in über 50 Sprachen in natürliche Sprache umwandelt, mit Stimmklonen, Stimmdesign und Podcast-Werkzeugen. Die Testphase dauert 7 Tage.
Über VoiceCanvas
About
Was ist VoiceCanvas
VoiceCanvas ist eine Web-Plattform für Spracharbeit mit KI. Sie tippen oder laden einen Text hoch, wählen eine Stimme und erhalten eine Audiodatei zum Herunterladen, die sich in Videos, Kursen oder Podcasts einsetzen lässt. Entwickelt wird das Tool von ITUSI und es bündelt mehrere Sprachmotoren, darunter OpenAI TTS, AWS Polly und MiniMax.
Der Reiz liegt in der Breite zusammen mit der Anpassung. Es gibt über 50 Sprachen sowie männliche und weibliche Stimmen, und Sie können zusätzlich eine bestimmte Stimme aus einer kurzen Probe klonen oder eine neue beschreiben und erzeugen lassen. Diese Mischung deckt fast jede Alltagsaufgabe ab, vom Vertonen einer Lektion bis zum Sprechen eines Podcasts mit zwei Moderatoren.
Die Grenzen sollten Sie vorher kennen. Das Klonen braucht sauberes Audio, und die Testphase endet bei 100 Zeichen, taugt also zum Ausprobieren, nicht zum Arbeiten. Eine öffentliche API gibt es ebenfalls nicht, weshalb ein automatisierter Ablauf derzeit wegfällt.
Erste Schritte
- Legen Sie auf voicecanvas.org ein Konto an, per E-Mail, Google oder GitHub.
- Wählen Sie einen Modus: Text zu Sprache, Stimmklonen, Stimmdesign, Podcast oder Geschichtenerzählung.
- Fügen Sie Ihren Text ein oder laden Sie ihn hoch und legen Sie Sprache, Stimme und Tempo fest.
- Hören Sie die Vorschau an, justieren Sie Ton oder Tempo und laden Sie die Datei herunter, wenn das Ergebnis passt.
Der ganze Ablauf dauert wenige Minuten, sobald Ihre Stimme steht. Das Klonen ergänzt einen Schritt: Sie laden eine etwa 10 Sekunden lange Probe hoch und warten, bis das Modell die Stimme erstellt hat.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von VoiceCanvas.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- Content-Ersteller
- Podcast-Macher
- Lehrkräfte und Trainer
- Hörbuch-Produzenten
Aufgaben
- Sprachaufnahme für Videos
- Mehrsprachige Synchronisation
- Geschichten für Kinder vertonen
- Lernaudio erstellen
Szenarien
- Einen Blogbeitrag in Audio verwandeln
- Einen Podcast-Entwurf bauen
- Hörübungen für den Unterricht
- Die eigene Stimme für wiederkehrende Inhalte klonen
Wichtigste Funktionen
Text zu Sprache in über 50 Sprachen
VoiceCanvas ist ein mehrsprachiges TTS, das über 50 Sprachen und Dialekte abdeckt, mit männlichen und weiblichen Stimmen und regionalen Akzenten wie amerikanischem und britischem Englisch. Sie fügen Text ein, wählen eine Stimme und erhalten Audio mit natürlicher Betonung. Dieser KI-Stimmgenerator bildet die Grundlage für alles Weitere.
Stimmklonen aus einer kurzen Probe
Sie laden etwa 10 Sekunden sauberes Audio hoch und die Plattform erstellt eine wiederverwendbare Stimme, die Emotion und Charakter des Originals bewahrt. Das Klonen funktioniert über Sprachen hinweg, eine einzige Probe kann also andere Sprachen sprechen. Der Klon bleibt dauerhaft gültig, was zu allen passt, die eine gleichbleibende Stimme über Projekte hinweg möchten.
Stimmdesign für individuelle Klangfarben
Statt eine vorhandene Stimme zu klonen, beschreiben Sie die gewünschte in normaler Sprache und erzeugen sie. VoiceCanvas zeigt das Ergebnis in Echtzeit, sodass Sie vor dem Speichern reinhören können. Gespeicherte Entwürfe bleiben griffbereit, was hilft, wenn eine Stimme für eine ganze Reihe gebraucht wird.
KI-Podcast-Generator
Sie liefern Inhalte, und das Tool baut einen Interviewdialog zwischen Moderator und Gast, den es mit synthetischen Stimmen vorliest. Gedacht ist das für alle, die einen professionell klingenden Podcast wollen, ohne zwei Personen live aufzunehmen. Das Skript müssen Sie trotzdem prüfen, denn die KI schreibt das Gespräch aus Ihren Vorgaben.
Geschichtenerzählung mit KI
Dieser Modus wandelt eine Geschichte in Audio um und lässt Sie jeder Figur eine eigene Stimme geben. Dadurch eignet er sich für Kindergeschichten und Hörbücher, in denen eine einzelne Erzählerstimme das Material flach machen würde. Eigener Text und Bearbeitung sind vor dem Erzeugen möglich.
Tempo und Wort-für-Wort-Lesen
Sie können das Tempo senken oder erhöhen, und ein Wort-für-Wort-Modus hebt den Text während des Sprechens hervor. Das ist für Sprachlernende und alle gedacht, die einem Skript genau folgen. Die Audiodatei lädt sich zudem mit einem Klick herunter, sobald sie fertig ist.
Vor- und Nachteile
Vorteile
- Über 50 Sprachen mit männlichen und weiblichen Stimmen und regionalen Akzenten, eine Plattform deckt damit fast jeden Lokalisierungsbedarf.
- Das Klonen braucht nur etwa 10 Sekunden Probe und bleibt dauerhaft gültig, was eine persönliche Stimme über die Zeit konstant hält.
- Die Testphase und ein niedriger Einstiegspreis (3 Dollar für einen einzelnen Klon) erlauben einen Test vor der Entscheidung.
- Podcast- und Erzählmodus bewältigen Inhalte mit mehreren Stimmen, die ein einfaches Text-zu-Sprache nicht abdeckt.
Nachteile
- Keine öffentliche API, Sie können VoiceCanvas also nicht in eine App oder einen automatisierten Ablauf einbinden.
- Die Testphase bietet nur 100 Zeichen, gerade genug für eine Hörprobe.
- Das Klonen hängt von sauberem Audio ab; eine kurze oder verrauschte Probe senkt die Qualität des Klons.
- Die Zeichenkontingente der Bezahltarife sind bei langen Arbeiten wie Hörbüchern schneller aufgebraucht als erwartet.
Häufige Fragen
Es wandelt Text in gesprochenes Audio um und erstellt eigene Stimmen. Typische Anwendungen sind Sprachaufnahmen, mehrsprachige Synchronisation, Podcasts und vertonte Geschichten.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu VoiceCanvas.
Alternativen zu VoiceCanvas

Foley
Hanamori Labs, LLC · Stimme & Sprache · Produktivität · KI-AssistentFoley ist eine Sprach-To-do-Liste: Ein gesprochener Satz wird zur einsortierten Aufgabe mit Projekt, Datum und Uhrzeit, und danach plant die App den Tag um das, was schon auf der Liste steht.

HireKey
HireKey · Stimme & Sprache · Produktivität · LernenHireKey ist ein KI-Copilot für die Jobsuche, entwickelt von einer erfahrenen Tech-Recruiterin. Er prüft die Passung, passt den Lebenslauf an, trainiert Interviews und sammelt jede Bewerbung.

Fluence
Yay Software (Yannick Huchard) · Schreiben · Stimme & Sprache · ProduktivitätFluence ist eine Android-App, die PDF, EPUB, Word-Dateien und Web-Artikel vorliest, den gesprochenen Satz mitführt und Fragen zum Text direkt auf dem Telefon beantwortet.