
wafer
Wafer · Coding
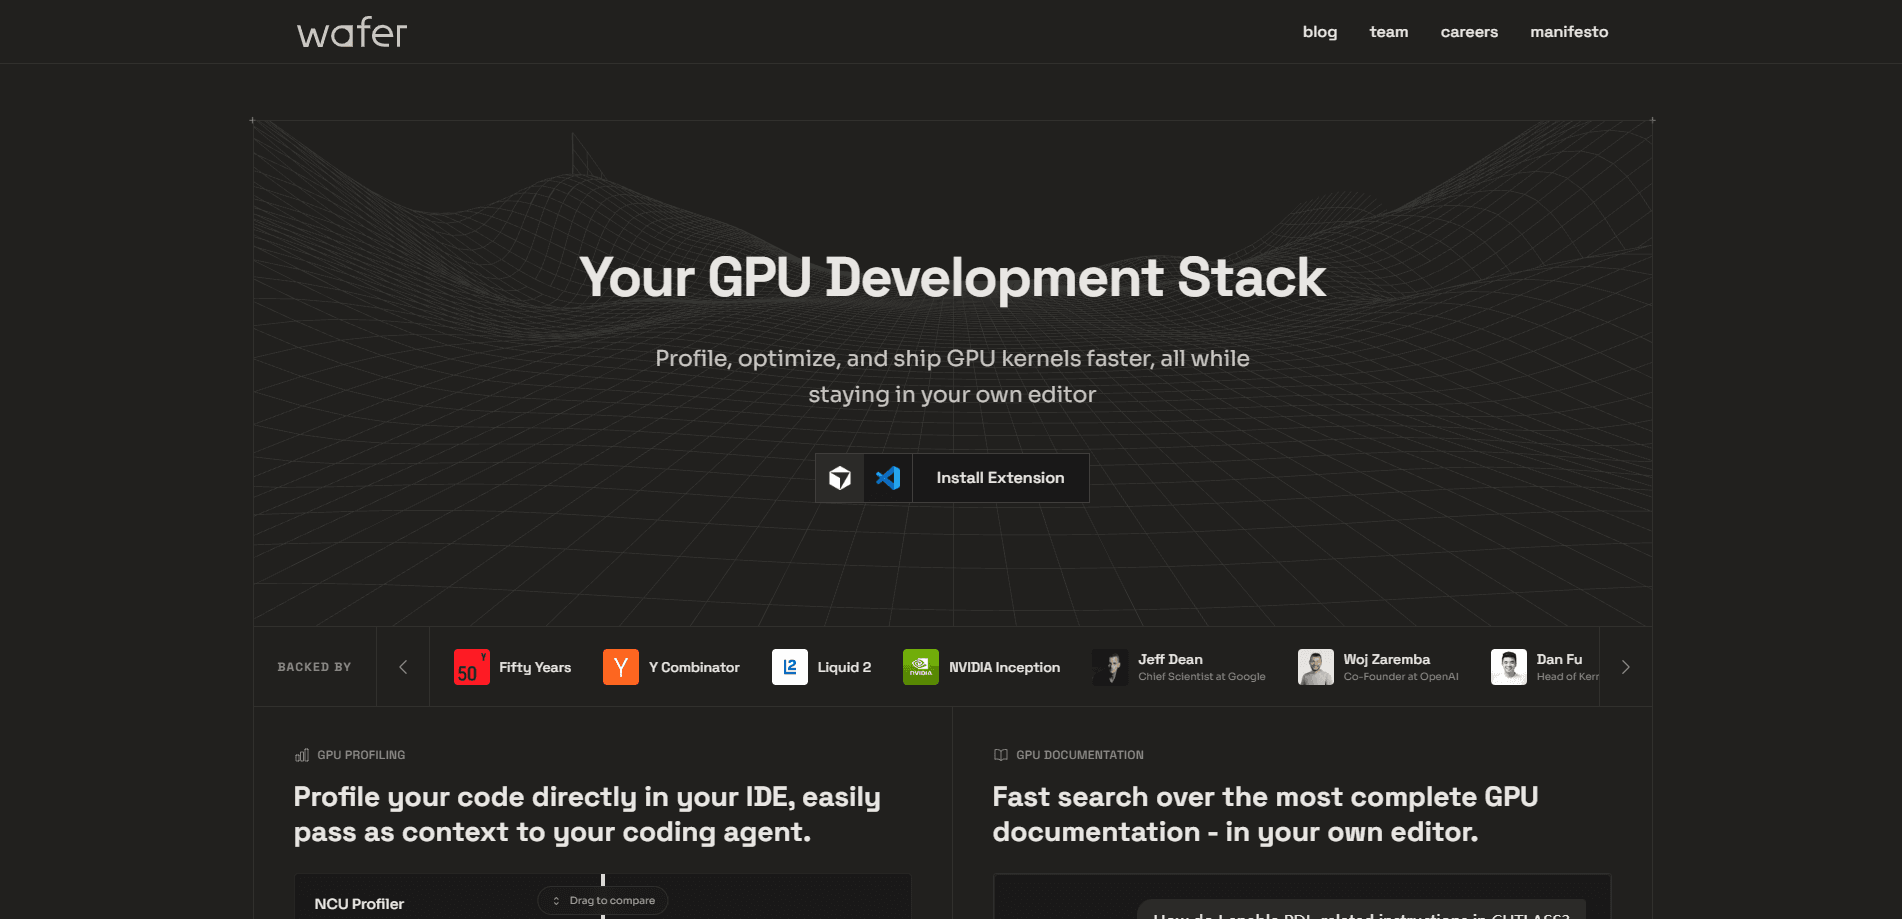
Wafer ist eine KI-Inferenz-Optimierungsplattform, die den gesamten GPU-Serving-Stack auf Ihren tatsächlichen Verkehr abstimmt statt auf einen generischen Benchmark. Statt einen Schalter umzulegen und auf das Beste zu hoffen, profiliert sie, wohin Latenz und Durchsatz wirklich gehen, erzeugt Kandidaten-Konfigurationen über Kernels, Engines, Batching und Quantisierung hinweg und setzt nur die Konfigurationen ein, die sie als schneller gemessen hat. Der Fokus liegt auf LLM-Inferenz in einem Maßstab, in dem Kosten und Latenz zählen. Teams bringen ein Modell, eine Verkehrsform und ein Service-Level-Ziel mit, und Wafer hält den Endpunkt abgestimmt, während sich Last und Hardware ändern.
Über wafer
Was ist Wafer
Wafer ist eine verwaltete Inferenzplattform, gebaut vom Team hinter Continual Inference. Das Versprechen ist bewusst eng gefasst: Die schnellste Konfiguration für ein Sprachmodell ist selten eine einzelne Einstellung, die man aktiviert. Kernel-Wahl, Verhalten der Serving-Engine, Batching, Quantisierung, Hardware und Verkehrsform drücken gegeneinander, sodass das Abstimmen einer Schicht oft eine andere kaputt macht.
Genau dieses Problem greift Wafer an. Sein Agent profiliert Ihren Stack, um herauszufinden, ob der Engpass in der Planung, der Dekodierung, den Kernels, dem Speicherdruck oder der Hardware-Passung liegt, durchsucht dann Kandidaten-Konfigurationen und misst jede einzelne, um zu sehen, welche Kombination auf Ihrem Verkehr tatsächlich gewinnt. Nur Änderungen, die Bestand haben, werden ausgeliefert. Die ganze Schleife ist darauf ausgelegt, nach dem Start weiterzulaufen. Der Verkehr verschiebt sich. Modelle werden aktualisiert. Neue Hardware kommt ständig dazu. Übersteht eine einmalige Abstimmung all das? Nein.
Die wichtigsten Grenzen sollte man offen benennen. Wafer richtet sich an Teams, die KI in einem Maßstab betreiben, in dem Inferenzkosten zählen, nicht an jemanden, der mit einem lokalen Modell herumexperimentiert. Es ist außerdem ein dedizierter Service mit Betreuung: Sie bringen Ihr Modell und echten Verkehr mit, kein Self-Service-Produkt zum Drag-and-drop. Wer nur mit ein paar Klicks ein gehostetes Open-Source-Modell aufrufen will, ist hier falsch.
Erste Schritte
- Legen Sie ein Konto in Wafers Web-App an und öffnen Sie den dedizierten Deployment-Bereich.
- Teilen Sie Ihr Modell, die Form Ihres echten Verkehrs und das Service-Level-Ziel, das Sie erreichen müssen.
- Lassen Sie den Agenten den Stack profilieren und Kandidaten-Konfigurationen über Batching, Dekodierung, Quantisierung, Engines, Kernels und Hardware erzeugen.
- Prüfen Sie die gemessenen Ergebnisse und setzen Sie die schnellste Konfiguration ein, die Korrektheit und Ihre Zuverlässigkeitsziele wahrt.
- Profilieren Sie weiter den Produktionsverkehr, damit Wafer sich anpasst, wenn sich Last, Modelle oder Hardware ändern.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von wafer.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- ML-Plattform-Teams
- Engineering-Teams von Startups
- Backend- und Performance-Engineers
Aufgaben
- LLM-Serving-Kosten senken
- Ein Latenzziel erreichen
- MoE-Modelle abstimmen
Szenarien
- Ein Modell bereits in Produktion, dessen Betrieb zu teuer ist
- Eine Workload auf neue Hardware verschieben
- Einen Start vorbereiten
Wichtigste Funktionen
Profiling über den ganzen Stack
Wafers Agent profiliert den gesamten Serving-Pfad statt einer einzelnen Schicht und pinpointet, ob Latenz oder Durchsatz aus Planung, Dekodierung, Kernels, Speicherdruck oder einer unglücklichen Hardware-Passung stammen. Diese Diagnose treibt alles Weitere, sodass Änderungen den echten Engpass treffen und keine Vermutung. Für ein Team, das auf einem Latenz-Plateau feststeckt, ist das der Unterschied zwischen Raten und Messen. Schluss mit blinden Anpassungen.
Suche nach Kandidaten-Konfigurationen
Der Agent erzeugt viele Kandidaten-Konfigurationen über Batching, Dekodierung, Quantisierung, Serving-Engines, Kernels und Hardware und misst dann jede. Nichts wird allein auf Basis von Theorie ausgeliefert. Das ist der eigentliche Grund, warum die Plattform existiert: Was auf dem Papier schnell aussieht, verliert in der Praxis oft gegen eine andere Kombination. Vertrauen Sie den Zahlen, nicht der Intuition.
Erzeugung eigener Kernels
Wafer schreibt fusionierte Ops, Attention-Pfade, GEMM-Varianten und Dekodier-Kernels, abgestimmt auf eine bestimmte Modellform und ein Hardware-Ziel. Das sind CUDA-Kernels und ihre Entsprechungen, und derselbe Ansatz deckt HIP, Triton und NKI ab, sodass er NVIDIA, AMD und andere Beschleuniger-Stacks umspannt. Eigene Kernels zählen am meisten, wenn ein Standard-Pfad Leistung liegen lässt.
Auto-Tuning der Serving-Engine
Serving-Engines werden für das exakte Modell, die Verkehrsform, den Speicherdruck und das Latenzziel abgestimmt, einschließlich Scheduler-Verhalten, KV-Cache-Handling und Laufzeiteinstellungen. Das Auto-Tuning hier ersetzt den manuellen Durchlauf, den die meisten Teams sonst von Hand fahren würden. Es hält die Engine außerdem im Einklang damit, wie sich Ihre Workload tatsächlich verhält. Weniger Betreuung, mehr Durchsatz.
Suche nach der Dekodierstrategie
Wafer vergleicht spekulative Dekodierung, FP8- und FP4-Quantisierung, Batching-Strategien und Expert-Sharding für MoE-Modelle. Diese Entscheidungen wirken stark aufeinander, sodass das gemeinsame Testen besser ist als das Abstimmen Stück für Stück. Wer große Modelle serviert, findet in der Dekodierstrategie oft die größten Gewinne. Wer sie überspringt, lässt Geld liegen.
Von Grund auf zuverlässig
Jeder Kandidat muss Korrektheit wahren und Ihre Zuverlässigkeitsziele erfüllen, bevor er ausgeliefert werden darf. Diese Leitplanke zählt, wenn Optimierung und Quantisierung die Ausgaben still verändern können. Sie bekommen den Geschwindigkeitsgewinn, ohne die Ergebnisse still zu opfern, auf die Ihre Nutzer angewiesen sind. Genau darum geht es.
Kontinuierliches Nachstimmen
Die Plattform bleibt nach dem Deployment im Kreislauf. Wenn sich der Verkehr verschiebt, Modelle aktualisiert werden oder neue Hardware ankommt, misst Wafer erneut und passt sich an. Inferenzleistung driftet, deshalb veraltet eine einmalige Abstimmung schnell. Kontinuierliches Nachstimmen hält einen Endpunkt über Monate statt über Tage wettbewerbsfähig.
Vor- und Nachteile
Vorteile
- Optimiert den ganzen Serving-Stack statt einer Schicht und erfasst so Engpässe, die Tools mit einer einzelnen Einstellung übersehen.
- Liefert nur gemessene Konfigurationen aus, was das Risiko einer Regression durch eine ungetestete Änderung senkt.
- Deckt moderne Dekodierstrategien ab wie spekulative Dekodierung, FP8/FP4-Quantisierung und MoE-Expert-Sharding.
- Stimmt in Produktion weiter ab, während sich Last, Modelle und Hardware ändern, sodass Ergebnisse nicht veralten.
- Das Startup-Programm bietet 500 $ kostenloses Guthaben plus 1:1-Matching bis zu 10.000 $, was die Startkosten abfedert.
Nachteile
- Es ist ein dedizierter Service mit Betreuung, also gibt es keinen sofortigen Self-Service-Weg, wenn Sie einfach schnell ein Modell deployen wollen.
- Der Wert hängt von echtem Verkehr und Maßstab ab; ein kleines Projekt mit leichter Inferenzlast sieht womöglich nicht genug Gewinn, um den Aufwand zu rechtfertigen.
- Tiefes Tuning über Kernels und Quantisierung setzt ein Engineering-Team voraus, das mit den Serving-Interna vertraut ist.
- Öffentliche Preise sind auf der Website nicht angegeben, sodass die Kosten in einem Gespräch mit dem Team geklärt werden müssen.
Häufige Fragen
Wafer stimmt den gesamten LLM-Serving-Stack auf Ihre Workload ab und setzt nur die Konfigurationen ein, die es als schneller gemessen hat. Es profiliert den Stack, durchsucht Kandidaten-Konfigurationen und stimmt in Produktion weiter nach.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu wafer.
Alternativen zu wafer
Forefront
Forefront · CodingForefront ist eine Webplattform zum Bauen mit Open-Source-KI. Sie lassen sich führende Open-Source-Sprachmodelle mit eigenen Daten feintunen, ihre Leistung bewerten und sie über eine API ausführen oder exportieren, um sie selbst zu hosten. Entwickler, die den Komfort einer geschlossenen Plattform wollen, aber darauf bestehen, ihre Modelle und Daten zu besitzen, sind hier die Zielgruppe.

Startkit
StartKit.AI · CodingStartkit ist ein Boilerplate zum Bauen von KI-SaaS-Produkten und KI-Wrappern. Man kann es sich als KI-Startup-Boilerplate vorstellen, bei dem die langweiligen Teile schon verdrahtet sind: Authentifizierung, Zahlungen über Stripe und Lemon Squeezy, Nutzungslimits, transaktionale E-Mail und ein KI-API-Starter-Kit, das mit OpenAI, Anthropic, Groq oder Llama spricht. Man klont das Repository, setzt seinen Preis und kümmert sich um den Teil des Produkts, für den Menschen wirklich bezahlen. Es basiert auf Next.js über React und Tailwind, deshalb fühlt sich ein Großteil des Boilerplate-Codes schon vertraut an.
Testim
Tricentis · CodingTestim ist eine KI-gestützte Plattform für Testautomatisierung, mit der man End-to-End-Tests für Web-, Mobile- und Salesforce-Anwendungen baut und ausführt. Sie setzt auf maschinelles Lernen, um Tests stabil zu halten, wenn sich eine Oberfläche ändert, sodass Teams weniger Zeit mit der Reparatur kaputter Selektoren verbringen. Nicht schlecht für ein Tool für automatisierte Tests, das Sie heute schon nutzen können. Sie erstellen Tests, indem Sie Aktionen im Browser aufzeichnen, und fügen danach JavaScript hinzu, wenn Sie mehr Kontrolle brauchen. Für ein beschäftigtes QA-Team eine solide Wahl.