

Web Bench
Skyvern and Halluminate · Coding · Produktivität
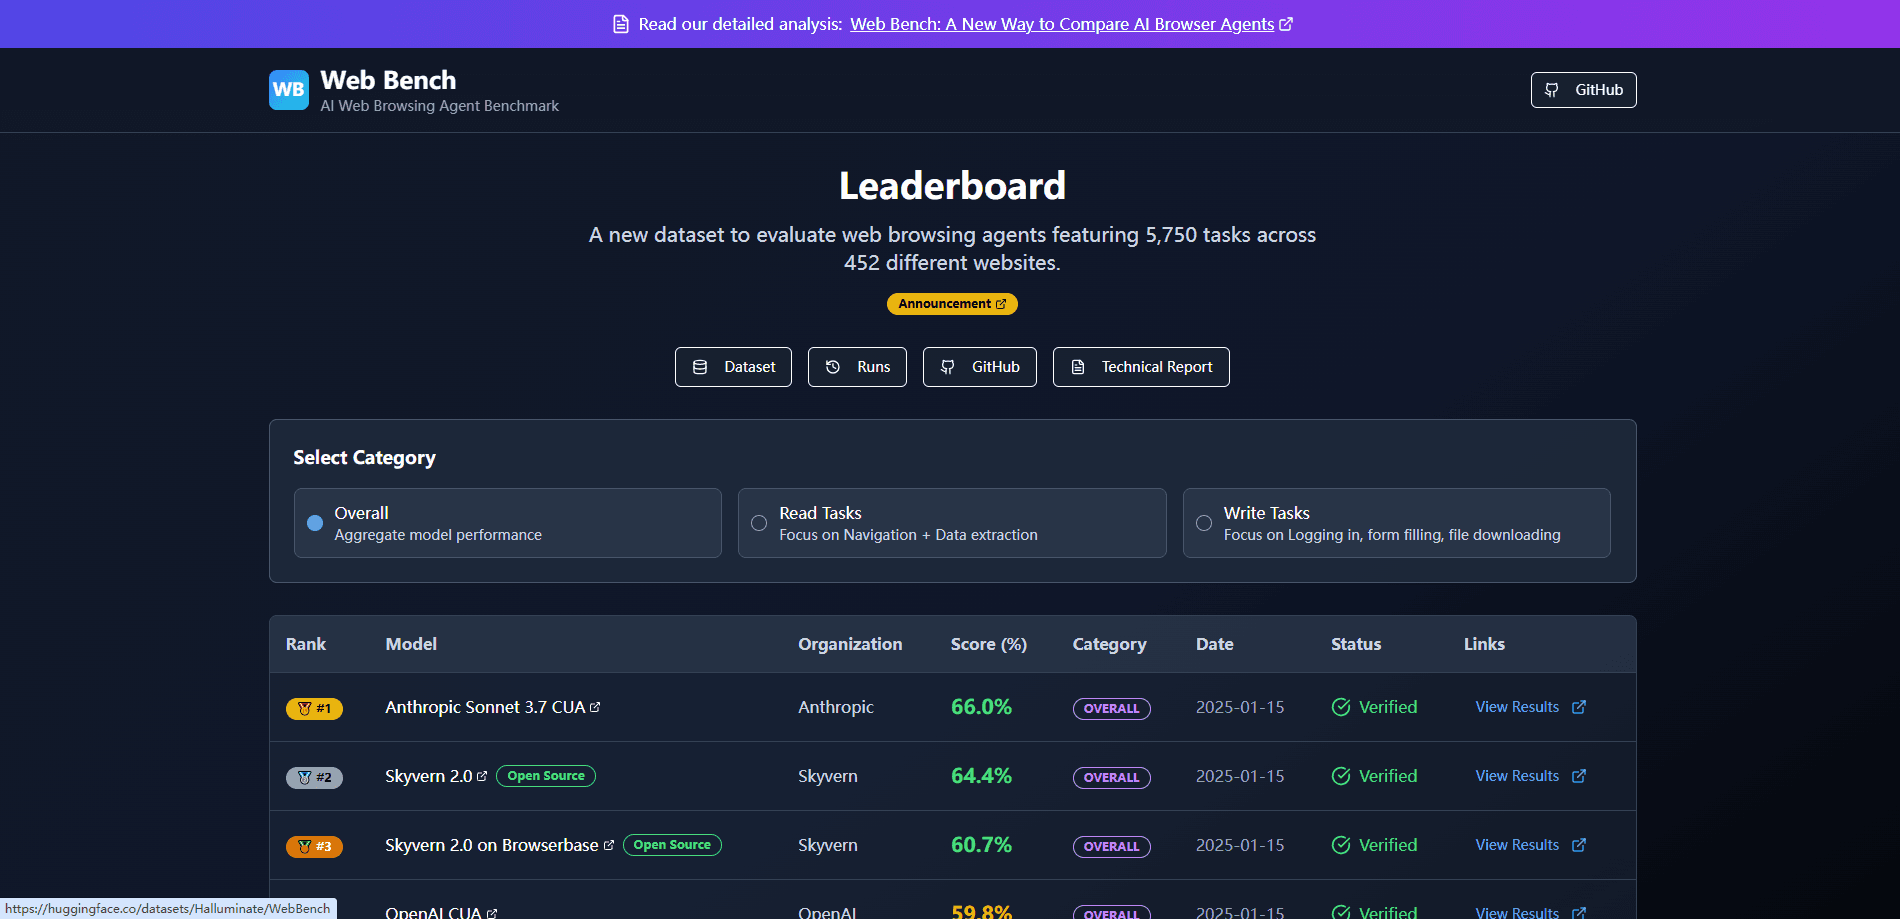
Web Bench ist ein von Skyvern und Halluminate entwickelter Benchmark für KI-Webagenten, der ihre Leistung an 5.750 Aufgaben auf 452 Websites misst.
Über Web Bench
What Is Web Bench
Web Bench ist ein Benchmark, der misst, wie gut KI-Browser-Agenten echte Aufgaben auf live laufenden Websites erledigen. Skyvern und Halluminate haben ihn veröffentlicht, um WebVoyager abzulösen, ein älteres Set mit nur 643 Aufgaben auf 15 Seiten. Heute erledigen Agenten, die einen Browser steuern, Bewerbungen, Rechnungsdownloads und Steuerformulare, deshalb war ein breiteres Messsystem überfällig.
Der Benchmark teilt jede Aufgabe in zwei Gruppen. Leseaufgaben verlangen, dass der Agent eine Seite durchsucht und Informationen herauszieht. Schreibaufgaben verlangen Anmeldung, Formulareingabe, Lösen einer Zwei-Faktor-Prüfung oder einen Dateidownload. Schreibaufgaben kamen in früheren Tests kaum vor, und genau dort scheitern die meisten Agenten. Diese Aufteilung macht ihn zu einer Bewertung von Browser-Agenten, nicht zu einem gewöhnlichen Chatbot-Test.
Die Grenzen sind Umfang und Takt. Bewertet werden nur englischsprachige Seiten aus den globalen Top 1.000, also ein kleiner Teil des Webs, und die Ergebnisse ändern sich erst, wenn das Team das Set neu durchlaufen lässt. Gemessen werden Genauigkeit, Kosten und Tempo, nicht die Frage, ob man einen Agenten allein mit seinen Konten lassen sollte.
Getting Started
- Öffnen Sie die öffentliche Rangliste auf webbench.ai, um Agenten nach Gesamt-, Lese- oder Schreibwert zu vergleichen.
- Sehen Sie sich den offenen Datensatz auf GitHub oder Hugging Face an, um die genauen Aufgaben und die Seitenliste zu prüfen.
- Lesen Sie den technischen Bericht, um zu verstehen, wie jeder Durchlauf bewertet und geprüft wurde.
- Wenn Sie Agenten entwickeln, wenden Sie sich an das Halluminate-Team, um eigene Ergebnisse für die Tabelle einzureichen.
Produktinformationen
Ein kurzer Überblick über Preise, unterstützte Plattformen und die Leistung von Web Bench.
Am besten für
Die Nutzer, Aufgaben und Szenarien, für die dieses Tool am besten passt.
Nutzer
- KI-Entwickler
- Produktteams
- Forschende
Aufgaben
- Eine eigene Version bewerten
- Zwischen Agenten wählen
- Schwachstellen finden
Szenarien
- Ein Team kurz vor dem Einsatz eines Agents für Computernutzung, das Belege braucht, dass er Anmeldungen und Kasse schafft. Agents für Computernutzung, die in einem Browser handeln, bekommen hier das direkteste Signal, und das Ranking von Webagenten ordnet sie nach Aufgabenart.
- Ein Startup, das zwei Anbieter für Browser-Automatisierung abwägt und einen gemeinsamen Maßstab will.
- Eine Autorin oder ein Analyst, der aktuelle Genauigkeitszahlen von Browser-Agenten in einem Bericht zitiert.
Wichtigste Funktionen
Trennung von Lese- und Schreibaufgaben
Web Bench trennt Aufgaben, die Daten holen, von solchen, die sie ändern. Leseaufgaben decken Navigation und Extraktion ab, Schreibaufgaben Anmeldung, Formulareingabe, 2FA und Downloads. Die Trennung zählt, weil ein beim Lesen starker Agent oft an allem scheitert, was eine Seite verändert.
5.750 Aufgaben auf 452 Websites
Das Set führt 5.750 Aufgaben auf 452 Seiten aus, gezogen aus den globalen Top 1.000 nach Traffic. Die Breite ist der Kern: Frühere Benchmarks testeten eine Handvoll Seiten, sodass Agenten Layouts auswendig lernen konnten. Mehr Seiten heißt, die Ergebnisse übertragen sich besser auf die Seiten, die Sie wirklich nutzen.
Offene Aufgabendaten
Rund 2.454 Aufgaben erscheinen als offene Daten auf GitHub und Hugging Face. Jeder kann die Anweisungen prüfen, das Set erneut laufen lassen oder darauf trainieren. Für Teams, die geschlossenen Ranglisten misstrauen, bleibt die Bewertung so nachprüfbar.
Getrennte Agenten- und Infrastrukturfehler
Jeder gescheiterte Durchlauf trägt eine Ursachenmarke. Agentenfehler umfassen schlechte Navigation, erfunden Erfolg, Zeitüberschreitungen und falsche Extraktionen. Infrastrukturfehler umfassen Proxysperren, Captchas und Bot-Erkennung bei der Anmeldung. Die Trennung zeigt, ob Sie das Modell oder den Browser-Stack reparieren müssen.
Kosten- und Tempo-Metriken
Über die Genauigkeit hinaus erfasst Web Bench Dauer und Schrittzahl pro Aufgabe. Die Schritte bestimmen bei fast allen Agenten die Kosten, daher helfen die Zahlen bei der Schätzung eines echten Einsatzes. Sie zeigen auch, ob ein Preis pro Stunde oder pro Schritt passt.
Copilot- und Autonommodus
Die Tabelle bewertet zwei Aufbauten. Ein autonomer Benchmark lässt Agenten ohne Hilfe laufen. Der Copilot-Benchmark lässt sie mit einem Menschen im Ablauf laufen. Der Vergleich beider zeigt, wie stark ein Mensch im Workflow das Ergebnis verändert.
Vor- und Nachteile
Vorteile
- Erfasst echte Reibung wie Anmeldungen, Captchas und Formulare, die frühere Benchmarks ausließen.
- Offener Datensatz und offene Laufprotokolle lassen Teams die Werte prüfen statt ihnen zu vertrauen.
- Die Trennung von Lesen und Schreiben macht die Ergebnisse für konkrete Abläufe nutzbar.
- Enthält Schritt- und Zeitdaten, sodass Sie Kosten neben Genauigkeit abwägen können.
Nachteile
- Deckt nur englischsprachige Seiten ab, ein mehrsprachiger Agent bekommt hier also kein Signal.
- Zieht Stichproben aus den Top 1.000, wodurch Nischen- oder regionale Seiten ungetestet bleiben.
- Die Werte erfrischen sich erst, wenn das Team das Set erneut durchläuft, können also hinter neuen Agenten zurückliegen.
- Die Obergrenze bei Schreibaufgaben ist durchweg niedrig, deshalb meldet er schwache Zahlen selbst für die aktuell besten Agenten.
Häufige Fragen
Er misst, wie genau KI-Browser-Agenten echte Aufgaben auf live laufenden Seiten erledigen, dazu wie viele Schritte und wie viel Zeit jeder Lauf braucht. Jedes Ergebnis mischt Genauigkeit mit Kosten- und Temposignalen.
Ähnliche Inhalte
Entdecke passende Tools, Skills und Artikel zu Web Bench.
Alternativen zu Web Bench

Udon
Udon · Coding · ProduktivitätUdon macht aus einem Apple-Silicon-Mac einen Heimserver, den Sie im Browser steuern, mit Containern, Dateifreigaben und einem optionalen KI-Systemadministrator.

offstage
offstage cloud · Coding · Produktivitätoffstage gibt KI-Agenten und CI-Jobs einen echten Mac: ein frisches macOS-27-Konto auf Apple Silicon, per API gesteuert und sekundengenau abgerechnet.

BotBus
Chengdu Tuyang Tusen Technology Co., Ltd. · Coding · ProduktivitätMit BotBus lassen sich KI-Agenten vom Smartphone steuern, auch wenn der Rechner im Büro steht: Befehle freigeben, Aufgaben starten, Ergebnisse lesen.